共计 27030 个字符,预计需要花费 68 分钟才能阅读完成。
链表
概述
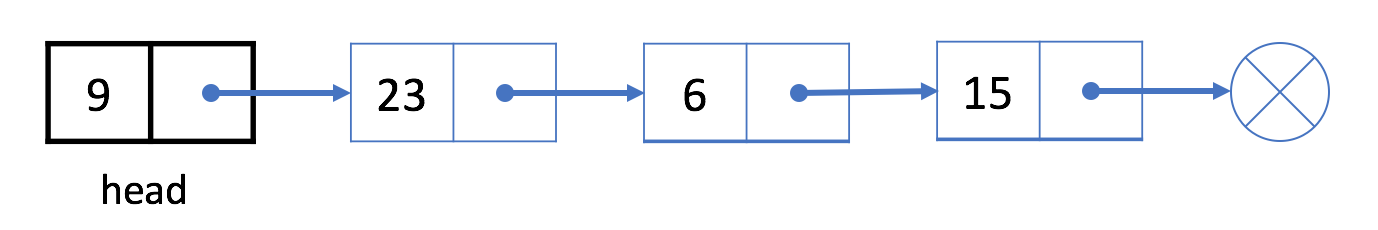
与数组相似,链表也是一种线性数据结构。这里有一个例子:
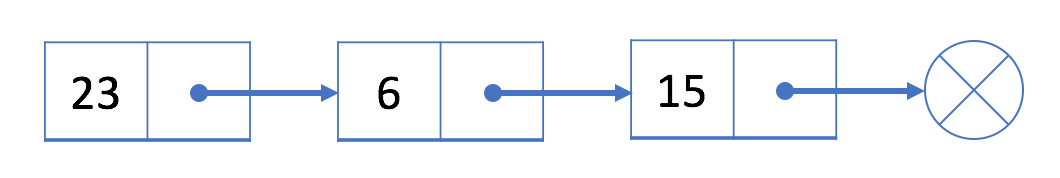
正如你所看到的,链表中的每个元素实际上是一个单独的对象,而所有对象都通过每个元素中的引用字段链接在一起。
链表有两种类型:单链表和双链表。上面给出的例子是一个单链表,这里有一个双链表的例子:
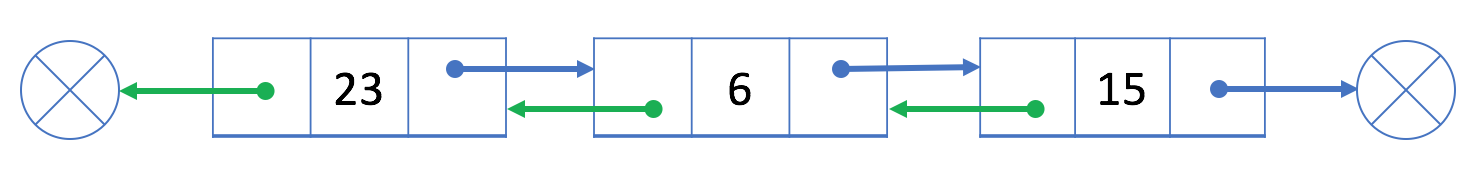
我们将在接下来的章节中介绍更多内容。完成后,你将:
- 了解单链表和双链表的结构
- 在单链表或双链表中实现遍历、插入和删除
- 分析在单链表或双链表中的各种操作的复杂度
- 在链表中使用双指针技巧(快指针慢指针技巧)
- 解决一些经典问题,例如反转链表
- 分析你设计的算法的复杂度
- 积累设计和调试的经验
单链表
正如我们在概览中提到的那样,链表是一种线性数据结构,它通过引用字段将所有分离的元素链接在一起。有两种常用的链表:单链表和双链表。
本章节中,我们将从单链表开始:
- 了解单链表的
结构 - 在单链表中执行
遍历,插入和删除操作 - 分析单链表中不同操作的
时间复杂度
A 简介 – 单链表
单链表中的每个结点不仅包含值,还包含链接到下一个结点的引用字段。通过这种方式,单链表将所有结点按顺序组织起来。
下面是一个单链表的例子:
蓝色箭头显示单个链接列表中的结点是如何组合在一起的。
结点结构
以下是单链表中节点的典型定义:
 // Definition for singly-linked list.
 public class SinglyListNode {
     int val;
     SinglyListNode next;
     SinglyListNode(int x) { val = x; }
 }
在大多数情况下,我们将使用头结点(第一个结点)来表示整个列表。
操作
与数组不同,我们无法在常量时间内访问单链表中的随机元素。 如果我们想要获得第 i 个元素,我们必须从头结点逐个遍历。 我们按 索引 来 访问元素 平均要花费 O(N) 时间,其中 N 是链表的长度。
例如,在上面的示例中,头结点是 23.访问第 3 个节点的唯一方法是使用头结点中的“next”字段到达第 2 个结点(结点 6); 然后使用结点 6 的“next”字段,我们能够访问第 3 个结点。
你可能想知道为什么链表很有用,尽管它在通过索引访问数据时(与数组相比)具有如此糟糕的性能。在接下来的两篇文章中,我们将介绍插入和删除操作,你将了解到链表的好处。
A 添加操作 – 单链表
如果我们想在给定结点 prev 之后添加新值,我们应该:
- 使用给定初始化新节点 cur;
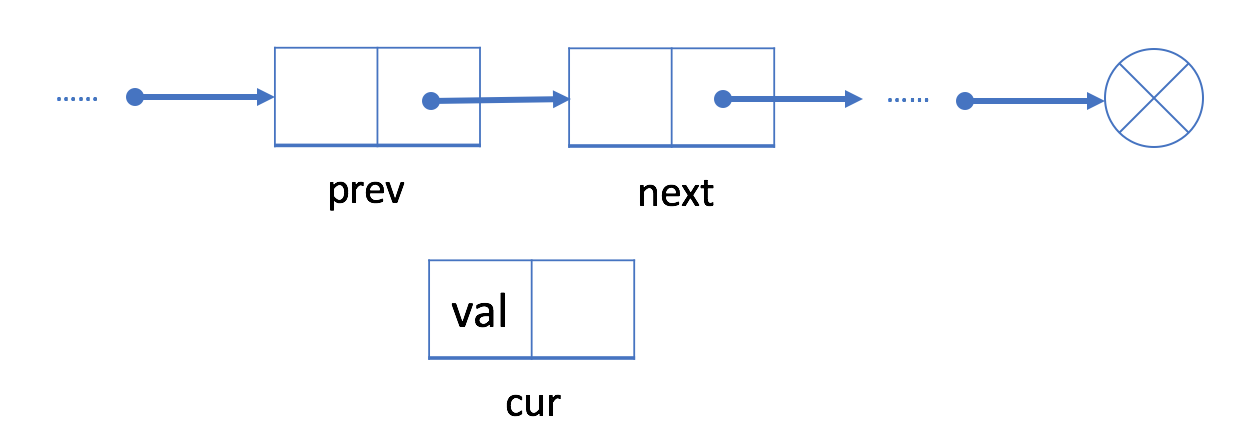
- 将
cur的next字段链接到prev的下一个节点next;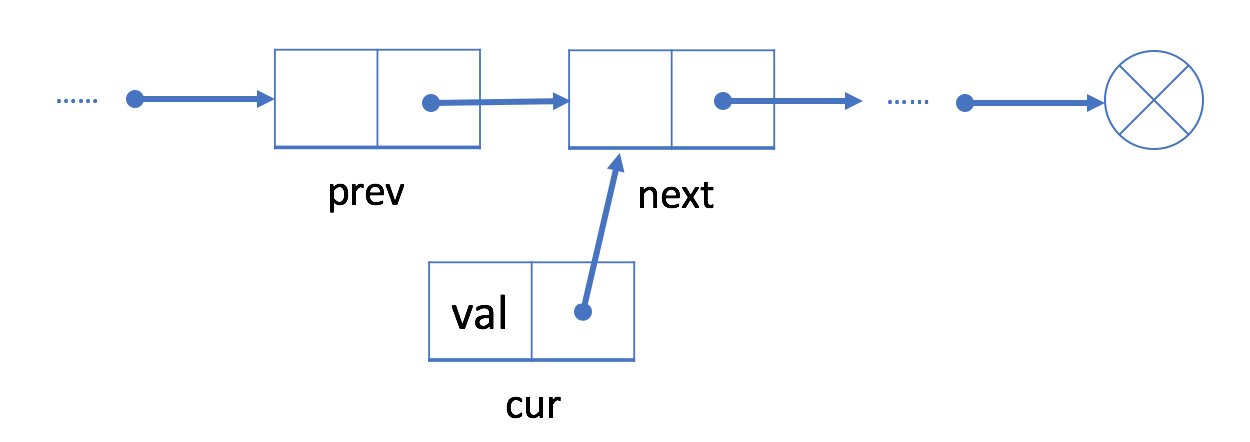
- 将
prev中的next字段链接到cur。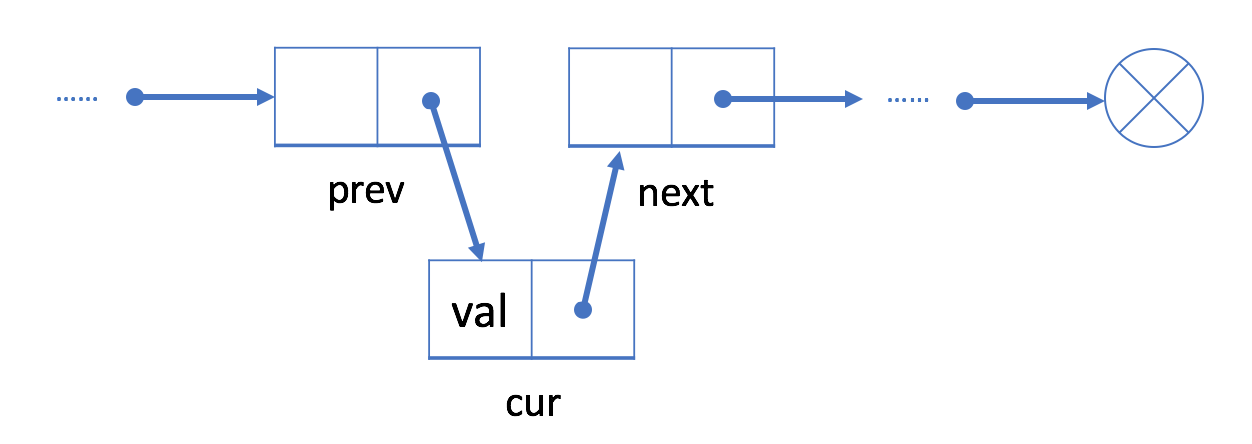
与数组不同,我们不需要将所有元素移动到插入元素之后。因此,您可以在 O(1) 时间复杂度中将新结点插入到链表中,这非常高效。
示例
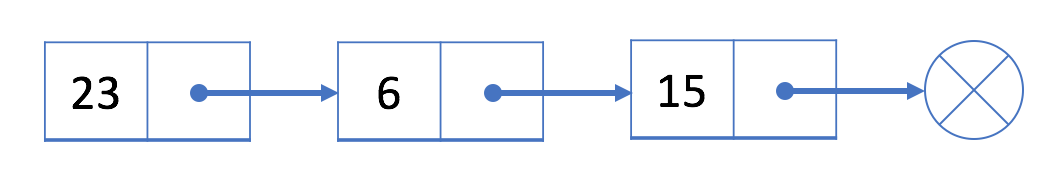
让我们在第二个结点 6 之后插入一个新的值 9 。
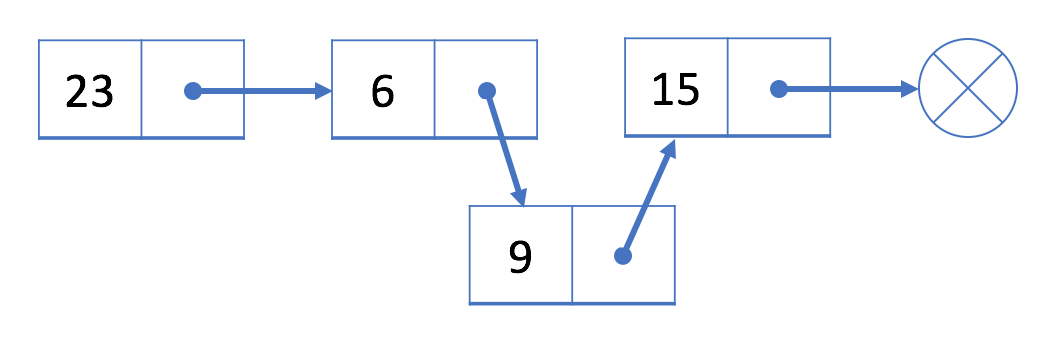
我们将首先初始化一个值为 9 的新结点。然后将结点 9 链接到结点 15 。最后,将结点 6 链接到结点 9 。
插入之后,我们的链表将如下所示:
在开头添加结点
众所周知,我们使用头结点来代表整个列表。
因此,在列表开头添加新节点时更新头结点 head 至关重要。
- 初始化一个新节点
cur; - 将新结点链接到我们的原始头结点
head。 - 将
cur指定为head。
例如,让我们在列表的开头添加一个新结点 9。
- 我们初始化一个新结点 9 并将其链接到当前头结点 23。
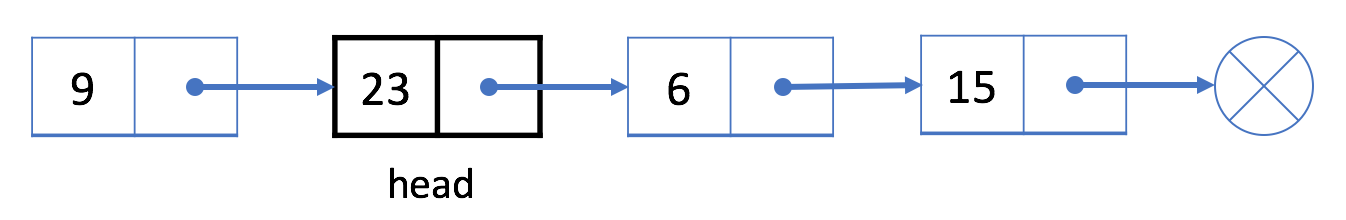
- 指定结点 9 为新的头结点。
如何在列表的末尾添加新的结点?我们还能使用类似的策略吗?
A 删除操作 – 单链表
如果我们想从单链表中删除现有结点 cur,可以分两步完成:
- 找到 cur 的上一个结点
prev及其下一个节点next;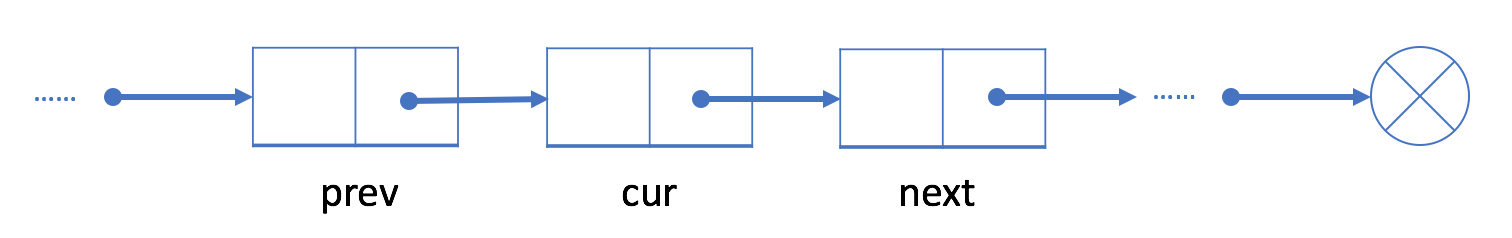
- 接下来链接
prev到 cur 的下一个节点next。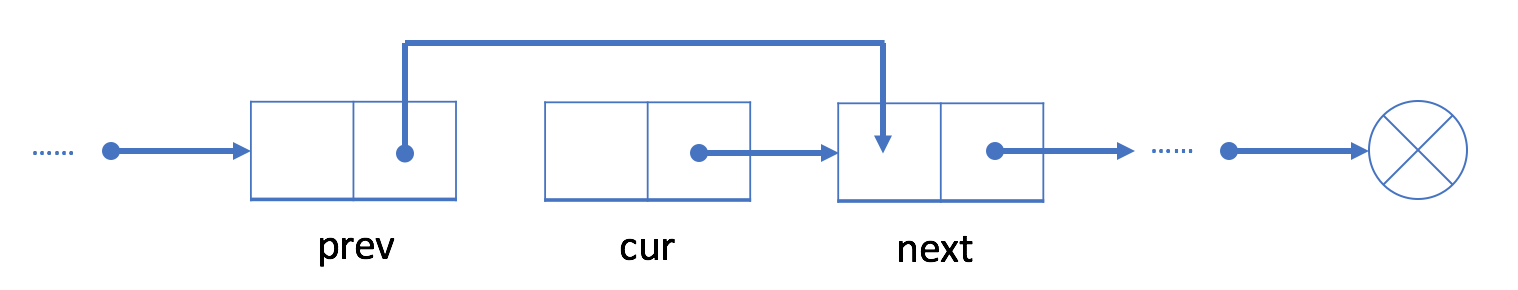
在我们的第一步中,我们需要找出prev 和 next。使用 cur 的参考字段很容易找出 next,但是,我们必须从头结点遍历链表,以找出 prev,它的平均时间是 O(N),其中 N 是链表的长度。因此,删除结点的时间复杂度将是 O(N)。
空间复杂度为 O(1),因为我们只需要常量空间来存储指针。
示例
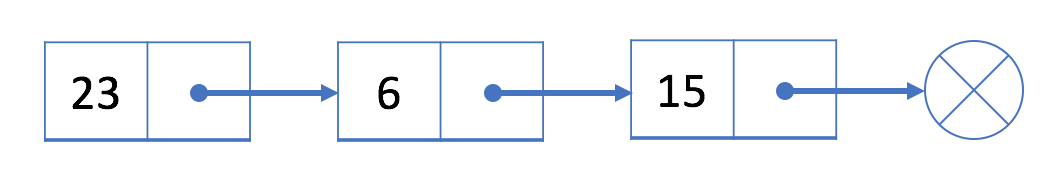
让我们尝试把结点 6 从上面的单链表中删除。
- 从头遍历链表,直到我们找到前一个结点
prev,即结点 23 - 将
prev(结点 23)与next(结点 15)链接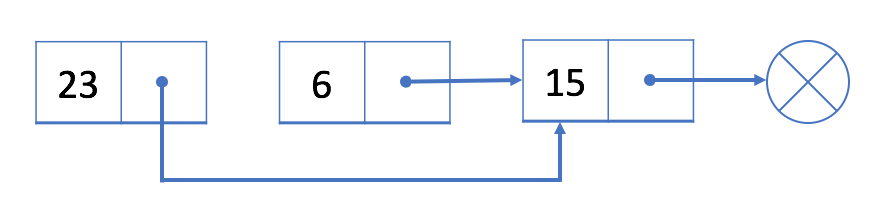
结点 6 现在不在我们的单链表中。
删除第一个结点
如果我们想删除第一个结点,策略会有所不同。
正如之前所提到的,我们使用头结点 head 来表示链表。我们的头是下面示例的黑色结点 23。
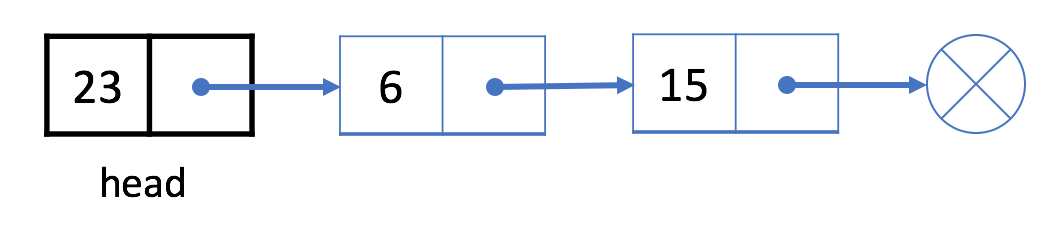
如果想要删除第一个结点,我们可以简单地将下一个结点分配给 head。也就是说,删除之后我们的头将会是结点 6.
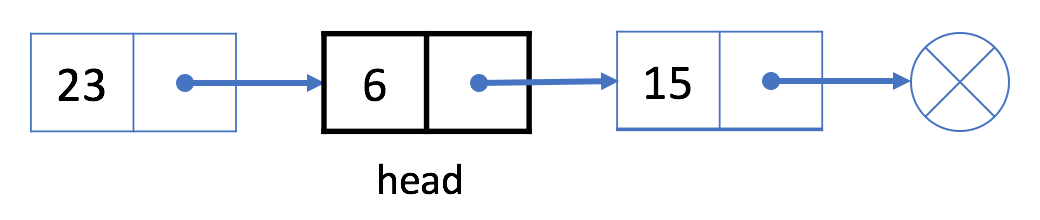
链表从头结点开始,因此结点 23 不再在我们的链表中。
删除最后一个结点呢?我们还能使用类似的策略吗?
LC 设计链表
设计链表的实现。您可以选择使用单链表或双链表。单链表中的节点应该具有两个属性:val 和 next。val 是当前节点的值,next 是指向下一个节点的指针/引用。如果要使用双向链表,则还需要一个属性 prev 以指示链表中的上一个节点。假设链表中的所有节点都是 0-index 的。
在链表类中实现这些功能:
- get(index):获取链表中第
index个节点的值。如果索引无效,则返回-1。 - addAtHead(val):在链表的第一个元素之前添加一个值为
val的节点。插入后,新节点将成为链表的第一个节点。 - addAtTail(val):将值为
val的节点追加到链表的最后一个元素。 - addAtIndex(index,val):在链表中的第
index个节点之前添加值为val的节点。如果index等于链表的长度,则该节点将附加到链表的末尾。如果index大于链表长度,则不会插入节点。如果index小于0,则在头部插入节点。 - deleteAtIndex(index):如果索引
index有效,则删除链表中的第index个节点。
示例:
 MyLinkedList linkedList = new MyLinkedList();
 linkedList.addAtHead(1);
 linkedList.addAtTail(3);
 linkedList.addAtIndex(1,2);   //链表变为1-> 2-> 3
 linkedList.get(1);            //返回2
 linkedList.deleteAtIndex(1);  //现在链表是1-> 3
linkedList.get(1); //返回3提示:
0 <= index, val <= 1000- 请不要使用内置的 LinkedList 库。
get,addAtHead,addAtTail,addAtIndex和deleteAtIndex的操作次数不超过2000。
题解
方法一:单向链表
查看单向链表设计思路
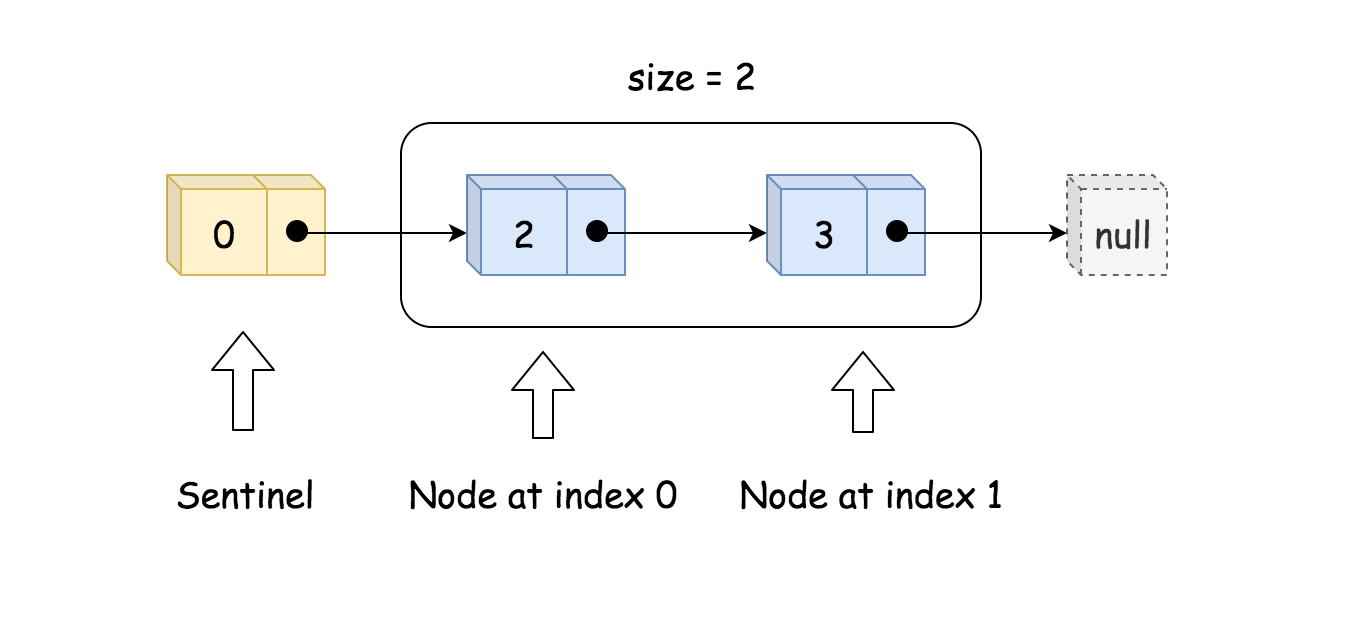
实现单向链表,即每个节点仅存储本身的值和后继节点。除此之外,我们还需要一个哨兵(sentinel)节点作为头节点,和一个 size 参数保存有效节点数。如下图所示.
初始化时,只需创建头节点 head 和 size 即可。
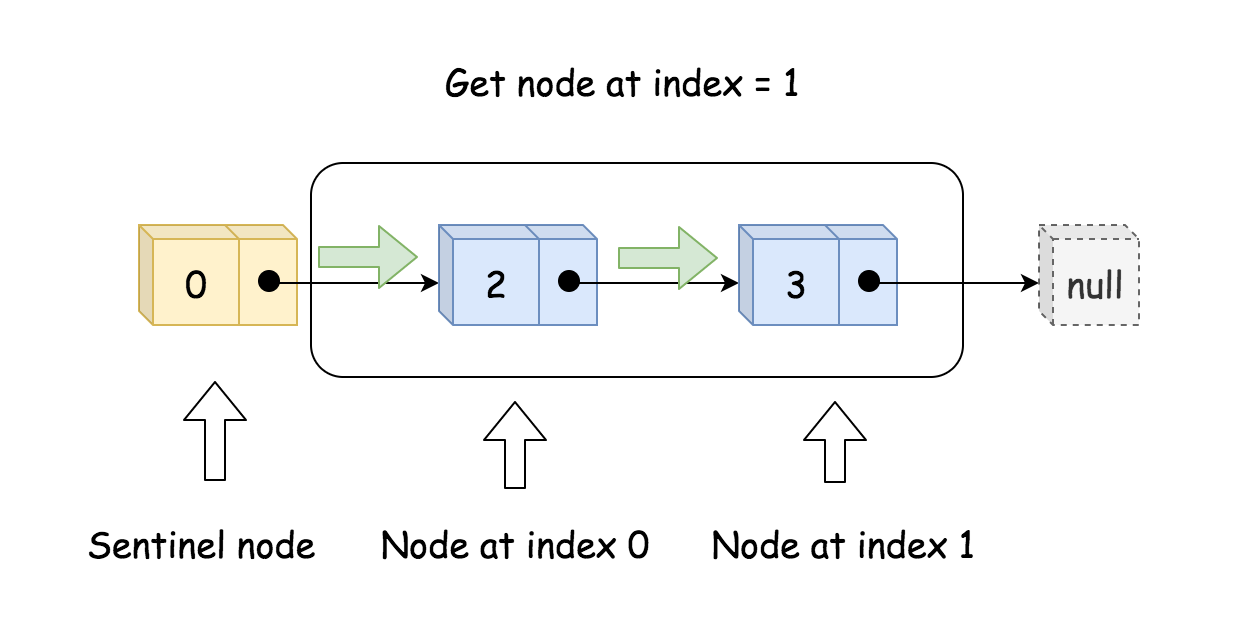
实现 get(index) 时,先判断有效性,再通过循环来找到对应的节点的值。如下图所示。
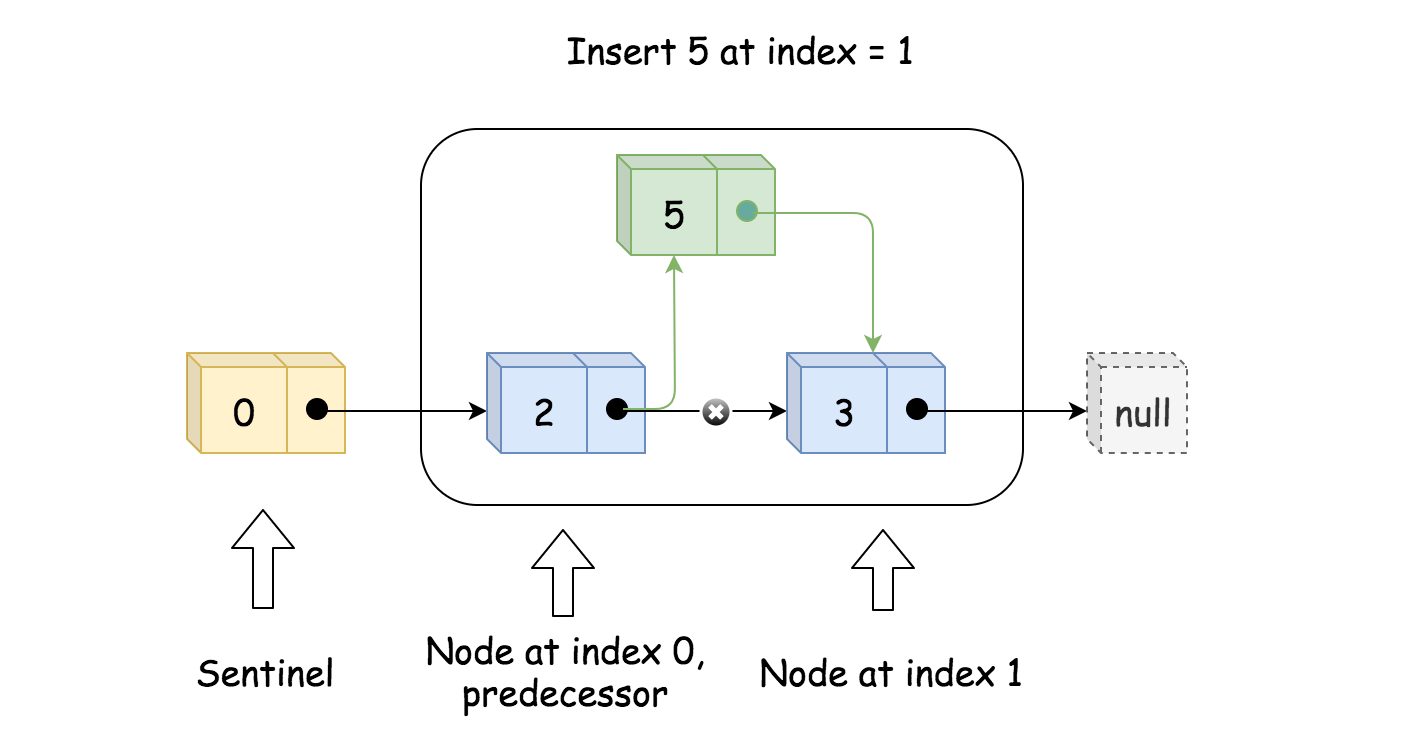
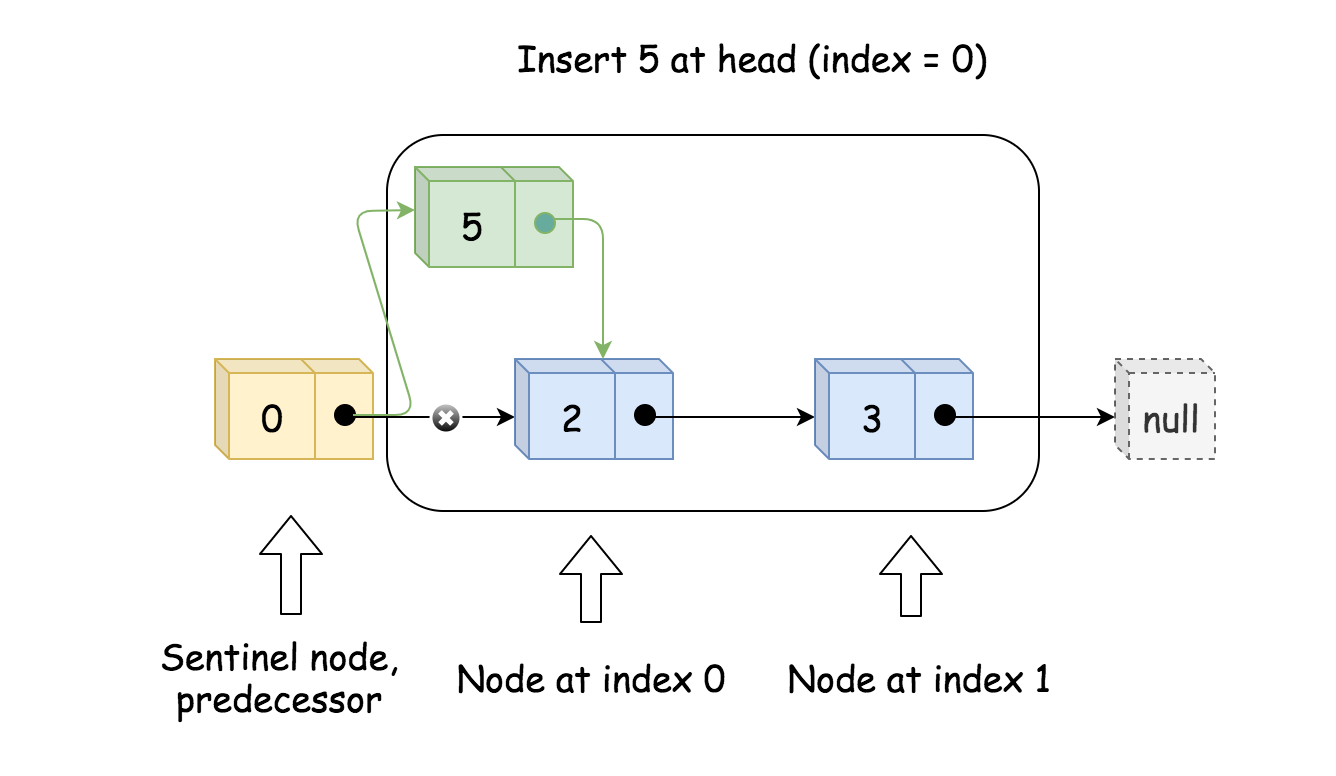
实现 addAtIndex(index, val) 时,如果 index 是有效值,则需要找到原来下标为 index 的节点的前驱节点 pred,并创建新节点 to_add,将 to_add 的后继节点设为 pred 的后继节点,将 pred 的后继节点更新为 to_add,这样就将 to_add 插入到了链表中。最后需要更新size。这样的操作对于 index=0 也成立,如以下两张图所示。
实现 addAtHead(val) 和 addAtTail(val) 时,可以借助 addAtIndex(index, val) 来实现。
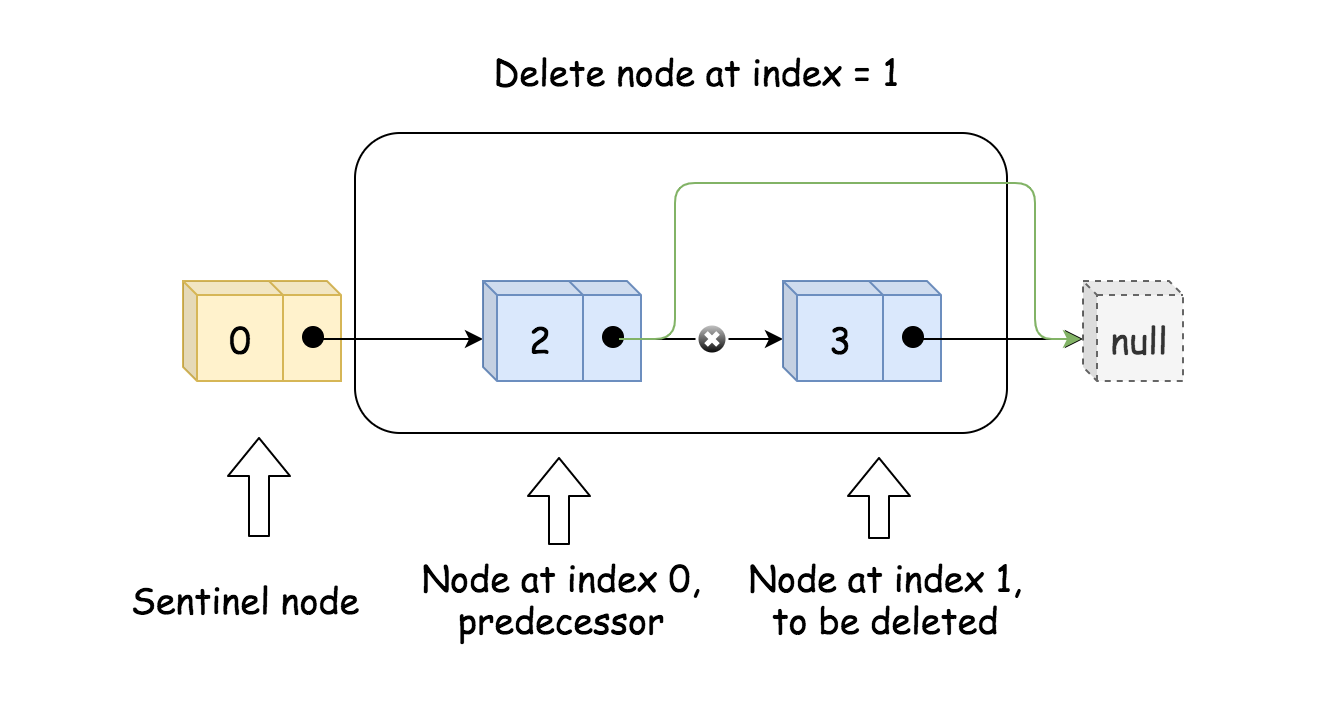
实现 deleteAtIndex(index),先判断参数有效性。然后找到下标为 index 的节点的前驱节点 pred,通过将 pred 的后继节点更新为 pred 的后继节点的后继节点,来达到删除节点的效果。同时也要更新 size。如下图所示。
代码:
var MyLinkedList = function() {
this.size = 0;
this.head = new ListNode(0);
};
MyLinkedList.prototype.get = function(index) {
if (index < 0 || index >= this.size) {
return -1;
}
let cur = this.head;
for (let i = 0; i <= index; i++) {
cur = cur.next;
}
return cur.val;
};
MyLinkedList.prototype.addAtHead = function(val) {
this.addAtIndex(0, val);
};
MyLinkedList.prototype.addAtTail = function(val) {
this.addAtIndex(this.size, val);
};
MyLinkedList.prototype.addAtIndex = function(index, val) {
if (index > this.size) {
return;
}
index = Math.max(0, index);
this.size++;
let pred = this.head;
for (let i = 0; i < index; i++) {
pred = pred.next;
}
let toAdd = new ListNode(val);
toAdd.next = pred.next;
pred.next = toAdd;
};
MyLinkedList.prototype.deleteAtIndex = function(index) {
if (index < 0 || index >= this.size) {
return;
}
this.size--;
let pred = this.head;
for (let i = 0; i < index; i++) {
pred = pred.next;
}
pred.next = pred.next.next;
};
function ListNode(val, next) {
this.val = (val===undefined ? 0 : val)
this.next = (next===undefined ? null : next)
}复杂度分析
- 时间复杂度:初始化消耗 O(1),get 消耗 O(index),addAtHead 消耗 O(1),addAtTail 消耗 O(n),其中 n 为链表当前长度,即 addAtHead,addAtTail 和 addAtInder 已调用次数之和,addAtIndex 消耗 O(index)。
- 空间复杂度:所有函数的单次调用空间复杂度均为 O(1),总体空间复杂度为 O(n),其中 n 为 addAtHead,addAtTail 和 addAtIndex调用次数之和。
方法二:双向链表
查看双向链表设计思路
实现双向链表,即每个节点要存储本身的值,后继节点和前驱节点。除此之外,需要一个哨兵节点作为头节点 head 和一个哨兵节点作为尾节点 tail。仍需要一个 size 参数保存有效节点数。如下图所示。
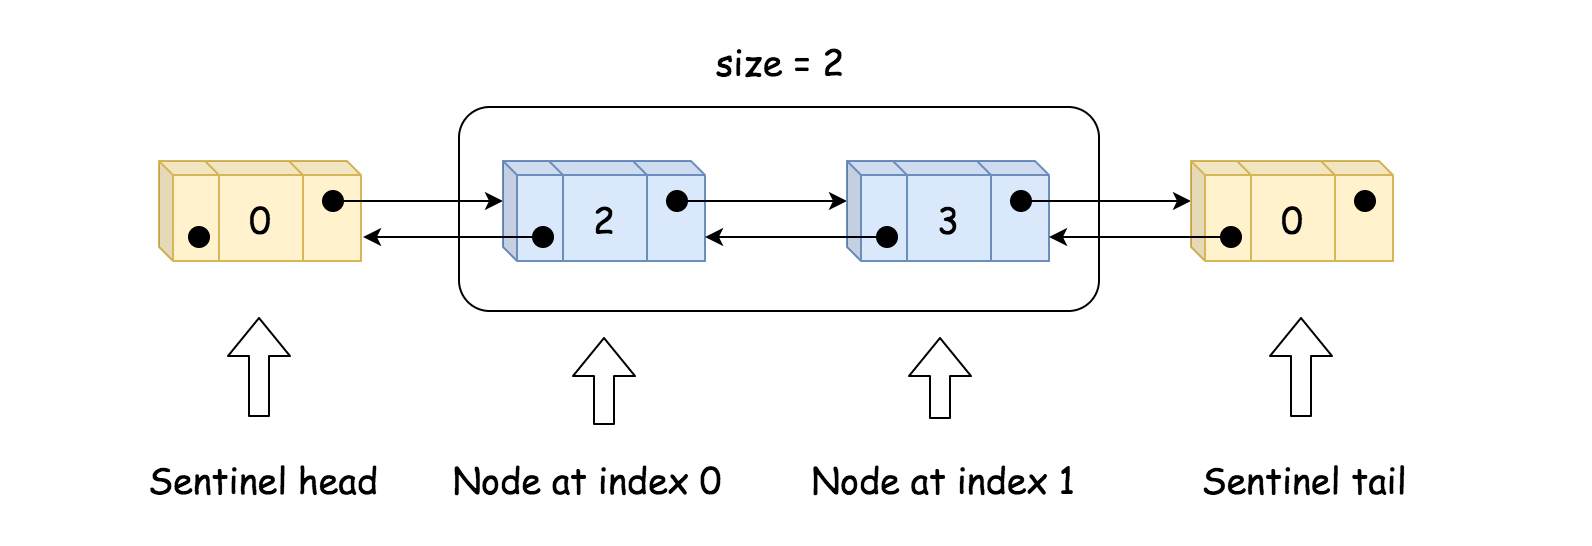
初始化时,只需创建头节点 head 和 size 即可。
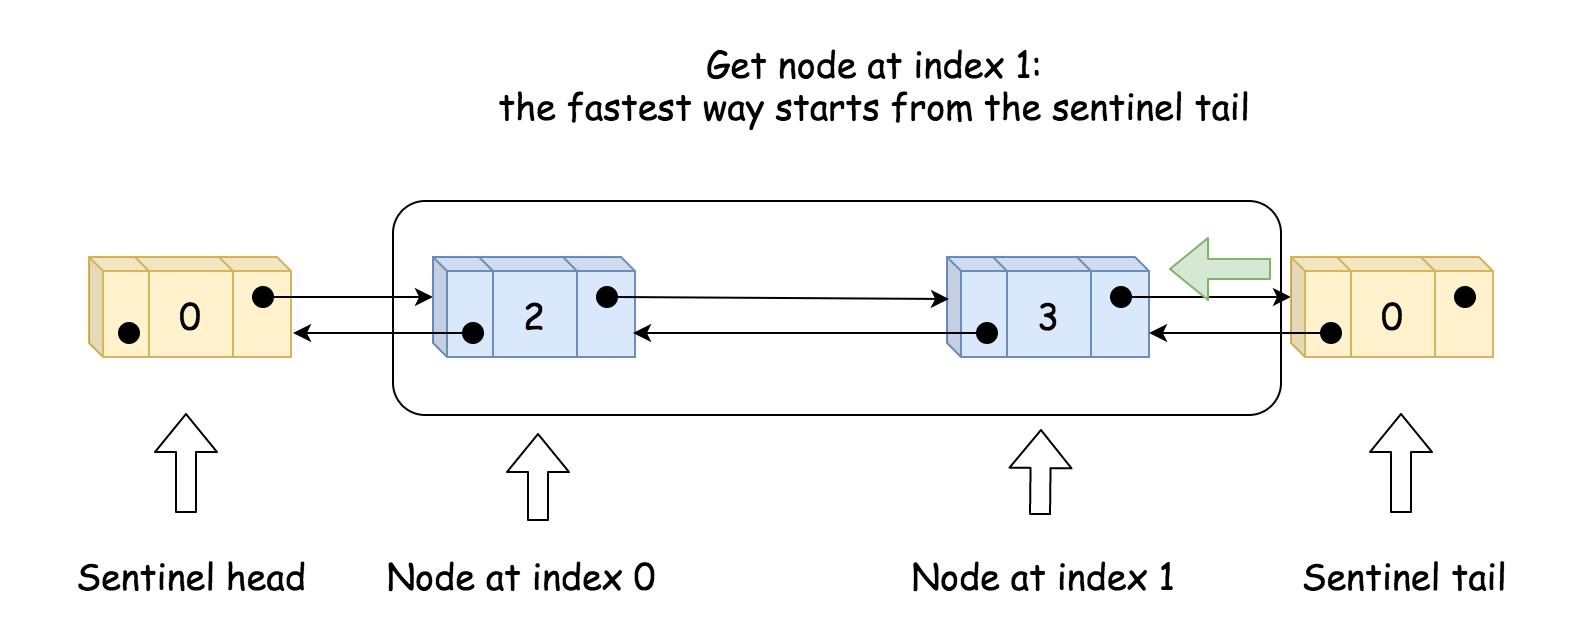
实现 get(index) 时,先判断有效性,然后再比较从 head 还是 tail 来遍历会比较快找到目标,然后进行遍历。如下图所示。
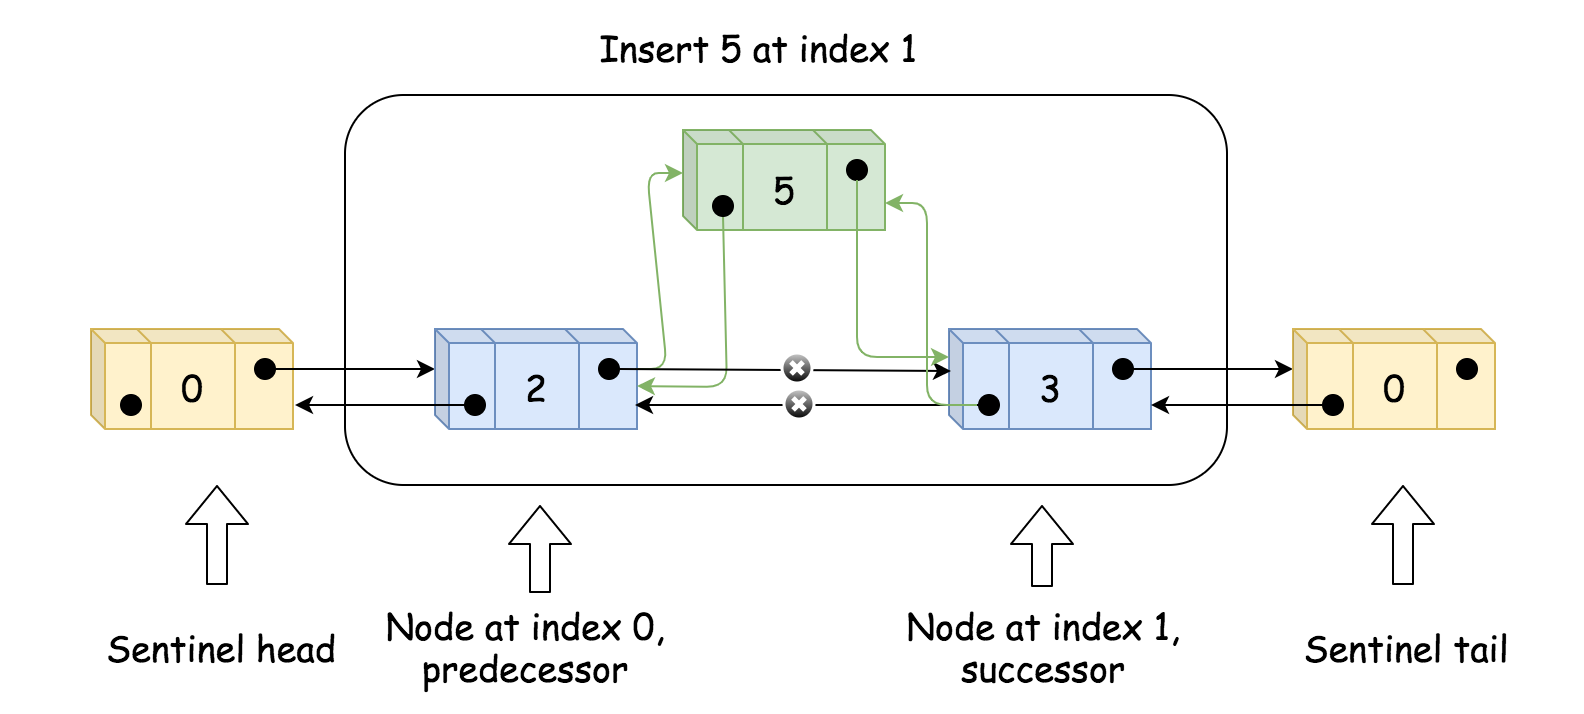
实现 addAtIndex(index, val) 时,如果 index 是有效值,则需要找到原来下标为 index 的节点 succ 和前驱节点 pred,并创建新节点 to_add,再通过各自 prev 和 next 变量的更新来增加 to_add。最后需要更新 size。如下图所示。
实现 addAtHead(val) 和 addAtTail(val) 时,可以借助 addAtIndex(index, val) 来实现。
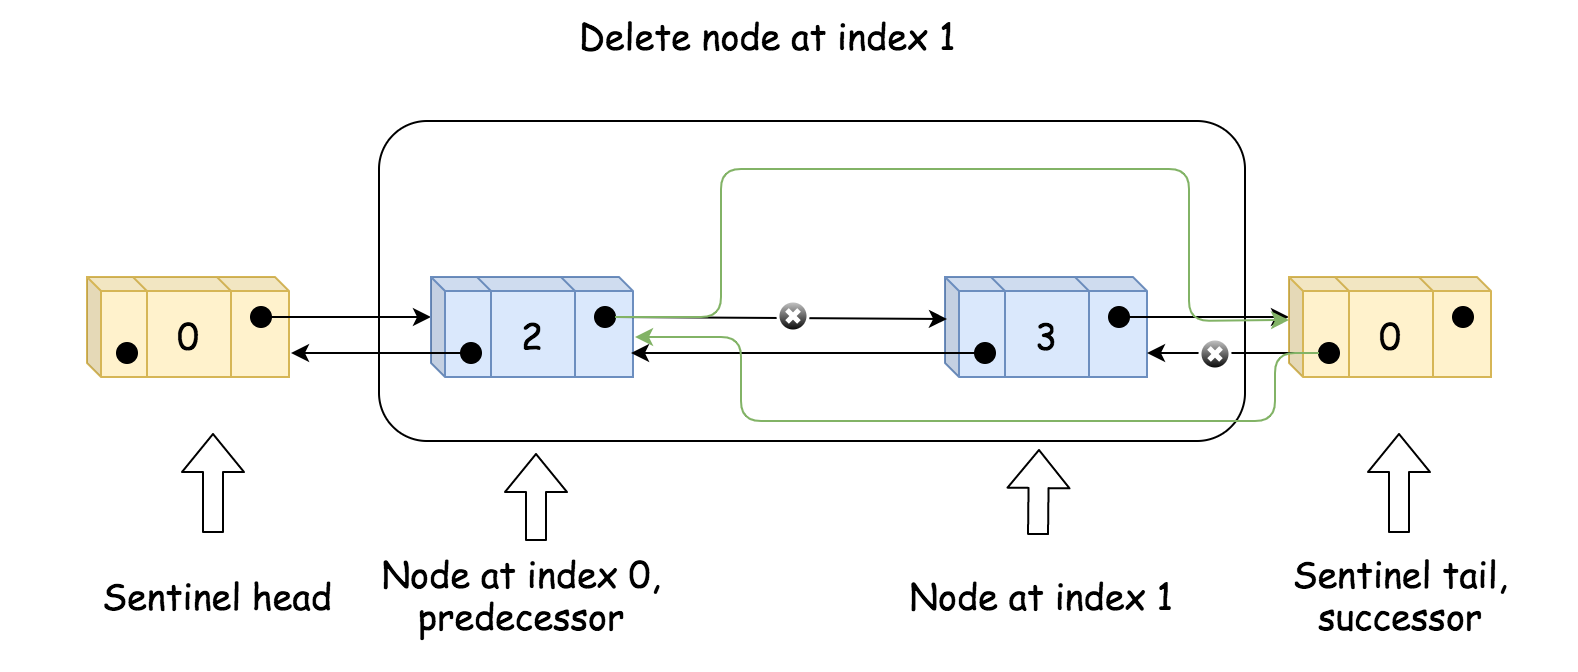
实现 deleteAtIndex(index),先判断参数有效性。然后找到下标为 index 的节点的前驱节点 pred 和后继节点 succ,再通过各自 prev 和 next 变量的更新来删除节点,来达到删除节点的效果。同时也要更新 size。如下图所示。
代码:
var MyLinkedList = function() {
this.size = 0;
this.head = new ListNode(0);
this.tail = new ListNode(0);
this.head.next = this.tail;
this.tail.prev = this.head;
};
MyLinkedList.prototype.get = function(index) {
if (index < 0 || index >= this.size) {
return -1;
}
let curr;
if (index + 1 < this.size - index) {
curr = this.head;
for (let i = 0; i <= index; i++) {
curr = curr.next;
}
} else {
curr = this.tail;
for (let i = 0; i < this.size - index; i++) {
curr = curr.prev;
}
}
return curr.val;
};
MyLinkedList.prototype.addAtHead = function(val) {
this.addAtIndex(0, val);
};
MyLinkedList.prototype.addAtTail = function(val) {
this.addAtIndex(this.size, val);
};
MyLinkedList.prototype.addAtIndex = function(index, val) {
if (index > this.size) {
return;
}
index = Math.max(0, index);
let pred, succ;
if (index < this.size - index) {
pred = this.head;
for (let i = 0; i < index; i++) {
pred = pred.next;
}
succ = pred.next;
} else {
succ = this.tail;
for (let i = 0; i < this.size - index; i++) {
succ = succ.prev;
}
pred = succ.prev;
}
this.size++;
const toAdd = new ListNode(val);
toAdd.prev = pred;
toAdd.next = succ;
pred.next = toAdd;
succ.prev = toAdd;
};
MyLinkedList.prototype.deleteAtIndex = function(index) {
if (index < 0 || index >= this.size) {
return;
}
let pred, succ;
if (index < this.size - index) {
pred = this.head;
for (let i = 0; i < index; i++) {
pred = pred.next;
}
succ = pred.next.next;
} else {
succ = this.tail;
for (let i = 0; i < this.size - index - 1; i++) {
succ = succ.prev;
}
pred = succ.prev.prev;
}
this.size--;
pred.next = succ;
succ.prev = pred;
};
function ListNode(val, next, prev) {
this.val = (val===undefined ? 0 : val);
this.next = (next===undefined ? null : next);
this.prev = (prev===undefined ? null : prev);
}复杂度分析
- 时间复杂度:初始化消耗 O(1),get 消耗 O(index),addAtHead 消耗 O(1),addAtTail 消耗O(1),addAtIndex 消耗 O(index)。
- 空间复杂度:所有函数单次调用的空间复杂度均为 O(1),总体空间复杂度为 O(n),其中 n 为 addAtHead,addAtTail 和 addAtIndex 调用次数之和。
双指针技巧
我们之前提到了两种使用双指针技巧的情景:
- 两个指针
从不同位置触发:一个从始端开始,另一个从末端开始; - 两个指针
以不同的速度移动:一个指针快一些,另一个指针慢一些。
对于单链表,因为我们只能在一个方向上遍历链表,所以第一种情景可能无法工作。然而,第二种情景,也被称为慢指针和快指针技巧,是非常有用的。
本章节中,我们将重点讨论链表中的慢指针和快指针问题,并告诉你如何解决这类问题。
A 链表中的双指针
让我们从一个经典问题开始:
给定一个链表,判断链表中是否有环。
你可能已经使用哈希表提出了解决方案。但是,使用双指针技巧有一个更有效的解决方案。在阅读接下来的内容之前,试着自己仔细考虑一下。
想象一下,有两个速度不同的跑步者。如果他们在直路上行驶,快跑者将首先到达目的地。但是,如果它们在圆形跑道上跑步,那么快跑者如果继续跑步就会追上慢跑者。
这正是我们在链表中使用两个速度不同的指针时会遇到的情况:
如果没有环,快指针将停在链表的末尾如果有环,快指针最终将与慢指针相遇
所以剩下的问题是:
这两个指针的适当速度应该是多少?
一个安全的选择是每次移动慢指针一步,而移动快指针两步。每一次迭代,快速指针将额外移动一步。如果环的长度为 M,经过 M 次迭代后,快指针肯定会多绕环一周,并赶上慢指针。
LC 环形链表
给一个链表的头结点 head,判断链表中是否有环。
如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。则链表中存在环。 为了表示给定链表中的环,评测系统内部使用整数 pos 来表示链表尾连接到链表中的位置(索引从 0 开始)。注意:pos 不作为参数进行传递 。仅仅是为了标识链表的实际情况。
如果链表中存在环 ,则返回 true 。 否则,返回 false 。
示例 1:
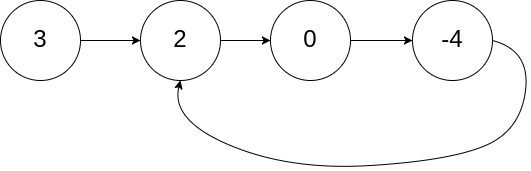
 输入:head = [3,2,0,-4], pos = 1
 输出:true
 解释:链表中有一个环,其尾部连接到第二个节点。
示例 2:
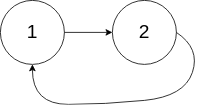
 输入:head = [1,2], pos = 0
 输出:true
 解释:链表中有一个环,其尾部连接到第一个节点。
示例 3:

 输入:head = [1], pos = -1
 输出:false
解释:链表中没有环。提示:
- 链表中节点的数目范围是 [0, 104]
- -105 <= Node.val <= 105
pos为-1或者链表中的一个 有效索引 。
进阶:你能用 O(1)(即,常量)内存解决此问题吗?
题解
/**
* Definition for singly-linked list.
* function ListNode(val) {
* this.val = val;
* this.next = null;
* }
*/
/**
* @param {ListNode} head
* @return {boolean}
*/
var hasCycle = function(head) {
if(head === null) return false
let slow = head, fast = head.next
while(fast && fast.next) {
if (slow.next === fast.next.next) return true
slow = slow.next
fast = fast.next.next
}
return false
};LC 环形链表 Ⅱ
给定一个链表的头节点 head ,返回链表开始入环的第一个节点。 如果链表无环,则返回 null。
如果链表中有某个节点,可以通过连续跟踪 next 指针再次到达,则链表中存在环。为了表示给定链表中的环,评测系统内部使用整数 pos 来表示链表尾连接到链表中的位置(索引从 0 开始)。如果 pos 是 -1,则在该链表中没有环。注意:pos 不作为参数进行传递,仅仅是为了标识链表的实际情况。
不允许修改 链表。
示例 1:
 输入:head = [3,2,0,-4], pos = 1
 输出:返回索引为 1 的链表节点
 解释:链表中有一个环,其尾部连接到第二个节点。
示例 2:
 输入:head = [1,2], pos = 0
 输出:返回索引为 0 的链表节点
 解释:链表中有一个环,其尾部连接到第一个节点。
示例 3:
 输入:head = [1], pos = -1
 输出:返回 null
解释:链表中没有环。提示:
- 链表中节点的数目范围在范围 [0, 104] 内
- -105 <= Node.val <= 105
pos的值为-1或者链表中的一个有效索引
进阶:你是否可以使用 O(1) 空间解决此题?
题解
方法一:哈希表
遍历链表中的每个节点,并记录下来,若遇到了前面遍历过的结点,就可以判定链表中存在环。
/**
* Definition for singly-linked list.
* function ListNode(val) {
* this.val = val;
* this.next = null;
* }
*/
/**
* @param {ListNode} head
* @return {ListNode}
*/
var detectCycle = function(head) {
const visited = new Set();
while (head !== null) {
if (visited.has(head)) {
return head;
}
visited.add(head);
head = head.next;
}
return null;
};复杂度分析
- 时间复杂度:O(N),其中 N 为链表中节点的数目。我们需要访问链表中的每一个节点。
- 空间复杂度:O(N),其中 N 为链表中节点的数目。我们需要将链表中的每个节点都保存在哈希包中。
方法二:快慢指针
查看思路
我们使用两个指针,fast 与 slow。它们起始都位于链表的头部。随后,slow 指针每次向后移动一个位置,而 fast 指针向后移动两个位置。如果链表中存在环,则 fast 指针最终将再次与 slow 指针在环中相遇。
如下图所示,设链表中环外部分的长度为 a。slow 指针进入环后,又走了 b 的距离与 fast 相遇。此时,\textit{fast}fast 指针已经走完了环的 n 圈,因此它走过的总距离为 a+n(b+c)+b=a+(n+1)b+nc。
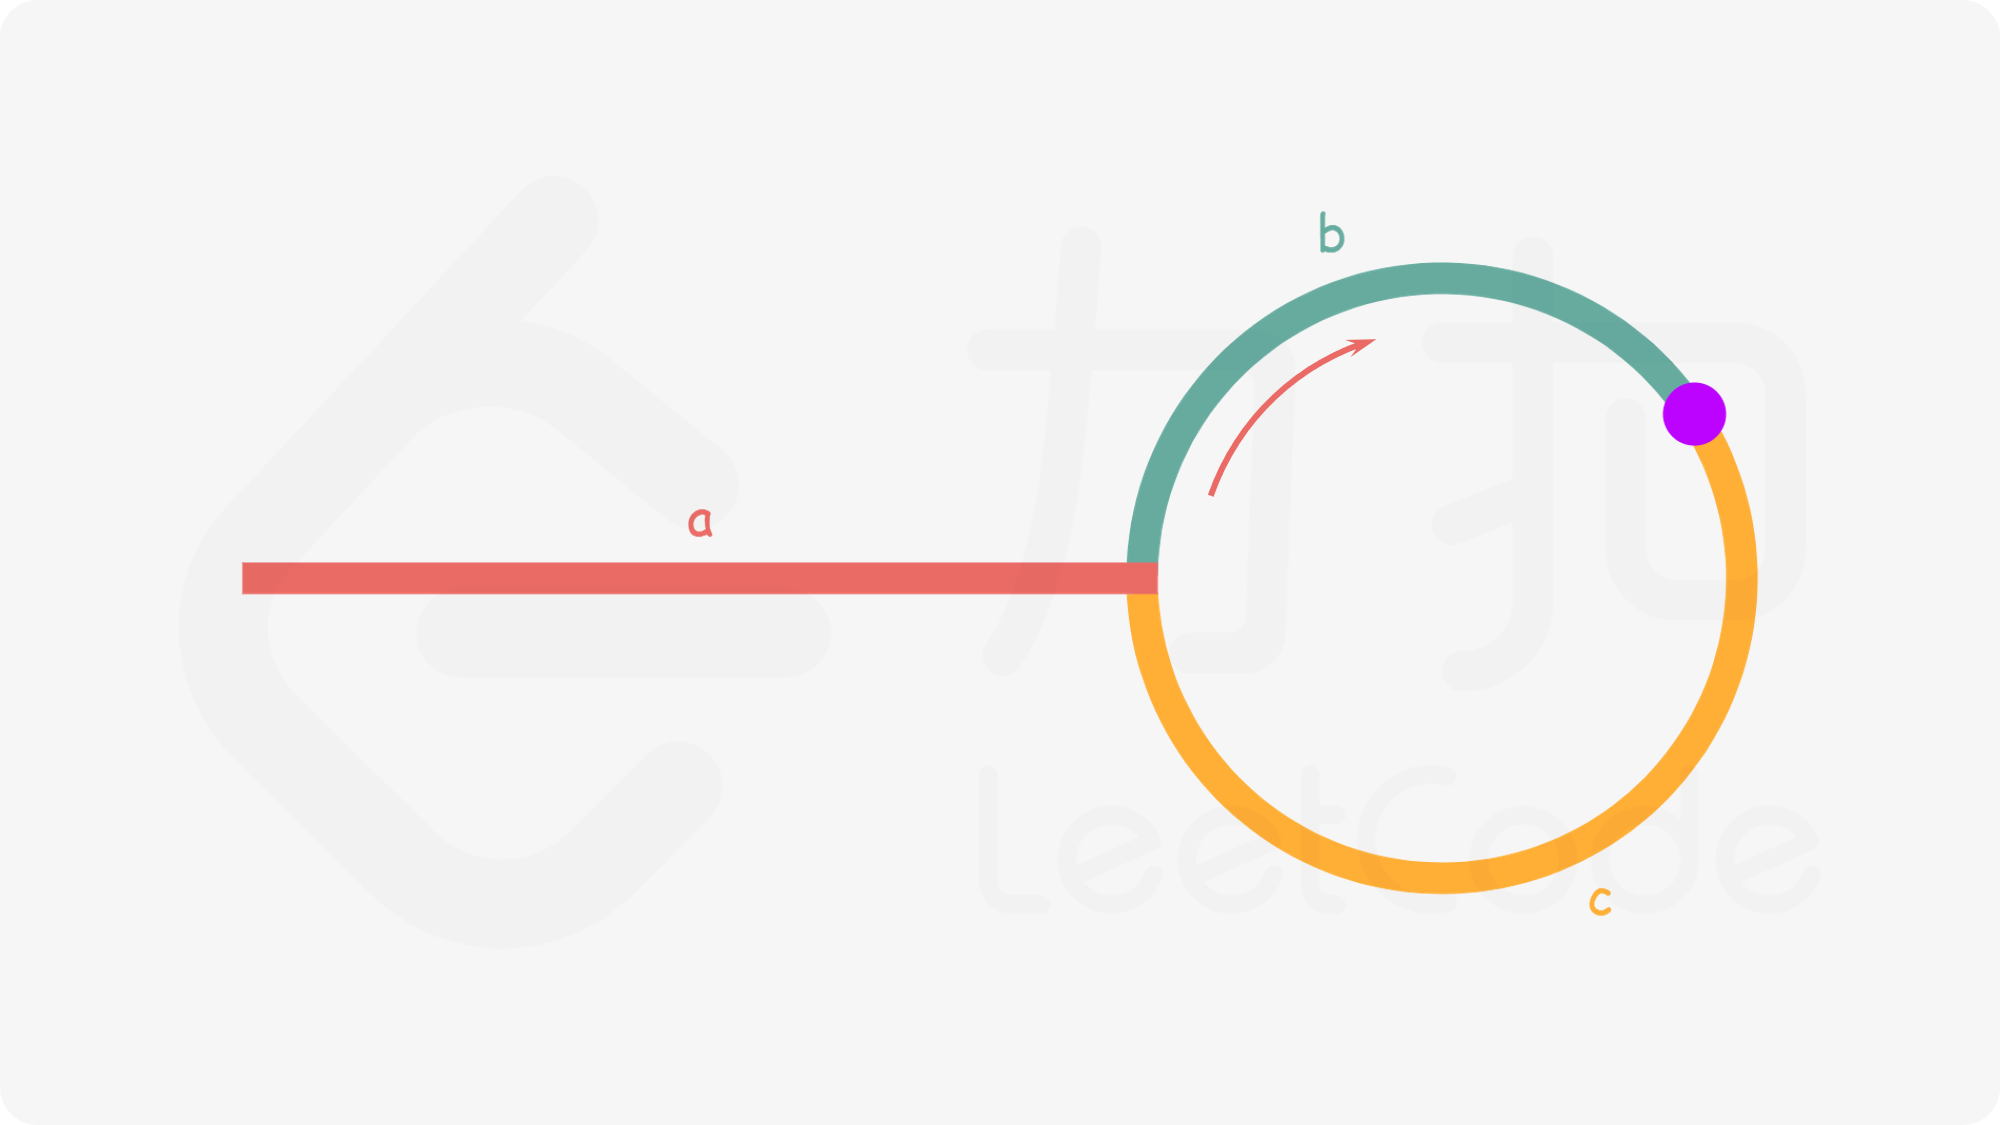
根据题意,任意时刻,fast 指针走过的距离都为 slow 指针的 2 倍。因此,我们有:
a + (n + 1)b + nc = 2(a + b) → a = c + (n – 1)(b + c)
有了 a = c + (n – 1)(b + c) 的等量关系,我们会发现:从相遇点到入环点的距离加上 n−1 圈的环长,恰好等于从链表头部到入环点的距离。
因此,当发现 slow 与 fast 相遇时,我们再额外使用一个指针 ptr。起始,它指向链表头部;随后,它和 slow 每次向后移动一个位置。最终,它们会在入环点相遇。
/**
* Definition for singly-linked list.
* function ListNode(val) {
* this.val = val;
* this.next = null;
* }
*/
/**
* @param {ListNode} head
* @return {ListNode}
*/
var detectCycle = function(head) {
if (head === null) {
return null;
}
let slow = head, fast = head;
while (fast !== null) {
slow = slow.next;
if (fast.next !== null) {
fast = fast.next.next;
} else {
return null;
}
if (fast === slow) {
let ptr = head;
while (ptr !== slow) {
ptr = ptr.next;
slow = slow.next;
}
return ptr;
}
}
return null;
};复杂度分析
- 时间复杂度:O(N),其中 N 为链表中节点的数目。在最初判断快慢指针是否相遇时,slow 指针走过的距离不会超过链表的总长度;随后寻找入环点时,走过的距离也不会超过链表的总长度。因此,总的执行时间为 O(N)+O(N)=O(N)。
- 空间复杂度:O(1)。我们只使用了 slow,fast,ptr 三个指针。
LC 相交链表
给你两个单链表的头结点 headA 和 headB,请你找出并返回两个单链表相交的起始结点。如果两个链表不存在相交结点,返回 null。
图示两个链表在节点 c1 开始相交:
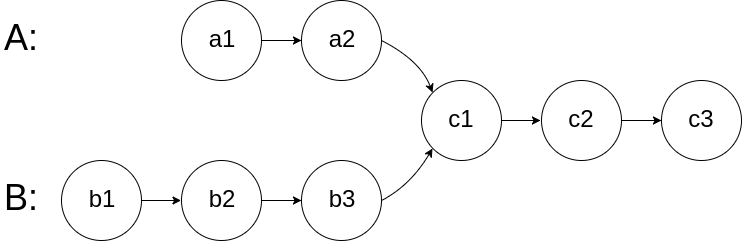
题目数据 保证 整个链式结构中不存在环。
注意,函数返回结果后,链表必须 保持其原始结构 。
示例 1:
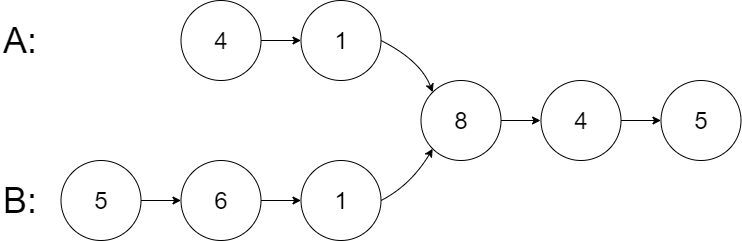
 输入:intersectVal = 8, listA = [4,1,8,4,5], listB = [5,6,1,8,4,5], skipA = 2, skipB = 3
 输出:Intersected at '8'
 解释:相交节点的值为 8 (注意,如果两个链表相交则不能为 0)。
 从各自的表头开始算起,链表 A 为 [4,1,8,4,5],链表 B 为 [5,6,1,8,4,5]。
 在 A 中,相交节点前有 2 个节点;在 B 中,相交节点前有 3 个节点。
 — 请注意相交节点的值不为 1,因为在链表 A 和链表 B 之中值为 1 的节点 (A 中第二个节点和 B 中第三个节点) 是不同的节点。换句话说,它们在内存中指向两个不同的位置,而链表 A 和链表 B 中值为 8 的节点 (A 中第三个节点,B 中第四个节点) 在内存中指向相同的位置。
示例 2:
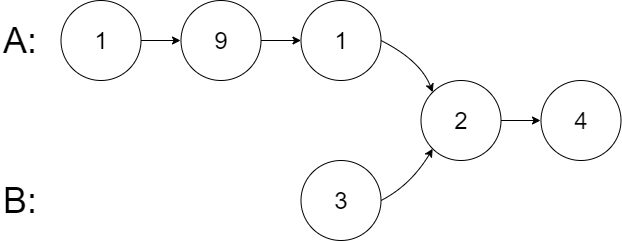
 输入:intersectVal = 2, listA = [1,9,1,2,4], listB = [3,2,4], skipA = 3, skipB = 1
 输出:Intersected at '2'
 解释:相交节点的值为 2 (注意,如果两个链表相交则不能为 0)。
 从各自的表头开始算起,链表 A 为 [1,9,1,2,4],链表 B 为 [3,2,4]。
 在 A 中,相交节点前有 3 个节点;在 B 中,相交节点前有 1 个节点。
示例 3:
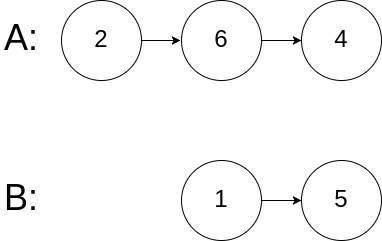
 输入:intersectVal = 0, listA = [2,6,4], listB = [1,5], skipA = 3, skipB = 2
 输出:null
 解释:从各自的表头开始算起,链表 A 为 [2,6,4],链表 B 为 [1,5]。
 由于这两个链表不相交,所以 intersectVal 必须为 0,而 skipA 和 skipB 可以是任意值。
这两个链表不相交,因此返回 null 。提示:
listA中节点数目为mlistB中节点数目为n- 1 <= m, n <= 3 * 104
- 1 <= Node.val <= 105
0 <= skipA <= m0 <= skipB <= n- 如果
listA和listB没有交点,intersectVal为0 - 如果
listA和listB有交点,intersectVal == listA[skipA] == listB[skipB]
进阶:你能否设计一个时间复杂度 O(m + n) 、仅用 O(1) 内存的解决方案?
题解
方法一:哈希集合
首先遍历链表 headA,并将链表 headA 中的每个节点加入哈希集合中。然后遍历链表 headB,对于遍历到的每个节点,判断该节点是否在哈希集合中:
/**
* Definition for singly-linked list.
* function ListNode(val) {
* this.val = val;
* this.next = null;
* }
*/
/**
* @param {ListNode} headA
* @param {ListNode} headB
* @return {ListNode}
*/
var getIntersectionNode = function(headA, headB) {
const visited = new Set();
let temp = headA;
while (temp !== null) {
visited.add(temp);
temp = temp.next;
}
temp = headB;
while (temp !== null) {
if (visited.has(temp)) {
return temp;
}
temp = temp.next;
}
return null;
};复杂度分析
- 时间复杂度:O(m + n),其中 m 和 n 是分别是链表 headA 和 headB 的长度。需要遍历两个链表各一次。
- 空间复杂度:O(m),其中 m 是链表 headA 的长度。需要使用哈希集合存储链表 headA 中的全部节点。
方法二:双指针
只有当两个链表不为空时,才有可能有相交链表,首先判断两个链表是否为空,若其中至少一个链表为空,则两个链表一定不相交,返回 null。
若都不为空,创建两个指针 pA 和 pB,使指针指向各自的头结点,使两个指针遍历各自链表,直至指向为空,则使其各自指向另一个链表的头结点,当指针同时指向同一个节点或同时为空时,返回他们的结点或 null。
/**
* Definition for singly-linked list.
* function ListNode(val) {
* this.val = val;
* this.next = null;
* }
*/
/**
* @param {ListNode} headA
* @param {ListNode} headB
* @return {ListNode}
*/
var getIntersectionNode = function(headA, headB) {
if (headA === null || headB === null) {
return null;
}
let pA = headA, pB = headB;
while (pA !== pB) {
pA = (pA === null ? headB : pA.next);
pB = (pB === null ? headA : pB.next);
}
return pA;
};复杂度分析
- 时间复杂度:O(m + n),其中 m 和 n 分别是链表 headA 和 headB 的长度。两个指针同时遍历两个链表,每个指针遍历两个链表各一次
- 空间复杂度:O(1)。
LC 删除链表的倒数第 N 个节点
给一个链表,删除链表的倒数第 n 个节点,并且返回链表头结点。
示例 1:
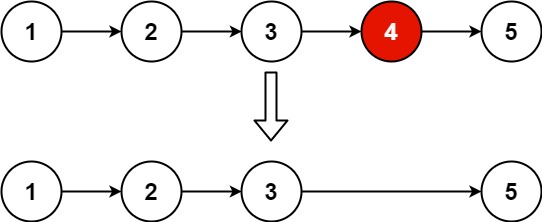
 输入:head = [1,2,3,4,5], n = 2
 输出:[1,2,3,5]
示例 2:
 输入:head = [1], n = 1
 输出:[]
示例 3:
 输入:head = [1,2], n = 1
输出:[1]提示:
- 链表中结点的数目为
sz 1 <= sz <= 300 <= Node.val <= 1001 <= n <= sz
进阶:能用一趟扫描实现吗?
题解
在对链表进行操作时,一种常用技巧是添加一个 哑结点(dummy node),它的 next 指针指向链表的头结点。这样我们就不再需要对头结点进行特殊的判断了。
方法:快慢指针
- 初始化快慢指针都指向虚拟头节点
- 将 fast 向后移动 n 个节点,此时快慢指针相隔 n 个元素
- 同时向后移动快慢指针,直到 fast 走到最后,此时 slow 下一节点即为要删除元素
- 删除 slow 下一节点
 /**
  * Definition for singly-linked list.
  * function ListNode(val, next) {
  *     this.val = (val===undefined ? 0 : val)
  *     this.next = (next===undefined ? null : next)
  * }
  */
 /**
  * @param {ListNode} head
  * @param {number} n
  * @return {ListNode}
  */
 var removeNthFromEnd = function(head, n) {
     let dmy = new ListNode(0, head);
     let slow = dmy;
     let fast = dmy;
     while (n-- > 0) {
         fast = fast.next;
     }
     while (fast !== null && fast.next !== null) {
         fast = fast.next;
         slow = slow.next;
     }
     slow.next = slow.next.next;
     return dmy.next;
 };
复杂度分析
- 时间复杂度:O(L),其中 L 是链表的长度。
- 空间复杂度:O(1)。
A 小结 – 链表中的双指针
在这里提供一个模板,用于解决链表中双指针问题。
 // Initialize slow & fast pointers
 ListNode slow = head;
 ListNode fast = head;
 /**
  * Change this condition to fit specific problem.
  * Attention: remember to avoid null-pointer error
  **/
 while (slow != null && fast != null && fast.next != null) {
     slow = slow.next;           // move slow pointer one step each time
     fast = fast.next.next;      // move fast pointer two steps each time
     if (slow == fast) {         // change this condition to fit specific problem
         return true;
     }
 }
 return false;   // change return value to fit specific problem
提示
它与我们在数组中学到的内容类似。但它可能更棘手而且更容易出错。你应该注意以下几点:
- 在调用 next 字段之前,始终检查节点是否为空。获取空节点的下一个节点将导致空指针错误。例如,在我们运行
fast = fast.next.next之前,需要检查fast和fast.next不为空。 - 仔细定义循环的结束条件运行几个示例,以确保你的结束条件不会导致无限循环。在定义结束条件时,你必须考虑我们的第一点提示。
复杂度分析
空间复杂度分析较容易。如果只使用指针,而不使用任何其他额外的空间,那么空间复杂度将是 O(1)。但时间复杂度的分析比较困难。为了得到答案,我们需要分析 运行循环的次数。
在前面的查找循环的示例中,假设我们每次移动快指针 2 步,慢指针 1 步。
- 如果没有循环,快指针需要
N/2次才能到达链表的末尾,其中 N 是链表的长度。 - 如果存在循环,则块指针需要
M次才能赶上慢指针,其中 M 是列表中循环的长度。
显然 M <= N。所以我们将循环运行 N 次。对于每次循环,我们只需要常量级的时间。因此,该算法的时间复杂度总共为 O(N)。
经典问题
A 反转链表
我们从一个经典问题开始:
反转一个单链表
一种解决方案是按原始顺序迭代结点,并将它们逐个移动到列表的头部。似乎很难理解。我们先用一个例子来说明我们的算法。
算法概述
我们来看一个例子:
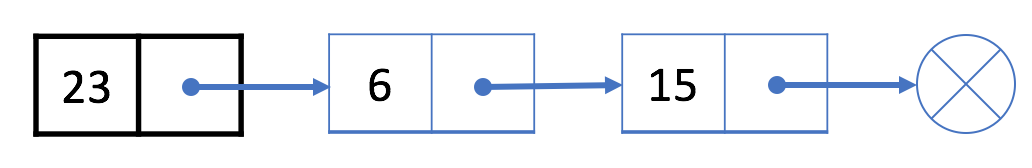
请记住,黑色结点 23 是原始的头结点。
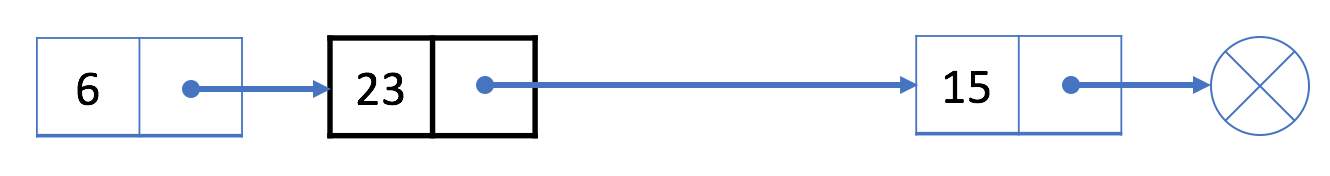
- 首先,我们将黑色结点的下一节点(即结点 6)移动到列表的头部:
- 然后,我们将黑色结点的下一个结点(即结点 15)移动到列表的头部:
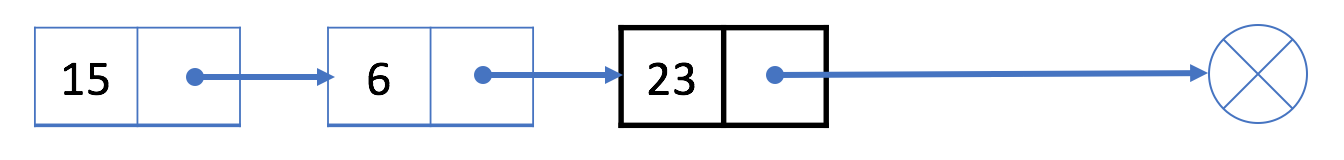
- 黑色结点的下一个结点现在是空。因此,我们停止这一过程并返回新的头结点 15。
更多
在该算法中,每个结点 只移动一次。
因此,时间复杂度为 O(N),其中 N 是链表的长度。我们只使用常量级的额外空间,所以空间复杂度为 O(1)。
这个问题是你在面试中可能遇到的许多链表问题的基础。如果你仍然遇到困难,我们的下一篇文章将更多地讨论实现细节。
还有许多其他的解决方案。您应该熟悉至少一个解决方案并能够实现它。
LC 反转链表
给你单链表的头结点 head,请你反转链表,并返回反转后的链表。
示例 1:
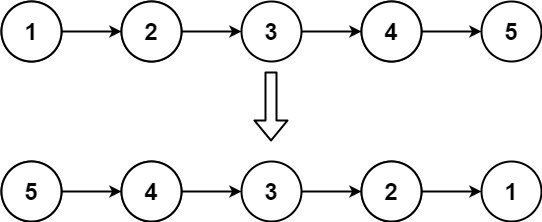
 输入:head = [1,2,3,4,5]
 输出:[5,4,3,2,1]
示例 2:
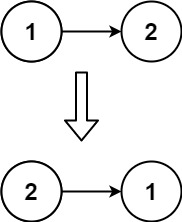
 输入:head = [1,2]
 输出:[2,1]
示例 3:
 输入:head = []
输出:[]提示:
- 链表中节点的数目范围是
[0, 5000] -5000 <= Node.val <= 5000
题解
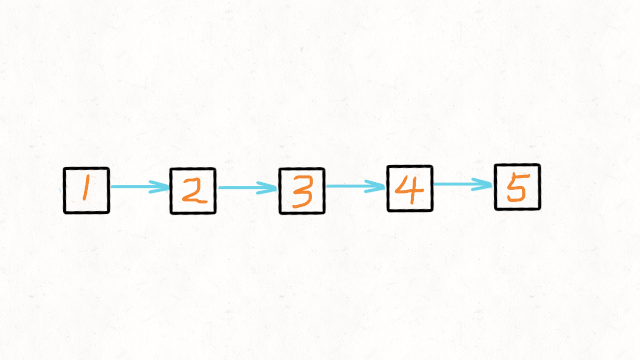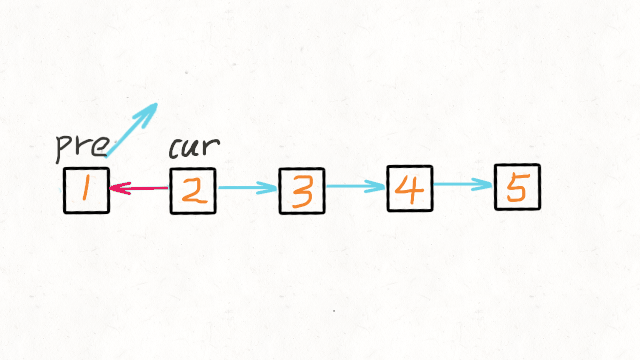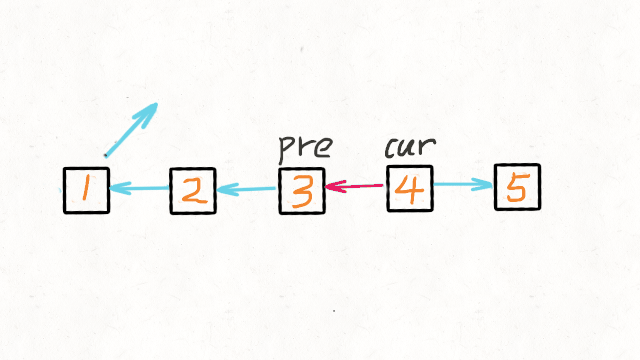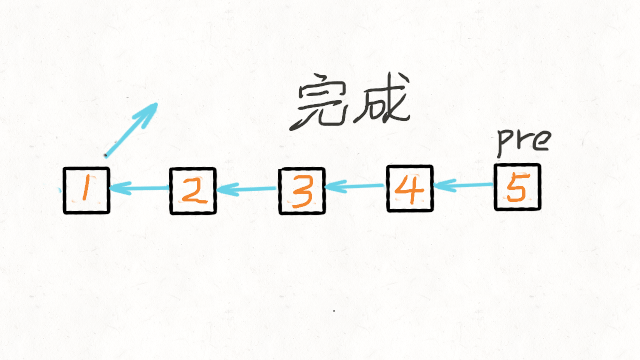
双指针迭代
 /**
  * Definition for singly-linked list.
  * function ListNode(val, next) {
  *     this.val = (val===undefined ? 0 : val)
  *     this.next = (next===undefined ? null : next)
  * }
  */
 /**
  * @param {ListNode} head
  * @return {ListNode}
  */
 var reverseList = function(head) {
     let pre = null;
     let cur = head;
     while (cur) {
         // 记录当前节点的下一个节点
         let next = cur.next;
         // 将当前节点指向 prev(反转)
         cur.next = pre;
         // pre 和 cur 节点都前进一位
         pre = cur;
         cur = next;
     }
     return pre;
 };
复杂度分析
- 时间复杂度:O(n),其中 n 是链表的长度。需要遍历链表一次。
- 空间复杂度:O(1)。
LC 移除链表元素
给你一个链表的头节点 head 和一个整数 val ,请你删除链表中所有满足 Node.val == val 的节点,并返回 新的头节点 。
示例 1:
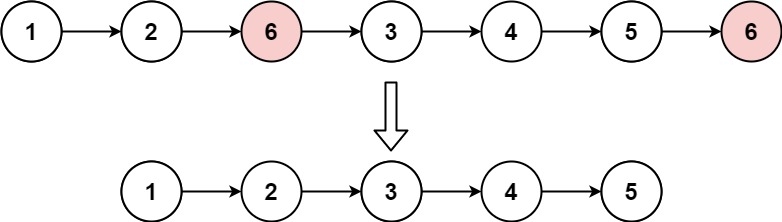
 输入:head = [1,2,6,3,4,5,6], val = 6
 输出:[1,2,3,4,5]
示例 2:
 输入:head = [], val = 1
 输出:[]
示例 3:
 输入:head = [7,7,7,7], val = 7
输出:[]提示:
- 列表中的节点数目在范围 [0, 104] 内
1 <= Node.val <= 500 <= val <= 50
题解
迭代
 /**
  * Definition for singly-linked list.
  * function ListNode(val, next) {
  *     this.val = (val===undefined ? 0 : val)
  *     this.next = (next===undefined ? null : next)
  * }
  */
 /**
  * @param {ListNode} head
  * @param {number} val
  * @return {ListNode}
  */
 var removeElements = function(head, val) {
     let dummyNode = new ListNode(null, head);
     let temp = dummyNode;
     while (temp.next !== null) {
         if (temp.next.val == val) {
             temp.next = temp.next.next;
         }
         else {
             temp = temp.next;
         }
     }
     return dummyNode.next;
 };
复杂度分析
- 时间复杂度:O(n),其中 n 是链表长度。需要遍历链表一次。
- 空间复杂度:O(1)。
LC 奇偶链表
给定单链表的头节点 head ,将所有索引为奇数的节点和索引为偶数的节点分别组合在一起,然后返回重新排序的列表。
第一个节点的索引被认为是 奇数 , 第二个节点的索引为 偶数 ,以此类推。
请注意,偶数组和奇数组内部的相对顺序应该与输入时保持一致。
你必须在 O(1) 的额外空间复杂度和 O(n) 的时间复杂度下解决这个问题。
示例 1:
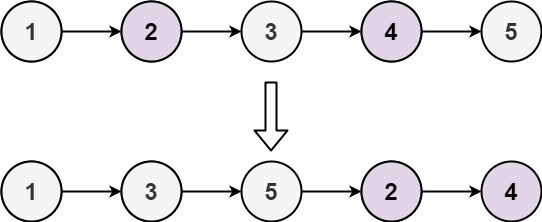
 输入: head = [1,2,3,4,5]
 输出: [1,3,5,2,4]
示例 2:
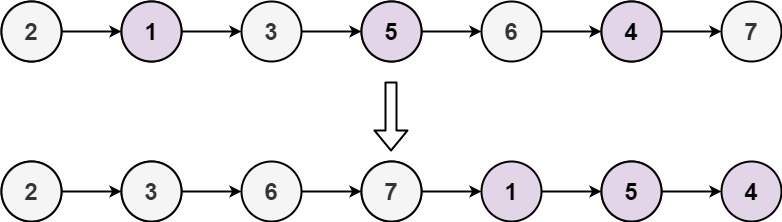
 输入: head = [2,1,3,5,6,4,7]
输出: [2,3,6,7,1,5,4]提示:
n ==链表中的节点数- 0 <= n <= 104
- -106 <= Node.val <= 106
题解
 var oddEvenList = function(head) {
     if (head === null) {
         return head;
     }
     let evenHead = head.next;
     // odd 作为奇数指针, even 作为偶数指针
     let odd = head, even = evenHead;
     while (even !== null && even.next !== null) {
         odd.next = even.next;
         odd = odd.next;
         even.next = odd.next;
         even = even.next;
     }
     odd.next = evenHead;
     return head;
 };
复杂度分析
- 时间复杂度:O(n),其中 n 是链表的节点数。需要遍历链表中的每个节点,并更新指针。
- 空间复杂度:O(1)。只需要维护有限个指针。
LC 回文链表
给你一个单链表的头节点 head ,请你判断该链表是否为回文链表。如果是,返回 true ;否则,返回 false 。
示例 1:
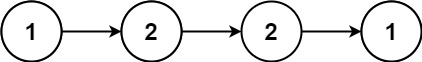
 输入:head = [1,2,2,1]
 输出:true
示例 2:
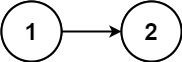
 输入:head = [1,2]
输出:false提示:
- 链表中节点数目在范围[1, 105] 内
0 <= Node.val <= 9
进阶:你能否用 O(n) 时间复杂度和 O(1) 空间复杂度解决此题?
题解
方法一:将值复制到数组后用双指针法
 /**
  * Definition for singly-linked list.
  * function ListNode(val, next) {
  *     this.val = (val===undefined ? 0 : val)
  *     this.next = (next===undefined ? null : next)
  * }
  */
 /**
  * @param {ListNode} head
  * @return {boolean}
  */
 var isPalindrome = function(head) {
     const vals = [];
     while (head !== null) {
         vals.push(head.val);
         head = head.next;
     }
     for (let i = 0, j = vals.length - 1; i < j; ++i, --j) {
         if (vals[i] !== vals[j]) {
             return false;
         }
     }
     return true;
 };
复杂度分析
- 时间复杂度:O(n),其中 n 指的是链表的元素个数。
- 第一步:遍历链表并将值复制到数组中,O(n)。
- 第二步:双指针判断是否为回文,执行了O(n/2) 次判断,即 O(n)。
- 总的时间复杂度:O(2n) = O(n)。
- 空间复杂度:O(n),其中 n 指的是链表的元素个数,我们使用了一个数组列表存放链表的元素值。
方法二:快慢指针
流程:
- 找到前半部分链表的尾节点可以用 快慢指针 在一次遍历中找到:慢指针一次走一步,快指针一次走两步,当快指针移动到链尾时,慢指针恰好到链表的中间。若链表有奇数个节点,则中间的结点应该看作是前半部分。
- 反转后半部分链表
- 判断是否回文比较链表前半和后半部分的值,当后半部分到达末尾则完成比较。
- 恢复链表
- 返回结果
/**
* Definition for singly-linked list.
* function ListNode(val, next) {
* this.val = (val===undefined ? 0 : val)
* this.next = (next===undefined ? null : next)
* }
*/
/**
* @param {ListNode} head
* @return {boolean}
*/
// 反转链表
const reverseList = (head) => {
let prev = null;
let curr = head;
while (curr !== null) {
let nextTemp = curr.next;
curr.next = prev;
prev = curr;
curr = nextTemp;
}
return prev;
}
// 找前半部分链尾
const endOfFirstHalf = (head) => {
let fast = head;
let slow = head;
while (fast.next !== null && fast.next.next !== null) {
fast = fast.next.next;
slow = slow.next;
}
return slow;
}
var isPalindrome = function(head) {
if (head == null) {
return true;
}
// 找到前半部分链表的尾节点并反转后半部分链表
const firstHalfEnd = endOfFirstHalf(head);
const secondHalfStart = reverseList(firstHalfEnd.next);
// 判断是否回文
let p1 = head;
let p2 = secondHalfStart;
let result = true;
while (result && p2 != null) {
if (p1.val != p2.val) {
result = false;
}
p1 = p1.next;
p2 = p2.next;
}
// 还原链表并返回结果
firstHalfEnd.next = reverseList(secondHalfStart);
return result;
}复杂度分析
- 时间复杂度:O(n),其中 n 指的是链表的大小。
- 空间复杂度:O(1)。我们只会修改原本链表中节点的指向,而在堆栈上的堆栈帧不超过 O(1)。
A 小结 – 链表经典问题
在几个练习之中,有一些相似之处:
- 通过一些测试用例可以节省你的时间。使用链表时不易调试。因此,在编写代码之前,自己尝试几个不同的实例来验证自己的算法总是很有用的。
- 你可以同时使用多个指针。有时为链表问题设计算法时,可能需要同时跟踪多个结点。你应该记住需要跟踪哪些结点,并且可以自由的使用几个不同的结点指针来同时跟踪这些结点。 如果你使用多个指针,最好为他们指定适当的名称,以防将来必须调试或检查代码。
- 在许多情况下,你需要跟踪当前结点的前一个结点。你无法追溯单链表中的前一个结点。因此,不仅要存储当前结点,还要存储前一个结点。这在双链表中是不同的。
双链表
本小节中,我们会介绍另一种链表:双链表。与单链表不同的是,双链表的每个结点中都含有两个引用字段。
A 简介 – 双链表
我们在前面的章节中介绍了单链表
单链表列表中的结点具有 Value 字段,以及用于顺序链接结点的 “Next” 引用字段。
我们将在这一节介绍另一种类型的链表:双链表。
定义
双链表以类似的方式工作,但还有一个引用字段,称为“prev”字段。有了这个额外的字段,您就能够知道当前结点的前一个结点。
让我们看一个例子:
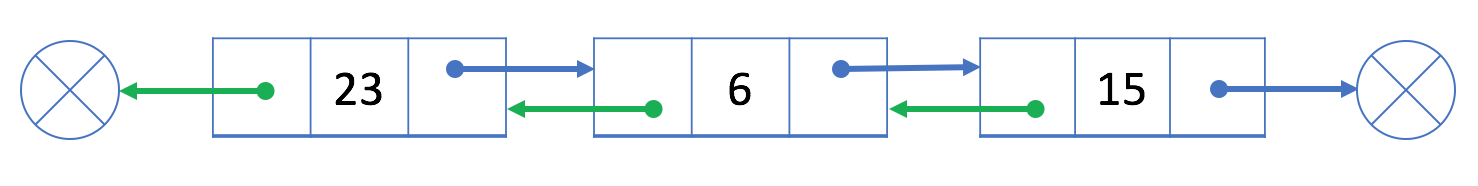
绿色箭头表示我们的 “prev” 字段是如何工作的。
结点结构
下面是双链表中节点结构的典型定义:
 // Definition for doubly-linked list.
 class DoublyListNode {
     int val;
     DoublyListNode next, prev;
     DoublyListNode(int x) {val = x;}
 }
与单链表类似,我们将使用 头结点 来表示整个列表。
操作
与单链表类似,我们将介绍在双链表中如何访问数据、插入新结点或删除现有结点。
我们可以与单链表相同的方式访问数据:
- 我们不能再常量级的时间内
访问随机位置。 - 我们必须从头部遍历才能得到我们想要的第一个结点。
- 在最坏的情况下,时间复杂度将是
O(N),其中N是链表的长度。
对于添加和删除,会稍微复杂一些,因为我们还需要处理 “prev” 字段。在接下来会介绍这两个操作。
A 添加操作 – 双链表
如果我们想在现有的结点 prev 之后插入一个新的结点 cur,我们可以将此过程分为两个步骤:
- 链接
cur与prev和next,其中next是prev原始的下一个节点;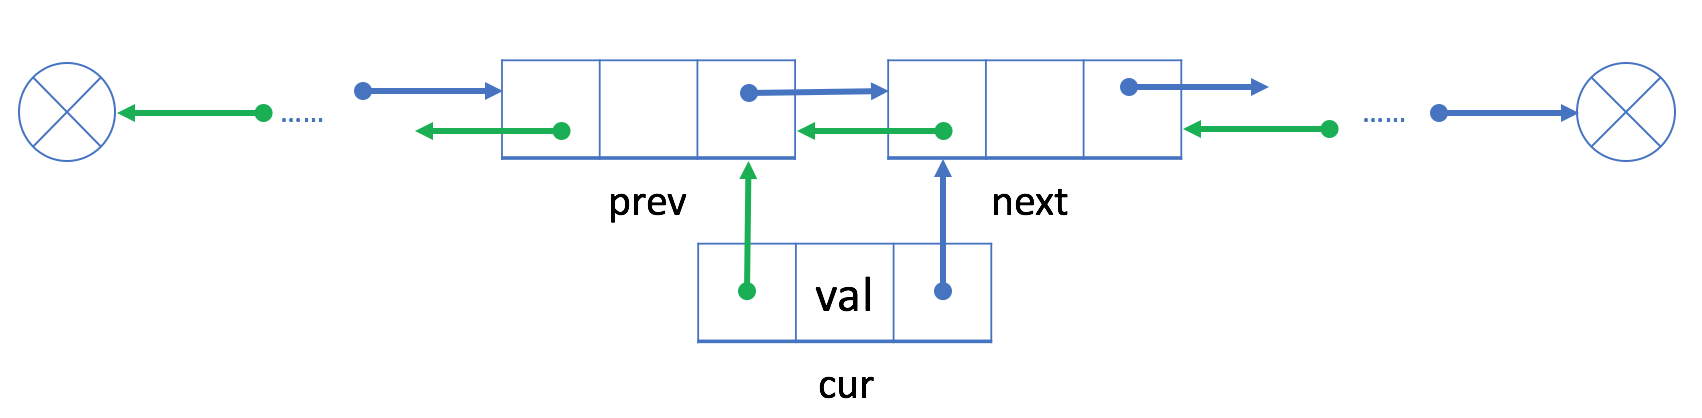
- 用
cur重新链接prev和next。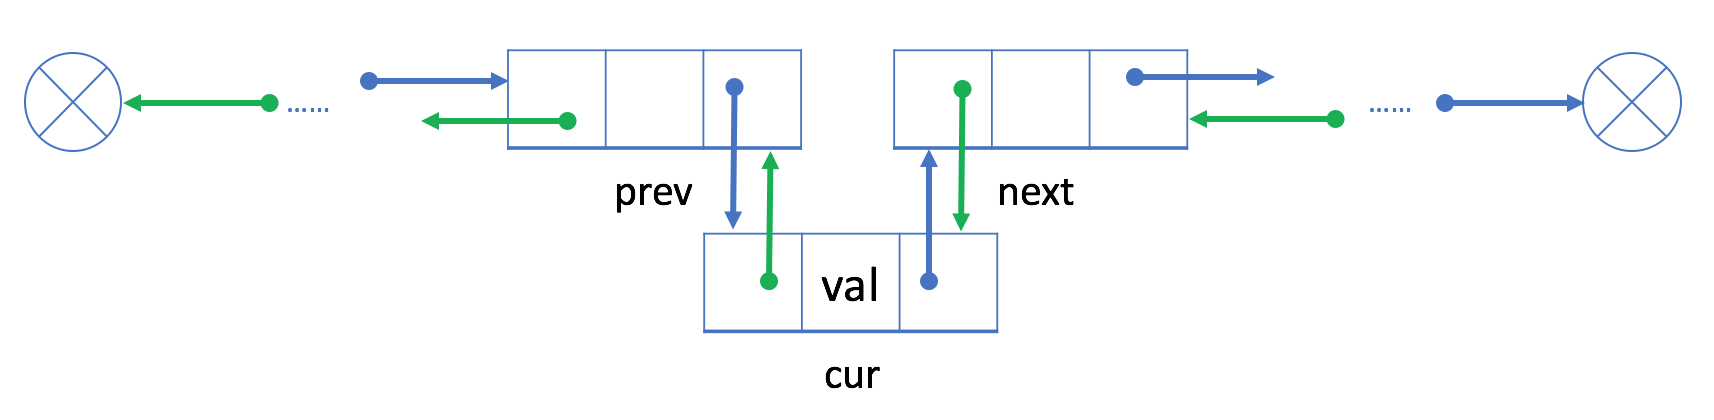
与单链表类似,添加操作的时间和空间复杂度都是 O(1)。
示例
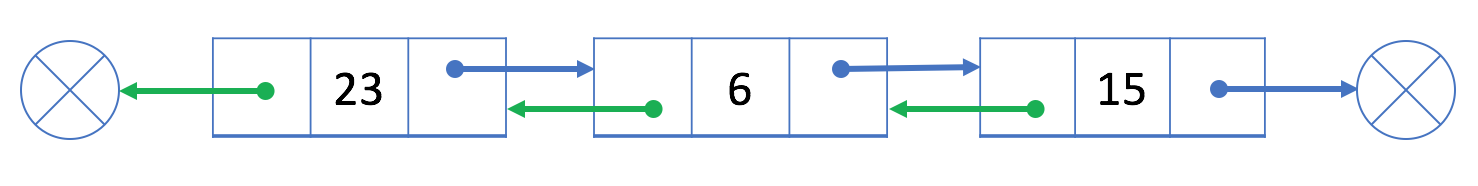
让我们在现有结点 6 之后添加一个新结点 9:
- 链接
cur(结点 9)与prev(结点 6)和next(结点 15)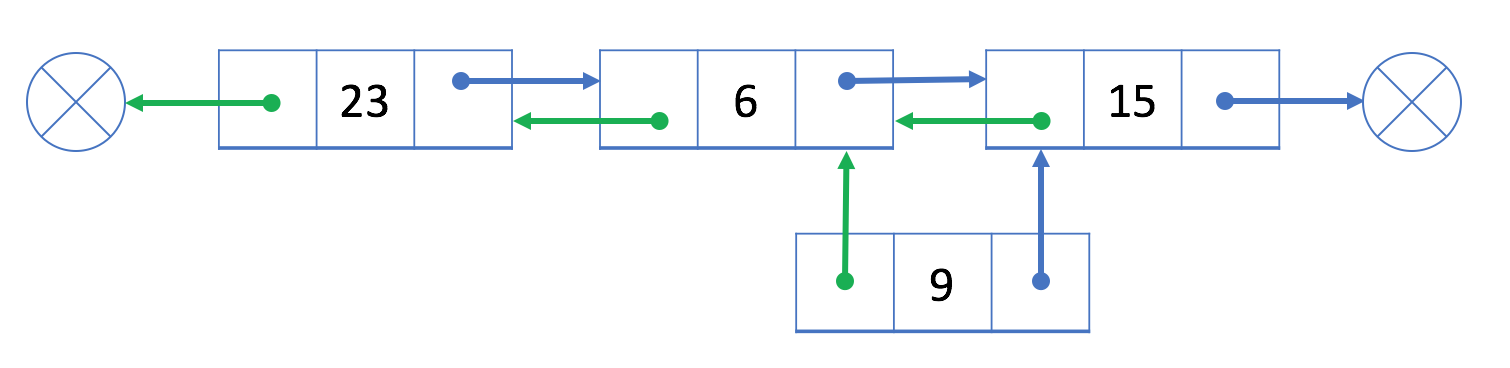
- 用
cur(结点 9)重新链接prev(结点 6)和next(结点15)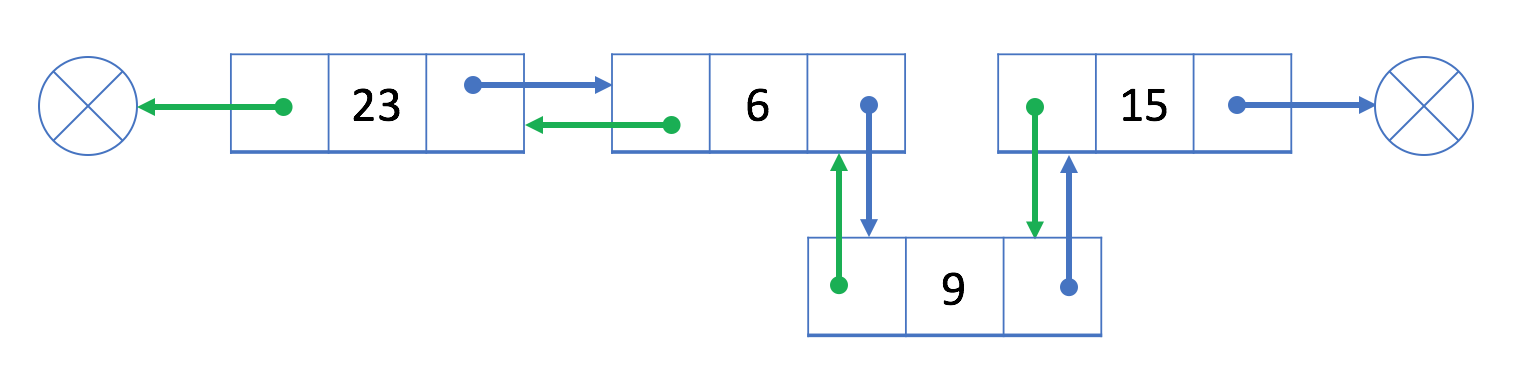
如果我们想在
开头或结尾插入一个新结点怎么办?
A 删除操作 – 双链表
如果我们想从双链表中删除一个现有的结点 cur,我们可以简单的将它的前一个结点 prev 与下一个结点 next 链接起来。
与单链表不同,使用 “prev” 字段可以很容易的在常量时间内获得前一个结点。
因为我们不再需要遍历链表来获取前一个结点,所以时间和空间复杂度都是 O(1)。
示例
我们的目标时从双链表中删除结点 6。
因此,我们将它的前一个结点 23 和下一个结点15 链接起来:
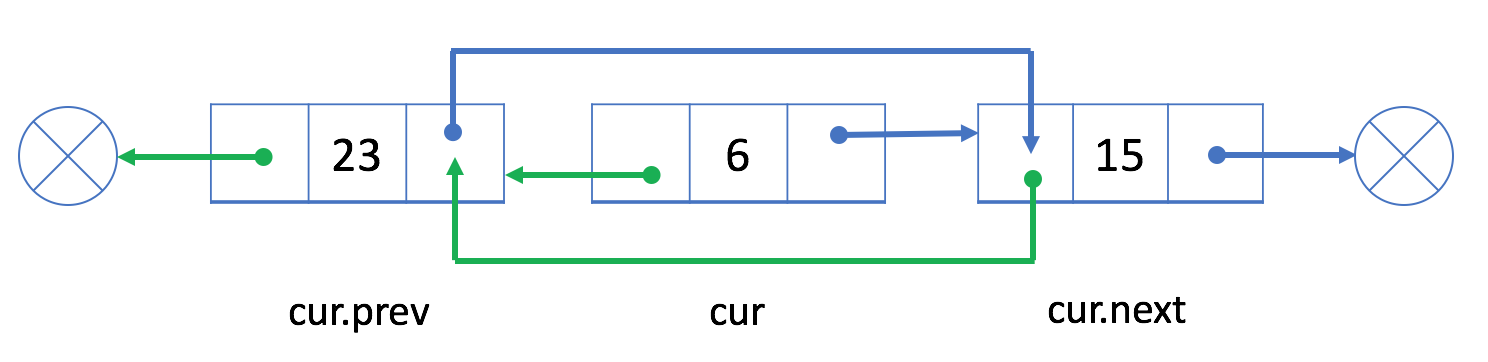
结点 6 现在不在我们的双链表中。
如果我们要删除
第一个结点或最后一个结点怎么办?
小结
在前面的章节中,我们已经学习了许多关于单链表和双链表的知识。
本章节中,我们将总结此前学到的知识,并对链表和其他数据结构进行简短比较。
A 小结 – 链表
复习
让我们简要的回顾一下单链表和双链表的表现。
它们在许多操作中是相似的。
- 它们都无法在常量时间内
随机访问数据。 - 它们都能够
在 O(1) 时间内在给定结点之后或列表开头添加一个新结点。 - 它们都能够
在 O(1) 时间内删除第一个结点。
但是删除给定结点(包括最后一个结点)时略有不同。
- 在单链表中,它无法获取给定结点的前一个结点,因此在删除给定结点之前我们必须花费
O(N)时间来找出前一结点。 - 在双链表中,这会更容易,因为我们可以使用 “prev” 引用字段来获取前一个结点。因此我们可以在
O(1)时间内删除给定结点。
对照
这里给出链表与其他数据结构(包括数组,队列和栈)之间 时间复杂度 的比较:
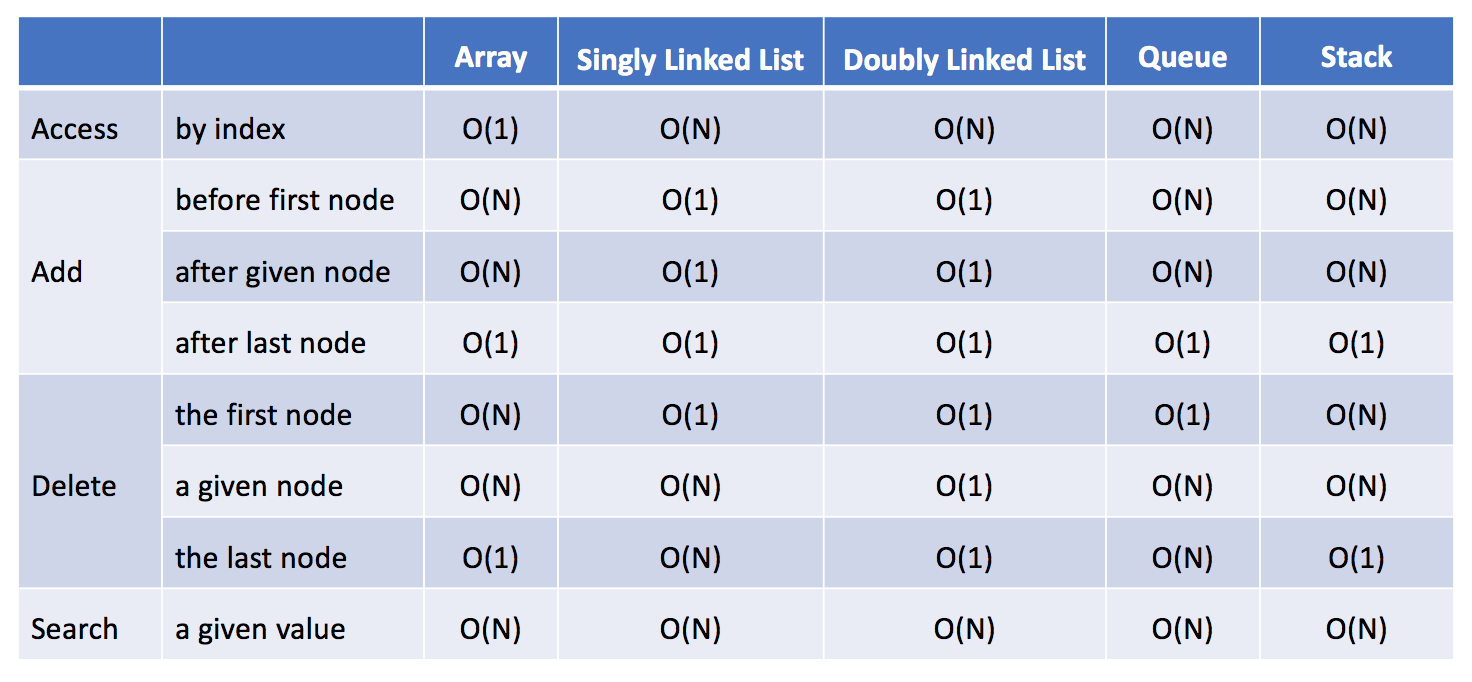
经过这次比较,不难得出结论:
如果需要经常添加或删除结点,链表是一个不错的选择。
如果需要经常按索引访问元素,数组是比链表更好的选择。
LC 合并两个有序链表
将两个升序链表合并为一个新的 升序 链表并返回。新链表是通过拼接给定的两个链表的所有节点组成的。
示例 1:
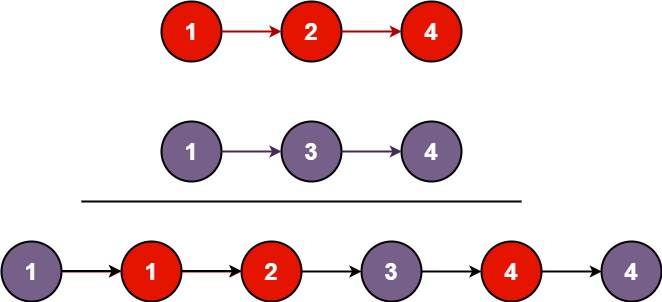
 输入:l1 = [1,2,4], l2 = [1,3,4]
 输出:[1,1,2,3,4,4]
示例 2:
 输入:l1 = [], l2 = []
 输出:[]
示例 3:
 输入:l1 = [], l2 = [0]
输出:[0]提示:
- 两个链表的结点数目范围是
[0, 50] -100 <= Node.val <= 100l1和l2均按 非递减顺序 排列
题解
/**
* Definition for singly-linked list.
* function ListNode(val, next) {
* this.val = (val===undefined ? 0 : val)
* this.next = (next===undefined ? null : next)
* }
*/
/**
* @param {ListNode} list1
* @param {ListNode} list2
* @return {ListNode}
*/
var mergeTwoLists = function(list1, list2) {
const prehead = new ListNode(-1);
let prev = prehead;
while(list1 != null && list2 != null) {
if (list1.val <= list2.val) {
prev.next = list1;
list1 = list1.next;
}
else {
prev.next = list2;
list2 = list2.next;
}
prev = prev.next;
}
prev.next = (list1 === null ? list2 : list1);
return prehead.next;
};复杂度分析
- 时间复杂度:O(n + m),其中 n 和 m 分别为两个链表的长度。因为每次循环迭代中,
list1和list2只有一个元素会被放进合并链表中,因此while循环的次数不会超过两个链表的长度之和。所有其他操作的时间复杂度都是常数级别的,因此总的时间复杂度为 O(n + m)。 - 空间复杂度:O(1)。我们只需要常数的空间存放若干变量。
LC 两数相加
给你两个 非空 的链表,表示两个非负的整数。它们每位数字都是按照 逆序 的方式存储的,并且每个节点只能存储 一位 数字。
请你将两个数相加,并以相同形式范围一个表示和的链表。
你可以假设除了数字 0 之外,这两个数都不会以 0 开头。
示例 1:
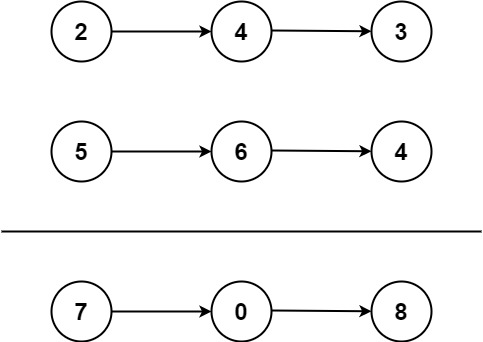
 输入:l1 = [2,4,3], l2 = [5,6,4]
 输出:[7,0,8]
 解释:342 + 465 = 807.
示例 2:
 输入:l1 = [0], l2 = [0]
 输出:[0]
示例 3:
 输入:l1 = [9,9,9,9,9,9,9], l2 = [9,9,9,9]
输出:[8,9,9,9,0,0,0,1]提示:
- 每个链表中的节点数在范围
[1, 100]内 0 <= Node.val <= 9- 题目数据保证列表表示的数字不含前导零
题解
 /**
  * Definition for singly-linked list.
  * function ListNode(val, next) {
  *     this.val = (val===undefined ? 0 : val)
  *     this.next = (next===undefined ? null : next)
  * }
  */
 /**
  * @param {ListNode} l1
  * @param {ListNode} l2
  * @return {ListNode}
  */
 var addTwoNumbers = function(l1, l2) {
     let head = null, tail = null;
     let carry = 0; // 进位值 9+7 进位值为 1
     while (l1 || l2) { // 若链表为空,用 0 替代
         const n1 = l1 ? l1.val : 0;
         const n2 = l2 ? l2.val : 0;
         const sum = n1 + n2 + carry;
         if (!head) {
             head = tail = new ListNode(sum % 10);
         }
         else {
             tail.next = new ListNode(sum % 10);
             tail = tail.next;
         }
         carry = Math.floor(sum / 10);
         if (l1) {
             l1 = l1.next;
         }
         if (l2) {
             l2 = l2.next;
         }
     }
     if (carry > 0) {
         tail.next = new ListNode(carry);
     }
     return head;
 };
复杂度分析
- 时间复杂度:O(max(m,n)),其中 m 和 n 分别为两个链表的长度。我们要遍历两个链表的全部位置,而处理每个位置只需要 O(1) 的时间。
- 空间复杂度:O(1)。注意返回值不计入空间复杂度。
LC 扁平化多级双向链表
你会得到一个双链表,其中包含的节点有一个下一个指针、一个前一个指针和一个额外的 子指针。这个子指针可能指向一个单独的双向链表,也包含这些特殊的节点。这些子列表可以有一个或多个自己的子列表,以此类推,以生成如下示例的 多层数据结构。
给定链表的头节点 head,将链表 扁平化,以便所有节点都出现在单层双链表中。让 curr 是一个带有子列表的节点。子列表中的节点应该出现在 扁平化列表 中的 curr 之后 和 curr.next 之前。
返回扁平列表的 head。列表中的结点必须将其 所有 子指针设置为 null。
示例 1:
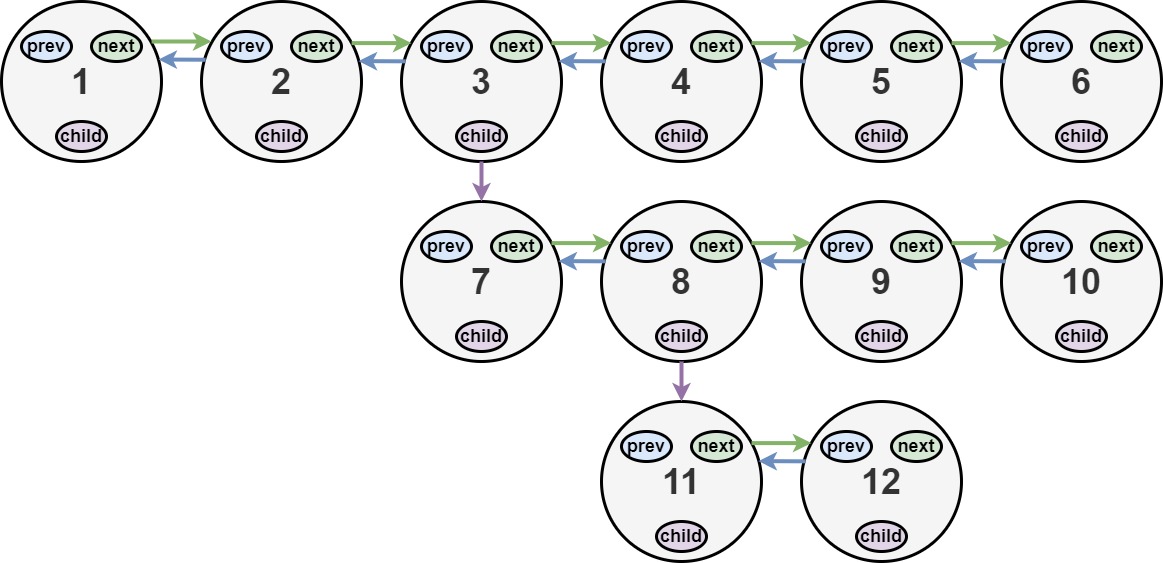
 输入:head = [1,2,3,4,5,6,null,null,null,7,8,9,10,null,null,11,12]
 输出:[1,2,3,7,8,11,12,9,10,4,5,6]
 解释:输入的多级列表如上图所示。
 扁平化后的链表如下图:
示例 2:
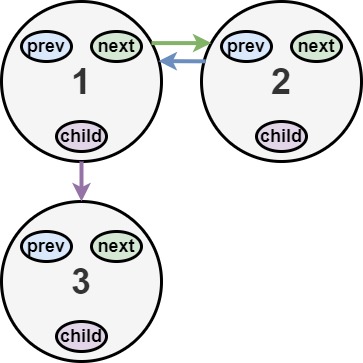
 输入:head = [1,2,null,3]
 输出:[1,3,2]
 解释:输入的多级列表如上图所示。
 扁平化后的链表如下图: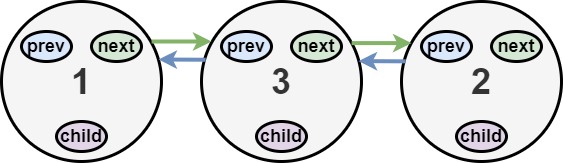
示例 3:
 输入:head = []
 输出:[]
说明:输入中可能存在空列表。提示:
- 节点数目不超过
1000 - 1 <= Node.val <= 105
如何表示测试用例中的多级链表?
以 示例 1 为例:
  1---2---3---4---5---6--NULL
          |
          7---8---9---10--NULL
              |
              11--12--NULL
序列化其中的每一级之后:
 [1,2,3,4,5,6,null]
 [7,8,9,10,null]
 [11,12,null]
为了将每一级都序列化到一起,我们需要每一级中添加值为 null 的元素,以表示没有节点连接到上一级的上级节点。
 [1,2,3,4,5,6,null]
 [null,null,7,8,9,10,null]
 [null,11,12,null]
合并所有序列化结果,并去除末尾的 null 。
[1,2,3,4,5,6,null,null,null,7,8,9,10,null,null,11,12]题解
解题思路
/**
* // Definition for a Node.
* function Node(val,prev,next,child) {
* this.val = val;
* this.prev = prev;
* this.next = next;
* this.child = child;
* };
*/
/**
* @param {Node} head
* @return {Node}
*/
var flatten = function(head) {
const dfs = (node) => {
let cur = node;
// 记录链表的最后一个节点
let last = null;
while (cur) {
let next = cur.next;
// 如果有子节点,那么首先处理子节点
if (cur.child) {
const childLast = dfs(cur.child);
next = cur.next;
// 将 node 与 child 相连
cur.next = cur.child;
cur.child.prev = cur;
// 如果 next 不为空,就将 last 与 next 相连
if (next != null) {
childLast.next = next;
next.prev = childLast;
}
// 将 child 置为空
cur.child = null;
last = childLast;
} else {
last = cur;
}
cur = next;
}
return last;
}
dfs(head);
return head;
};复杂度分析
- 时间复杂度:O(n),其中 n 是链表中节点个数。
- 空间复杂度:O(n)。上述代码中使用的空间为深度优先搜索中的栈空间,如果给定的链表的「深度」为 d,那么空间复杂度为 O(d)。在最坏情况下,链表中的每个节点的 next 都为空,且除了最后一个节点外,每个节点的 child 都不为空,整个链表的深度为 n,因此时间复杂度为 O(n)。
其他题解:一题三解 :「递归(优化)」&「迭代」
LC 复制带随机指针的链表
给你一个长度为 n 的链表,每个节点包含一个额外增加的随机指针 random ,该指针可以指向链表中的任何节点或空节点。
构造这个链表的 深拷贝。深拷贝应该正好由 n 个 全新 节点组成,其中每个新节点的值都设为其对应的原节点的值。新节点的 next 指针和 random 指针也都应指向复制链表中的新节点,并使原链表和复制链表中的这些指针能够表示相同的链表状态。复制链表中的指针都不应指向原链表中的节点 。
例如,如果原链表中有 X 和 Y 两个节点,其中 X.random --> Y 。那么在复制链表中对应的两个节点 x 和 y ,同样有 x.random --> y 。
返回复制链表的头节点。
用一个由 n 个节点组成的链表来表示输入/输出中的链表。每个节点用一个 [val, random_index] 表示:
val:一个表示Node.val的整数。random_index:随机指针指向的节点索引(范围从0到n-1);如果不指向任何节点,则为null。- 你的代码 只 接受原链表的头节点
head作为传入参数。
示例 1:
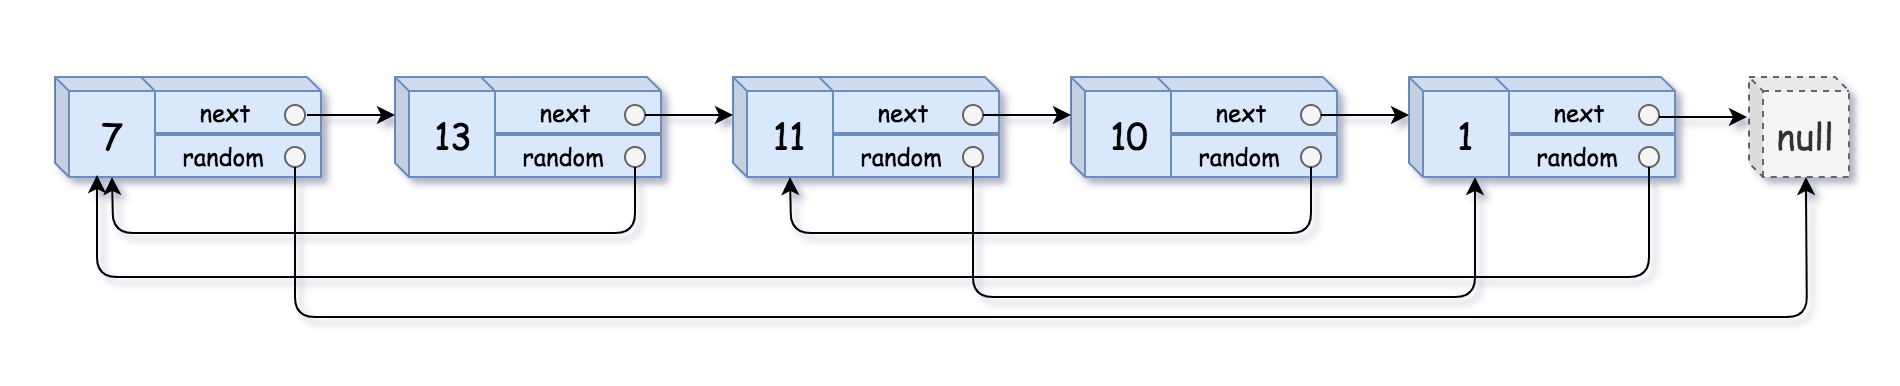
 输入:head = [[7,null],[13,0],[11,4],[10,2],[1,0]]
 输出:[[7,null],[13,0],[11,4],[10,2],[1,0]]
示例 2:
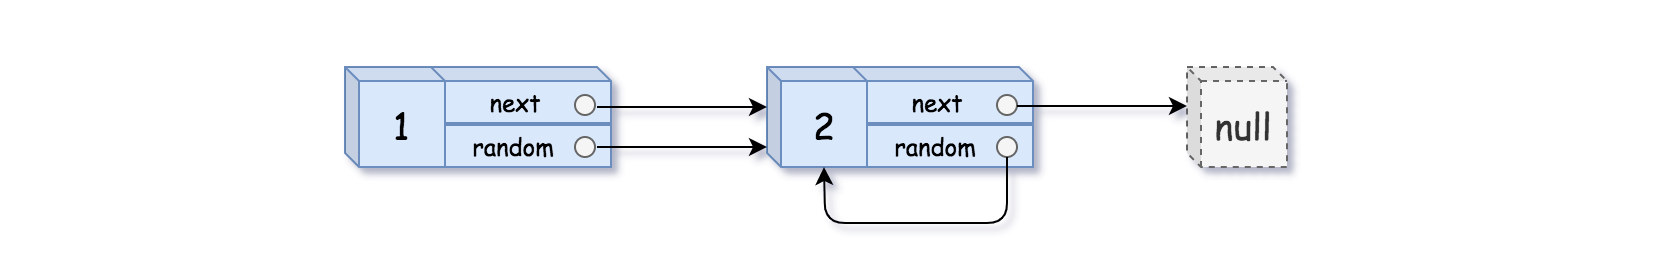
 输入:head = [[1,1],[2,1]]
 输出:[[1,1],[2,1]]
示例 3:
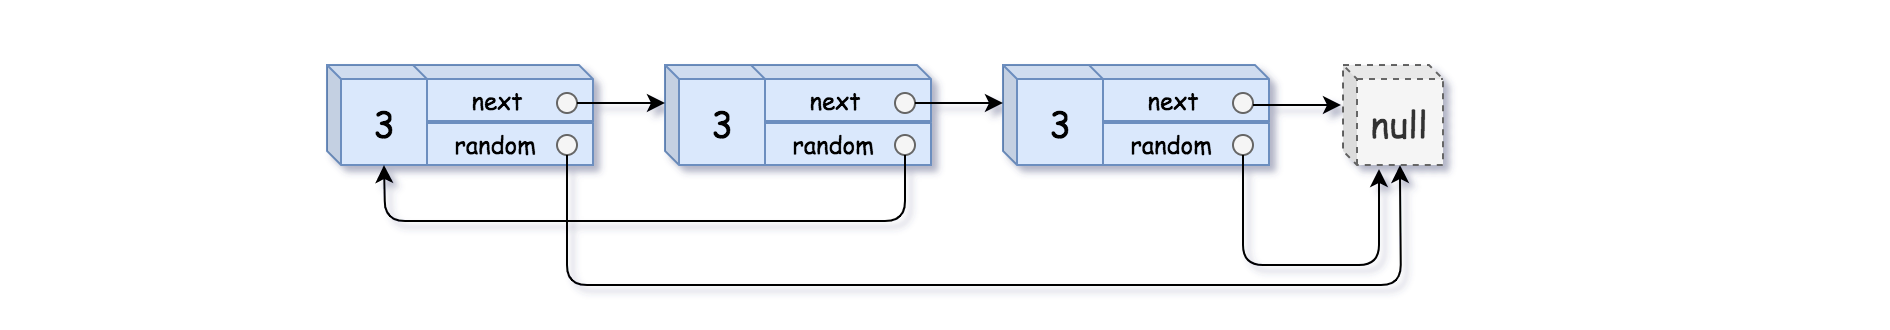
 输入:head = [[3,null],[3,0],[3,null]]
输出:[[3,null],[3,0],[3,null]]提示:
0 <= n <= 1000- -104 <= Node.val <= 104
Node.random为null或指向链表中的节点。
题解
方法一:回溯 + 哈希表
 var copyRandomList = function (head, cachedNode = new Map()) {
   if (head === null) {
     return null;
   }
   if (!cachedNode.has(head)) {
     cachedNode.set(head, { val: head.val }), Object.assign(cachedNode.get(head),
       { next: copyRandomList(head.next, cachedNode), random: copyRandomList(head.random, cachedNode) })
   }
   return cachedNode.get(head);
}ES6 JavaScript 对象方法 Object.assign()
复杂度分析
- 时间复杂度:O(n),其中 n 是链表的长度。对于每个节点,我们至多访问其「后继节点」和「随机指针指向的节点」各一次,均摊每个点至多被访问两次。
- 空间复杂度:O(n),其中 n 是链表的长度。为哈希表的空间开销。
方法二:迭代 + 节点拆分
查看图解
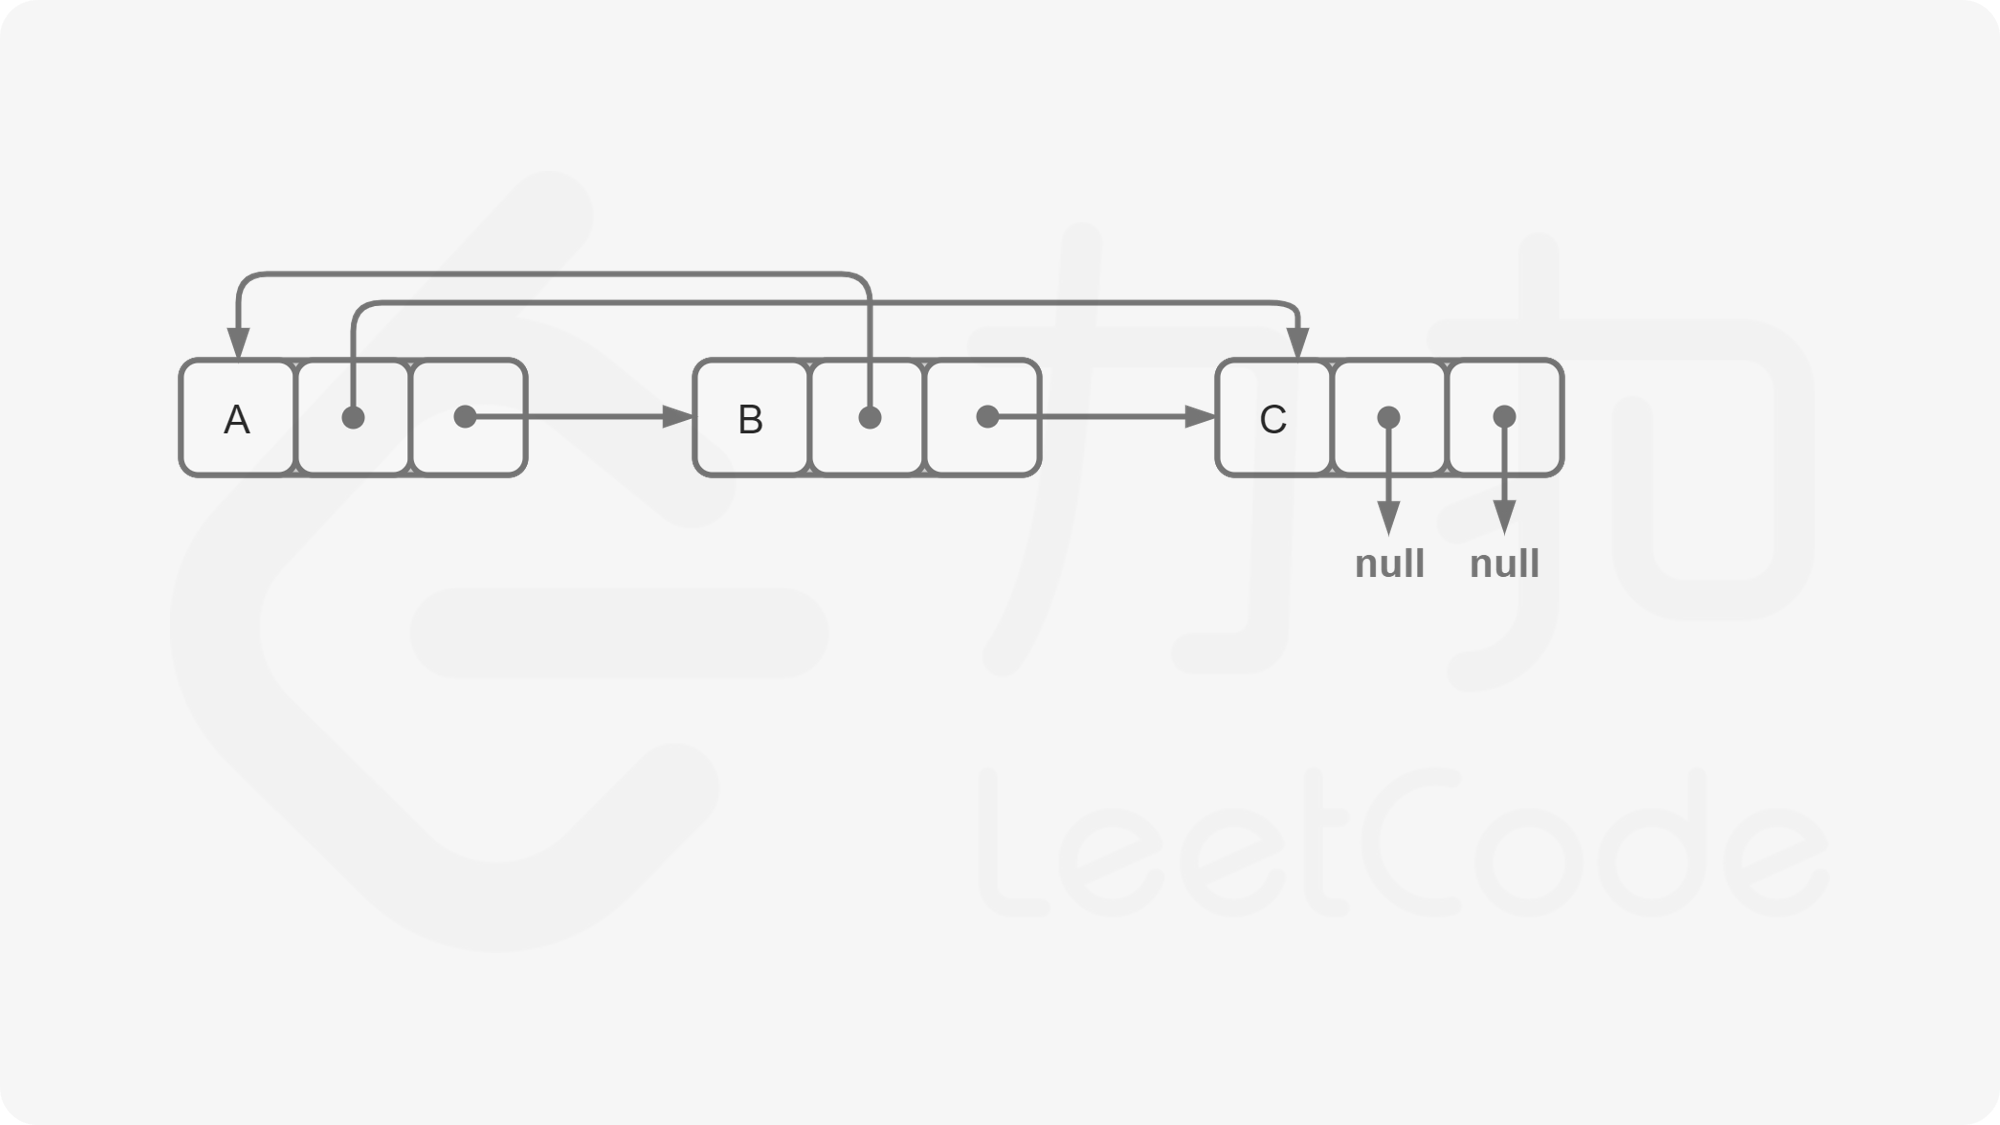
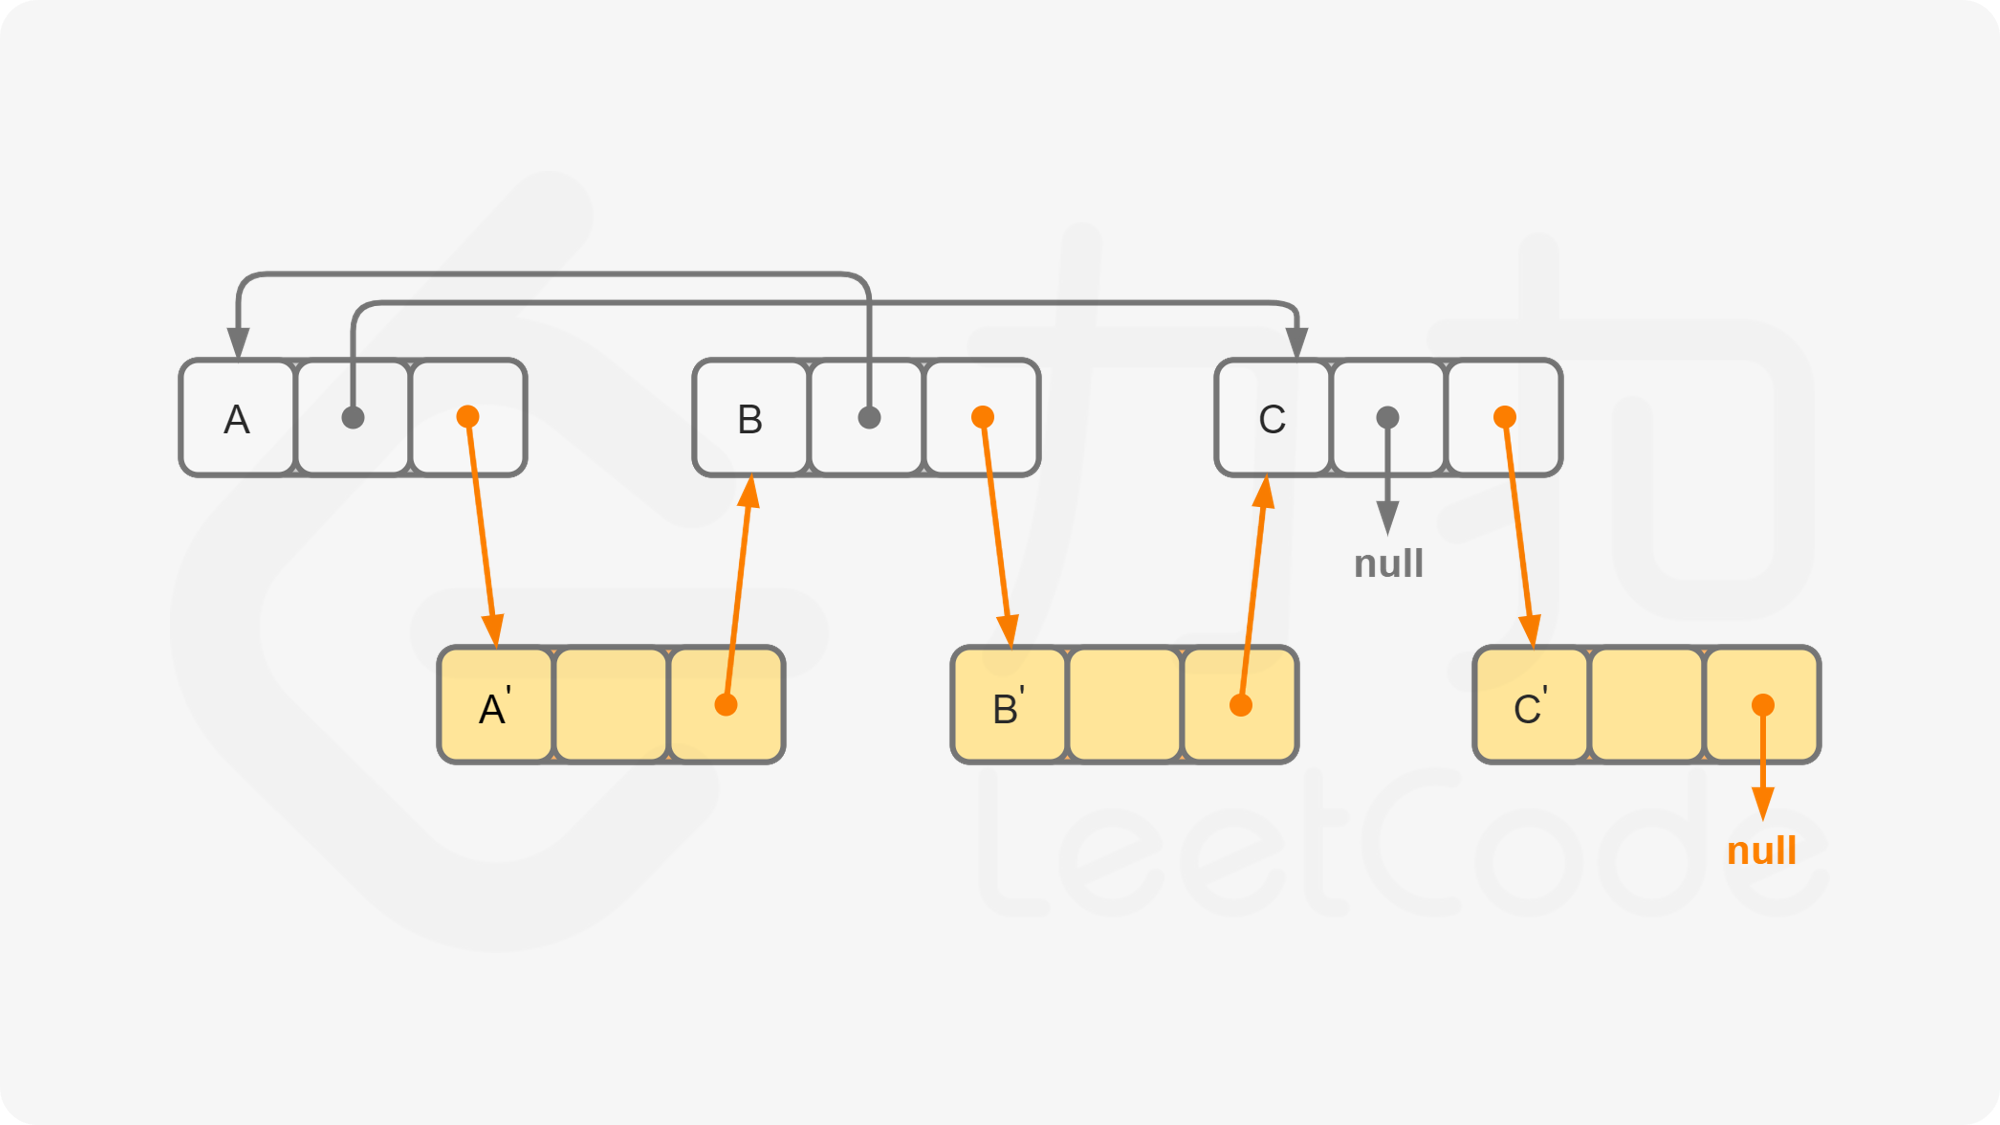
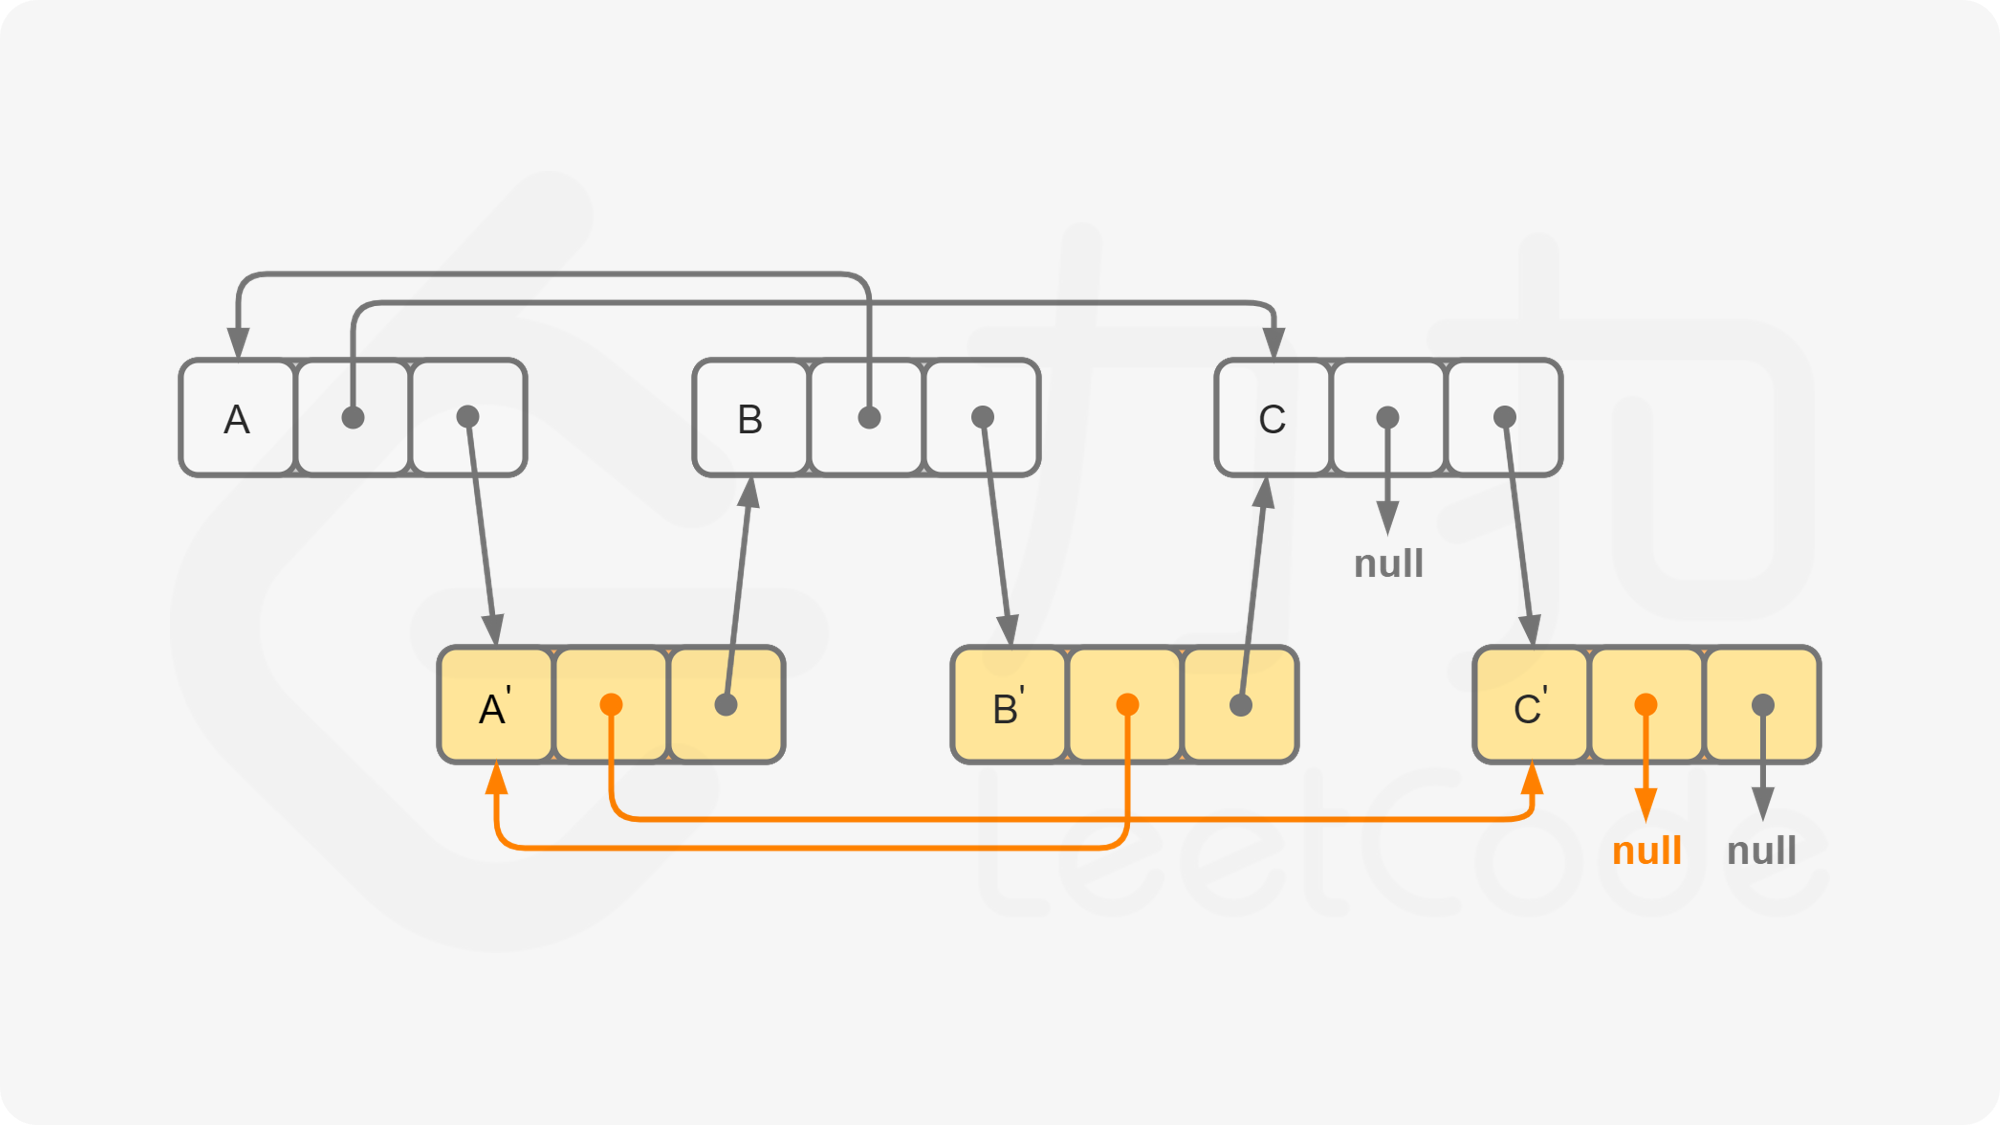
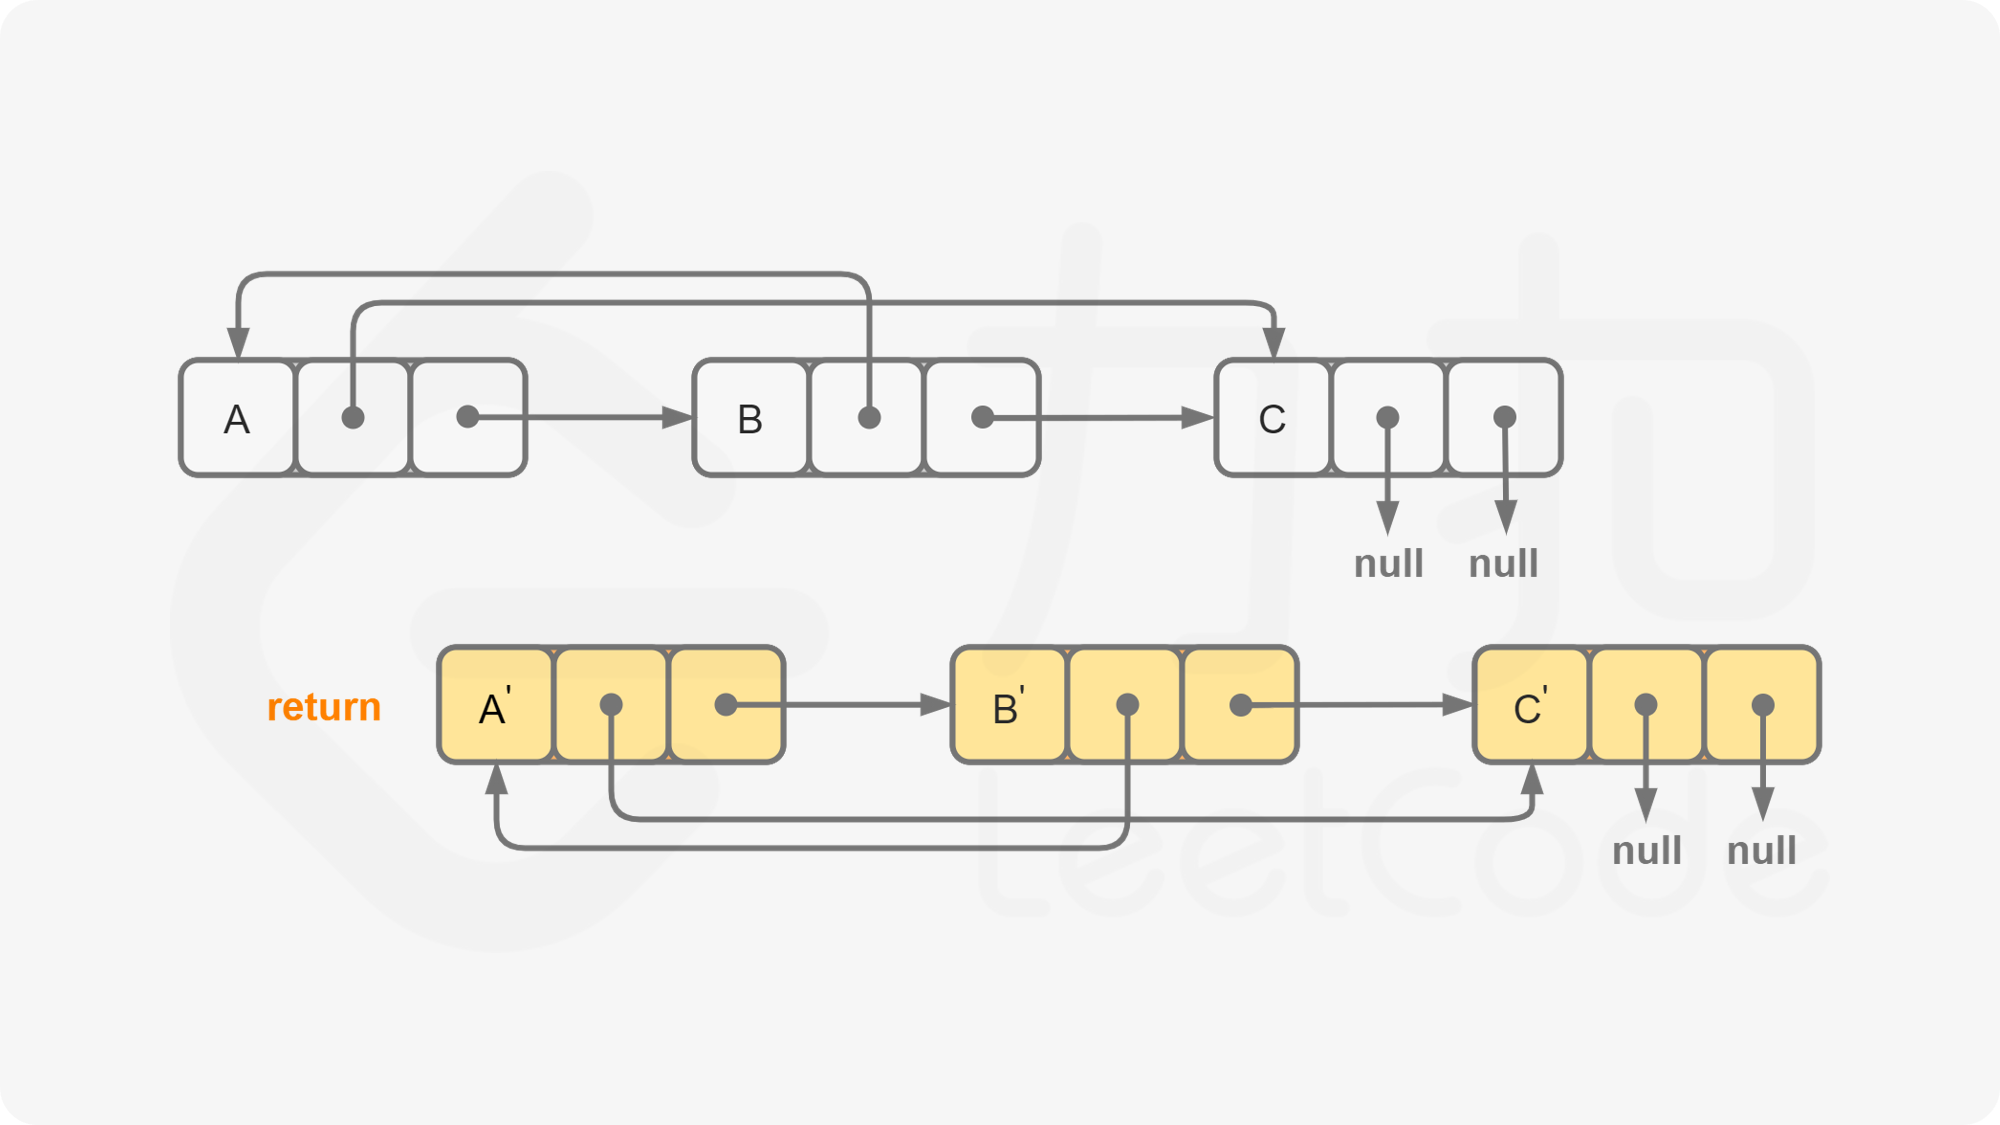
 var copyRandomList = function(head) {
     if (head === null) {
         return null;
     }
     // 1. 拷贝并拆分节点
     for (let node = head; node !== null; node = node.next.next) {
         const nodeNew = new Node(node.val, node.next, null);
         node.next = nodeNew;
     }
     // 2. 对拷贝节点随机指针的赋值
     for (let node = head; node !== null; node = node.next.next) {
         const nodeNew = node.next;
         nodeNew.random = (node.random !== null) ? node.random.next : null;
     }
     const headNew = head.next;
     // 3. 拆分原节点与拷贝节点
     for (let node = head; node !== null; node = node.next) {
         const nodeNew = node.next;
         node.next = node.next.next;
         nodeNew.next = (nodeNew.next !== null) ? nodeNew.next.next : null;
     }
     return headNew;
 };
复杂度分析
- 时间复杂度:O(n),其中 n 是链表的长度。我们只需遍历该链表三次。
- 空间复杂度:O(1)。返回值不计入空间复杂度。
LC 旋转链表
给你一个链表的头节点 head,旋转链表,将链表每个节点向右移动 k个位置。
示例 1:
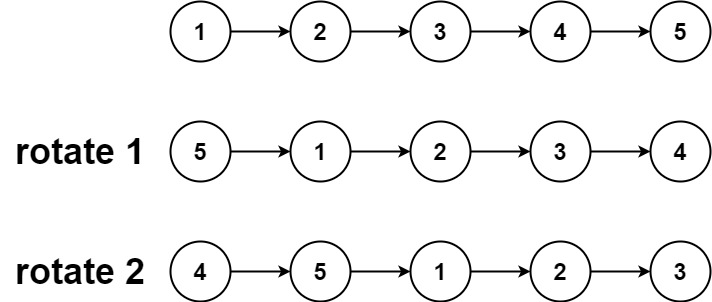
 输入:head = [1,2,3,4,5], k = 2
 输出:[4,5,1,2,3]
示例 2:
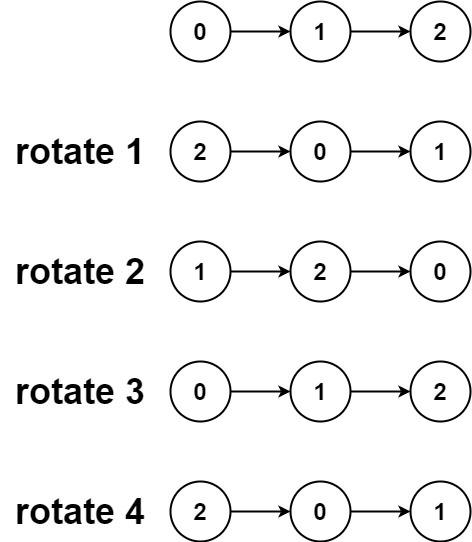
 输入:head = [0,1,2], k = 4
输出:[2,0,1]提示:
- 链表中节点的数目在范围
[0, 500]内 -100 <= Node.val <= 100- 0 <= k <= 2 * 109
题解
方法:闭合为环
var rotateRight = function(head, k) {
if (k === 0 || !head || !head.next) {
return head;
}
let n = 1;
let cur = head;
// 计算链表的长度 n
while (cur.next) {
cur = cur.next;
n++;
}
let add = n - k % n;
if (add === n) {
return head;
}
// 连接成环
cur.next = head;
while (add) {
cur = cur.next;
add--;
}
// 断开
const ret = cur.next;
cur.next = null;
return ret;
};复杂度分析
- 时间复杂度:O(n),最坏情况下,我们需要遍历该链表两次。
- 空间复杂度:O(1),我们只需要常数空间存储若干变量。
