共计 42766 个字符,预计需要花费 107 分钟才能阅读完成。
哈希表图文学
概述
哈希表 是一种使用 哈希函数 组织数据,以支持快速插入和搜索的数据结构。有两种不同类型的哈希表:哈希集合和哈希映射。
哈希集合是集合的实现方式之一,用于存储非重复值。哈希映射是映射的实现之一,用于存储(key, value)键值对。
在 标准模板库 的帮助下,哈希表时 易于使用的。大多数常见语言(如 Java,C++,和 Python)都支持哈希集合和哈希映射。
通过选择合适的哈希函数,哈希表可以在插入和搜索方面展现出 出色的性能。
在本章中,我们将回答以下问题:
- 哈希表的
原理是什么? - 如何
设计哈希表? 如何解决哈希冲突? - 如何使用
哈希集合解决与重复元素相关的问题? - 如何使用
哈希映射解决与滑动窗口相关的问题? - 如何在使用哈希表时设计正确的键?
设计哈希表
在本小节中,我们将讨论哈希表的基本原理。
完成这一小节,你应该能够回答以下问题:
- 哈希表的
原理是什么? - 什么是
哈希冲突? 哪些因素会影响哈希函数? - 了解
哈希集合与哈希映射之间的区别。 - 如何正确使用
标准模板库中的哈希集合及哈希映射? - 在哈希表中,
插入和查找操作的复杂度时多少?
A 哈希表简介
哈希表简介
哈希表 是一种使用哈希函数组织数据的数据结构,它支持快速插入和搜索。
哈希表的原理
哈希表(又称散列表)的原理为:借助 哈希函数,将键映射到存储桶地址。更确切的说:
- 首先开辟一定长度的,具有连续物理地址的桶数组;
- 当我们插入一个新的键时,哈希函数将决定该键应该分配到哪个桶中,并将该键存储在相应的桶中;
- 当我们想要搜索一个键时,哈希表将使用哈希函数来找到对应的桶,并在该桶中进行搜索。
示例
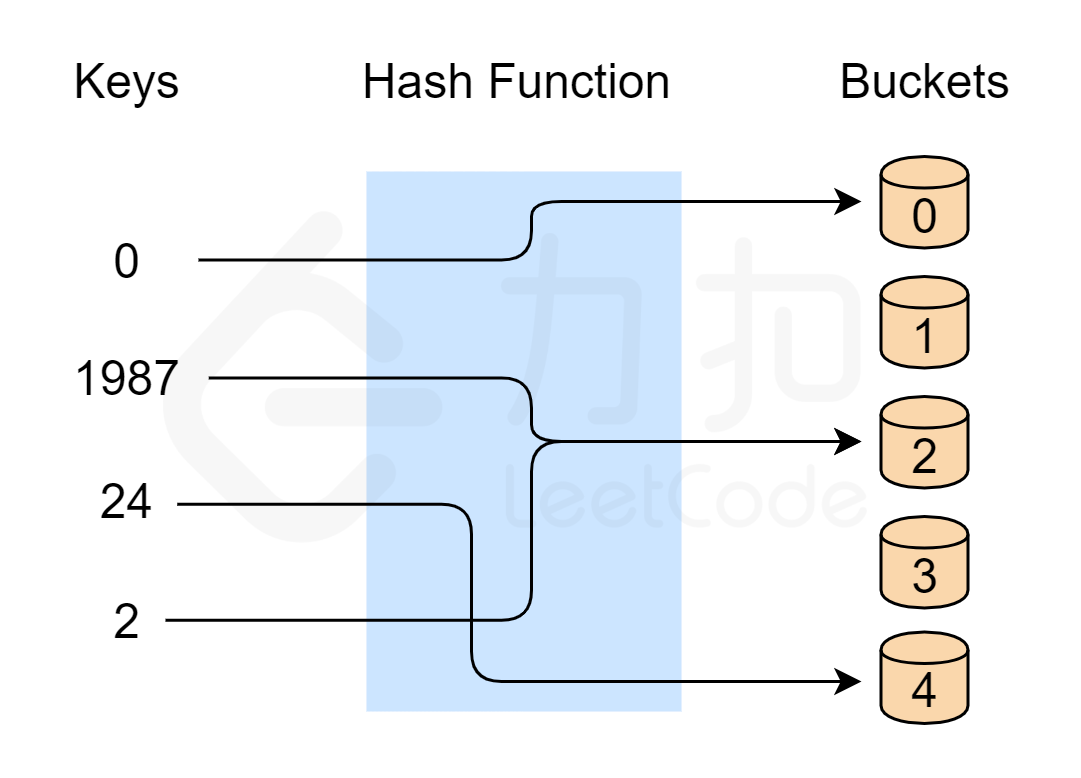
在示例中,我们使用 y = x % 5 作为哈希函数,来完成插入和搜索策略。
- 插入:我们通过哈希函数解析键,将他们映射到相应的桶中。
- 例如,根据哈希函数,
1987将分配给桶2,而24分配给桶4。
- 例如,根据哈希函数,
- 搜索: 我们通过哈希函数解析键,得到桶地址,然后再该存储桶中搜索。
- 如果我们搜索
1987,我们将使用哈希函数将1987映射到2。因此我们在桶2中搜索,我们在那个桶中成功找到了1987。 - 例如,如果我们搜索
23,将映射23到3,并在桶3中搜索。我们发现 23 不在桶 3 中,这意味着 23 不在哈希表中。
- 如果我们搜索
注意到键 1987 和 2 被映射到了同一个桶中,我们称之为 哈希冲突,哈希冲突与哈希函数有关,但又难以避免。有关处理哈希冲突的办法,我们将在下一节详细介绍。
负载因子
负载因子 又叫装填因子,是哈希表的一个重要参数,它反映了哈希表的装满程度。
在上面的例子中,我们发现有的桶处于空闲状态,而有的桶产生了哈希冲突,如何解决这个问题呢?
不难想到,哈希函数是导致冲突的原因之一,更进一步,如果我们增加桶的数量,再采用合适的哈希函数,可使发生冲突的可能性大大减小。
然而,桶的个数太多则会造成大量的空间浪费。比如一个公司的电话号码共有 10 个,每个电话号码是 00000000 到 99999999 内的任意八位数字,如果我们想到一种方案,将每个可能的电话号码作为一个桶,使得电话号码与桶一一对应,则一共需要创建 108 个桶。
实际利用桶的个数 与 桶的总数 的比值,称为负载因子。在这个实例中,负载因子太小甚至接近于 0,这样的方案显然是不现实的。
比较合理的负载因子是 0.7,如果数据量是 7,则会创建 10 个桶,以此类推。随着插入的数据量的增加,计算机会逐渐增加桶的个数,并选择合适的哈希函数,使得数据经过映射之后能均匀的分布在桶中。
A 设计哈希表时的问题
设计哈希表时的问题
理解了什么是哈希表后,我们再来讨论一下设计哈希表时应当注意的几个问题。
1. 哈希函数
哈希数是哈希表中最重要的组件,用于将键映射到特定的桶。在上一篇文章中的示例中,我们使用 y = x % 5 作为散列函数,其中 x 是键值,y 是映射之后对应的桶的索引。
一个好的哈希函数,应当具备以下几个特点:
- 哈希函数的键与桶的对应关系具有确定性。也就是说,对于
key所映射的桶地址,只由key键本身决定,而不由其他因数决定; - 哈希函数不应太过复杂。太过于复杂的哈希函数将导致计算桶地址不能快速完成,从而无法快速定位桶;
- 映射结果的分布应具有均匀性。对于特定的桶空间,我们应尽量保证数据经过哈希函数映射之后,能够均匀的分布在桶的整个地址空间中。
下面是一些哈希函数的示例:
| 键的种类 | 键的范围 | 桶的数量 | 相关哈希函数 |
|---|---|---|---|
| int | 0 ~ 100,000 | 1000 | y = x % 1000 |
| char | ‘a’ ~ ‘z’ | 26 | y = x – ‘a’ |
| arr(int) | arr.length < 10, arr[i] ∈[0, 1] | 1024 | y = x0 * 20 + x1 * 21 + … + x9 * 29 |
| arr(int) | arr.length < 10, arr[i] ∈ [0, 3] | 1024 | y = x0 * 40 + x1 * 41 + … + x4 * 44 |
*在上面的表格中,我们使用 x 表示键,y 表示映射后的结果
理想情况下,完美的哈希函数将是键和桶之间的一对一映射。然而,在大多数情况下,完美的哈希函数并不多见。一般来讲,结果分布越随机,越均匀的哈希函数,他的性能越好。一方面,如果分布过于集中在某些桶中,会加剧这些桶发生冲突的概率;另一方面,剩余的桶由于没有得到有效利用导致空间利用率较低。
2. 冲突解决
一般情况下,哈希函数会起到压缩键的地址空间的作用,设键的地址空间为 S,桶的地址空间为 T,则有 S ≫ T。
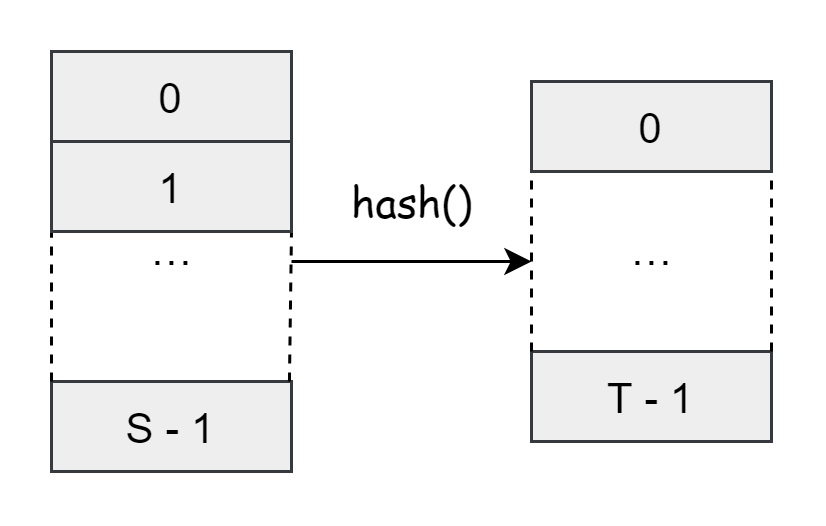
因此,经过映射之后,不同的数据会不可避免的分配到同一个桶中,这时便产生了冲突。例如,在我们之前的哈希函数 y = x % 5 中,1987 和 2 都分配给了桶 2,这是一个冲突。
为了避免哈希冲突,我们简要介绍几种解决冲突的办法。
线性试探法
线性试探法属于开放定址法的一种,除此之外,开放定址法还包括二次探测法、双重哈希法等。
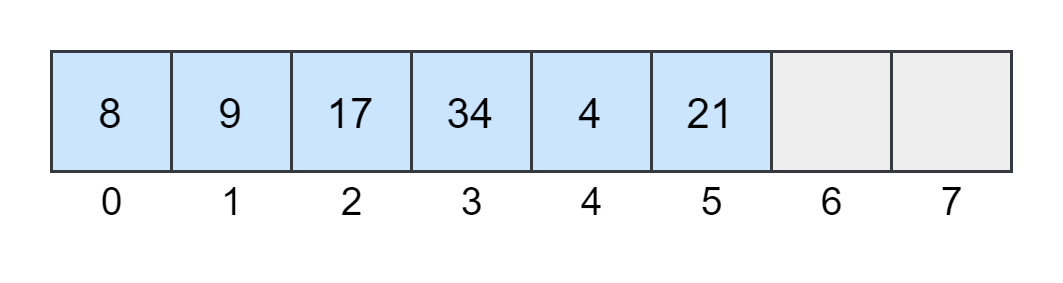
所谓线性试探法,就是当插入键 key 时,如果发现桶单元 bucket[hash(key)] 已经被占用,则向下线性寻找,直到找到可以使用的空桶。具体来说,经过第 i 次试探之后,桶单元应为:
bucket[(hash(key) + i) mod M], i = 1, 2, 3...
例如对于键的集合为 [8, 9, 21, 17, 34, 21, 4],哈希函数为 y = x % 8,集合中的前三个数 8, 9, 21,他们分别映射到 0, 1, 5 号桶中。
而对于第四个数 17,他本应映射到 1 号桶中,由于 1 号桶中已经保存了 9,因此将 17 保存在下一个空桶 —— 2 号桶中。同理,34 余数为 2,会保存在 3 号桶中。
链地址法
解决冲突的另一种办法是将桶内产生冲突的键串联成一个链表。仍然以前一个方法中的冲突为例,实现方式如下图所示:
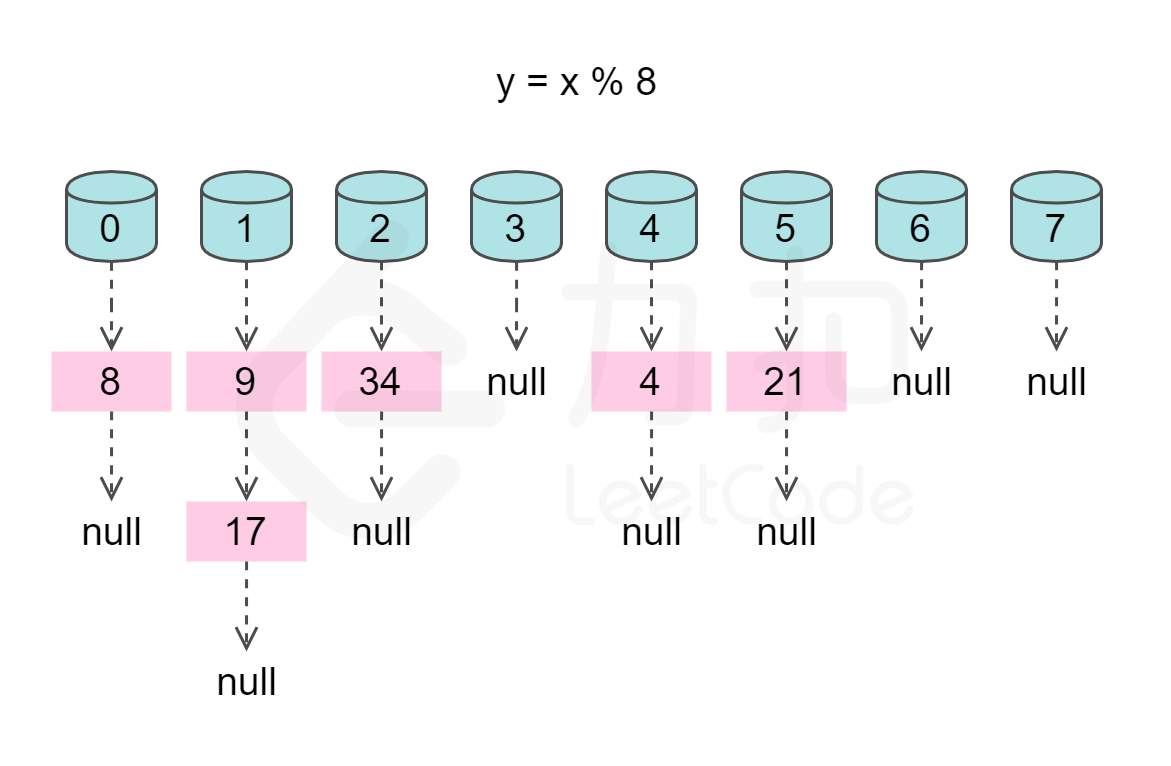
与线性探测法类似,发生冲突时,由于都需要进行线性查找,因此会导致查找的成本增加。
再哈希法
再哈希法比较典型的应用是双重哈希法,即发生冲突时,通过使用另一个哈希函数来避免冲突。不难想到,另一个哈希函数在构造时,需要具备一些约束条件才能避免再次冲突。
然而,双重哈希法同样存在一些问题:
- 与线性试探法相比,双重哈希法会消耗较多的时间。
- 在双重哈希法中,删除会使问题变复杂,如果逻辑删除数量太多,则应重新构造哈希表。
公共溢出区法
顾名思义,公共溢出区法就是建立另一个哈希表 dict_overflow 作为公共溢出区,当发生冲突时则将该键保存在该哈希表中。
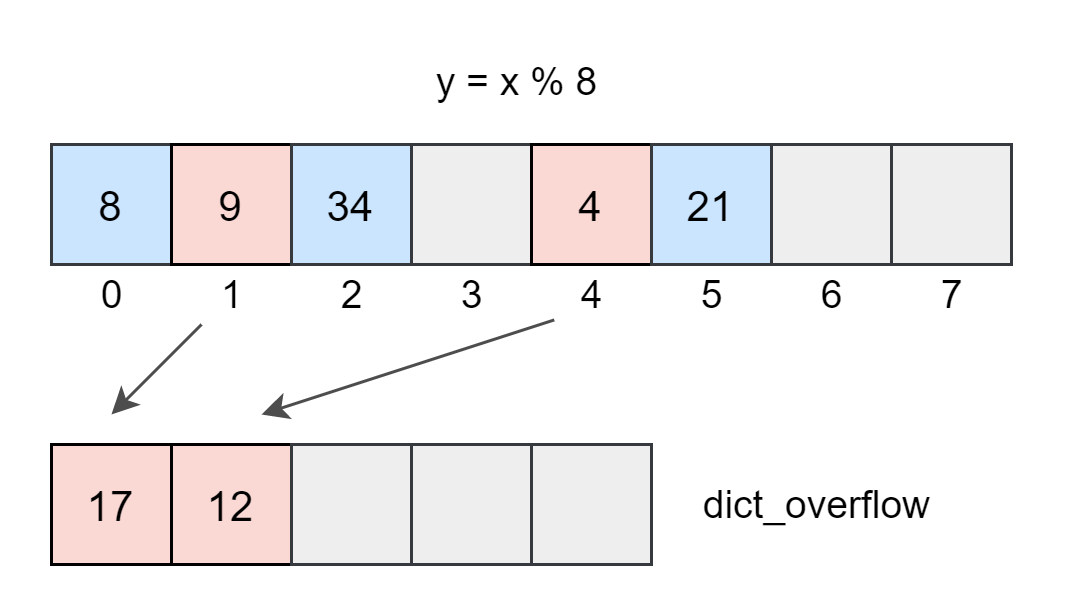
如图所示,若查找的键发生冲突,则在公共溢出区进行线性查找。
到目前为止,你应该对哈希表的概念有了基本的认识。接下来,我们将提供一些相关练习,来帮助你进一步认识哈希表。
LC 设计哈希集合
不使用任何内建的哈希表库设计一个哈希集合(HashSet)。
实现 MyHashSet 类:
void add(key)向哈希集合中插入值key。bool contains(key)返回哈希集合中是否存在这个值key。void remove(key)将给定值key从哈希集合中删除。如果哈希集合中没有这个值,什么也不做。
示例:
输入:
["MyHashSet", "add", "add", "contains", "contains", "add", "contains", "remove", "contains"]
[[], [1], [2], [1], [3], [2], [2], [2], [2]]
输出:
[null, null, null, true, false, null, true, null, false]

解释:
MyHashSet myHashSet = new MyHashSet();
myHashSet.add(1);      // set = [1]
myHashSet.add(2);      // set = [1, 2]
myHashSet.contains(1); // 返回 True
myHashSet.contains(3); // 返回 False ,(未找到)
myHashSet.add(2);      // set = [1, 2]
myHashSet.contains(2); // 返回 True
myHashSet.remove(2);   // set = [1]
myHashSet.contains(2); // 返回 False ,(已移除)提示:
- 0 <= key <= 106
- 最多调用 104 次
add、remove和contains
题解
方法一:链地址法
查看思路
设哈希表的大小为 base,则可以设计一个简单的哈希函数:hash(x) = x mod base。我们开辟一个大小为 base 的数组,数组的每个位置是一个链表。当计算出哈希值之后,就插入到对应位置的链表当中。
由于我们使用整除法作为哈希函数,为了尽可能避免冲突,应当将 base 取为一个质数。在这里,我们取 base = 769。
class MyHashSet {
  private static final int BASE = 769;
  private LinkedList[] data;

  // 初始化数据结构
  public MyHashSet() {
    data = new LinkedList[BASE];
    for (int i = 0; i < BASE; ++i) {
      data[i] = new LinkedList<Integer>();
    }
  }

  public void add(int key) {
    int h = hash(key);
    Iterator<Integer> iterator = data[h].iterator();
    while (iterator.hasNext()) {
      Integer element = iterator.next();
      if (element == key) {
        return;
      }
    }
    data[h].offerLast(key);
  }

  public void remove(int key) {
    int h = hash(key);
    // 获取迭代器
    Iterator<Integer> iterator = data[h].iterator();
    while (iterator.hasNext()) {
      Integer element = iterator.next();
      if (element == key) {
        data[h].remove(element);
        return;
      }
    }
  }

  public boolean contains(int key) {
    int h = hash(key);
    Iterator<Integer> iterator = data[h].iterator();
    while (iterator.hasNext()) {
      Integer element = iterator.next();
      if (element == key) {
        return true;
      }
    }
    return false;
  }

  public static int hash(int key) {
    return key % BASE;
  }
}复杂度分析
- 时间复杂度:O(n/b)。其中 n 为哈希表中的元素数量,b 为链表的数量。假设哈希值是均匀分布的,则每个链表大概长度为 n/b。
- 空间复杂度:O(n + b)。
LC 设计哈希映射
不使用任何内建的哈希表库设计一个哈希映射(HashMap)。
实现 MyHashMap 类
MyHashMap()用空映射初始化对象void put(int key, int value)向 HashMap 插入一个键值对 (key, value)。如果key已经存在于映射中,则更新其对应的值value。int get(int key)返回特定的key所映射的value;如果映射中不包含key的映射,返回-1。void remove(key)如果映射中存在key的映射,则移除key和它所对应的value。
示例:
输入:
["MyHashMap", "put", "put", "get", "get", "put", "get", "remove", "get"]
[[], [1, 1], [2, 2], [1], [3], [2, 1], [2], [2], [2]]
输出:
[null, null, null, 1, -1, null, 1, null, -1]

解释:
MyHashMap myHashMap = new MyHashMap();
myHashMap.put(1, 1); // myHashMap 现在为 [[1,1]]
myHashMap.put(2, 2); // myHashMap 现在为 [[1,1], [2,2]]
myHashMap.get(1);    // 返回 1 ,myHashMap 现在为 [[1,1], [2,2]]
myHashMap.get(3);    // 返回 -1(未找到),myHashMap 现在为 [[1,1], [2,2]]
myHashMap.put(2, 1); // myHashMap 现在为 [[1,1], [2,1]](更新已有的值)
myHashMap.get(2);    // 返回 1 ,myHashMap 现在为 [[1,1], [2,1]]
myHashMap.remove(2); // 删除键为 2 的数据,myHashMap 现在为 [[1,1]]
myHashMap.get(2); // 返回 -1(未找到),myHashMap 现在为 [[1,1]]提示:
- 0 <= key, value <= 106
- 最多调用 104 次
put、get和remove方法
题解
方法一:链地址法
class MyHashMap {
  private class Pair {
    private int key;
    private int value;

    public Pair (int key, int value) {
      this.key = key;
      this.value = value;
    }

    public int getKey() {
      return key;
    }

    public int getValue() {
      return value;
    }

    public void setValue(int value) {
      this.value = value;
    }
  }

  private static final int BASE = 769;
  private LinkedList[] data;

  // 初始化数据结构
  public MyHashMap() {
    data = new LinkedList[BASE];
    for (int i = 0; i < BASE; ++i) {
      data[i] = new LinkedList<Pair>();
    }
  }

  public void put(int key, int value) {
    int h = hash(key);
    Iterator<Pair> iterator = data[h].iterator();
    while (iterator.hasNext()) {
      Pair pair = iterator.next();
      if (pair.getKey() == key) {
        pair.setValue(value);
        return;
      }
    }
    data[h].offerLast(new Pair(key, value));
  }

  public int get(int key) {
    int h = hash(key);
    Iterator<Pair> iterator = data[h].iterator();
    while (iterator.hasNext()) {
      Pair pair = iterator.next();
      if (pair.getKey() == key) {
        return pair.value;
      }
    }
    return -1;
  }

  public void remove(int key) {
    int h = hash(key);
    Iterator<Pair> iterator = data[h].iterator();
    while (iterator.hasNext()) {
      Pair pair = iterator.next();
      if (pair.key == key) {
        data[h].remove(pair);
        return;
      }
    }
  }

  private static int hash(int key) {
    return key % BASE;
  }
}
复杂度分析
- 时间复杂度:O(n/b)。其中 n 为哈希表中的元素数量,b 为链表的数量。假设哈希值是均匀分布的,则每个链表大概长度为 n/b。
- 空间复杂度:O(n + b)。
A 设计哈希表 – 解决方案
设计哈希表 – 解决方案
这里分别给出设计哈希集合和哈希映射的解决方案。为了解决哈希冲突,我们使用 二维数组 来实现哈希集合,数组中的每个元素都可以看做一个桶,而在每个桶中又包含了一个一维数组,以便保存产生冲突的键。
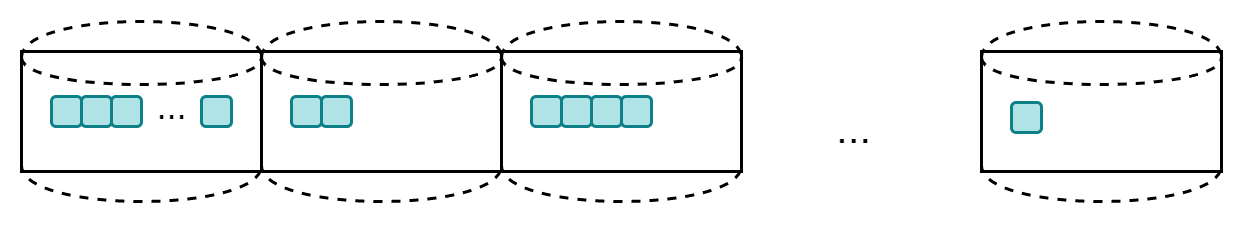
哈希集合
class MyHashSet {
  private final int MAX_LEN = 100000; // 初始化桶的数量
  private List<Integer>[] set; // 使用数组实现哈希集合

  // 返回对应的桶的索引
  private int getIndex(int key) {
    return key % MAX_LEN;
  }

  // 在特定的桶中搜索键,如果该键不存在则返回 -1
  private int getPos(int key, int index) {
    // 每个桶中包含一个列表
    List<Integer> temp = set[index];
    if (temp == null) {
      return -1;
    }
    // 遍历所有桶中的元素来寻找特定的键
    for (int i = 0; i < temp.size(); ++i) {
      if (temp.get(i) == key) {
        return i;
      }
    }
    return -1;
  }

  public MyHashSet() {
    set = (List<Integer>[]) new ArrayList[MAX_LEN];
  }

  public void add(int key) {
    int index = getIndex(key);
    int pos = getPos(key, index);
    if (pos < 0) {
      // 如果键不存在,则添加
      if (set[index] == null) {
        set[index] = new ArrayList<Integer>();
      }
      set[index].add(key);
    }
  }

  public void remove(int key) {
    int index = getIndex(key);
    int pos = getPos(key, index);
    if (pos >= 0) {
      // 如果键存在,则删除
      set[index].remove(pos);
    }
  }

  public boolean contains(int key) {
    int index = getIndex(key);
    int pos = getPos(key, index);
    return pos >= 0;
  }
}
哈希映射
class MyHashMap {
  private final int MAX_LEN = 100000; // 初始化桶的数量
  private List<Pair<Integer, Integer>>[] map; // 使用数组实现哈希集合

  // 返回指定桶的索引
  private int getIndex(int key) {
    return key % MAX_LEN;
  }

  // 在特定的桶中寻找 key,如果不存在则返回 -1
  private int getPos(int key, int index) {
    // 每个桶中包含一个数组
    List<Pair<Integer, Integer>> temp = map[index];
    if (temp == null) {
      return -1;
    }
    // 遍历所有元素,在桶中寻找 key
    for (int i = 0; i < temp.size(); ++i) {
      if (temp.get(i).getKey() == key) {
        return i;
      }
    }
    return -1;
  }

  public MyHashMap() {
    map = (List<Pair<Integer, Integer>>[]) new ArrayList[MAX_LEN];
  }

  public void put(int key, int value) {
    int index = getIndex(key);
    int pos = getPos(key, index);
    if (pos < 0) {
      // 如果不存在,则添加键值对 (key, value)
      if (map[index] == null) {
        map[index] = new ArrayList<Pair<Integer, Integer>>();
      }
      map[index].add(new Pair(key, value));
    }
    else {
      // 如果键存在,更新 value
      map[index].set(pos, new Pair(key, value));
    }
  }

  // 返回键的映射结果,如果不存在映射关系则返回 -1
  public int get(int key) {
    int index = getIndex(key);
    int pos = getPos(key, index);
    if (pos < 0) {
      return -1;
    }
    else {
      return map[index].get(pos).getValue();
    }
  }

  // 如果存在映射关系,则移除键值对
  public void remove(int key) {
    int index = getIndex(key);
    int pos = getPos(key, index);
    if (pos >= 0) {
      map[index].remove(pos);
    }
  }
}
进一步探索
我们来看看 “删除” 操作,找到元素的位置之后,我们需要从数组中 “删除” 元素。
这是由数组本身的特点决定的。我们在之前对数组的 “删除” 操作进行了解释,即删除第 i 个元素,需要将后面的 n - i 个元素向前移动一个位置。其中,n 为数组的长度。
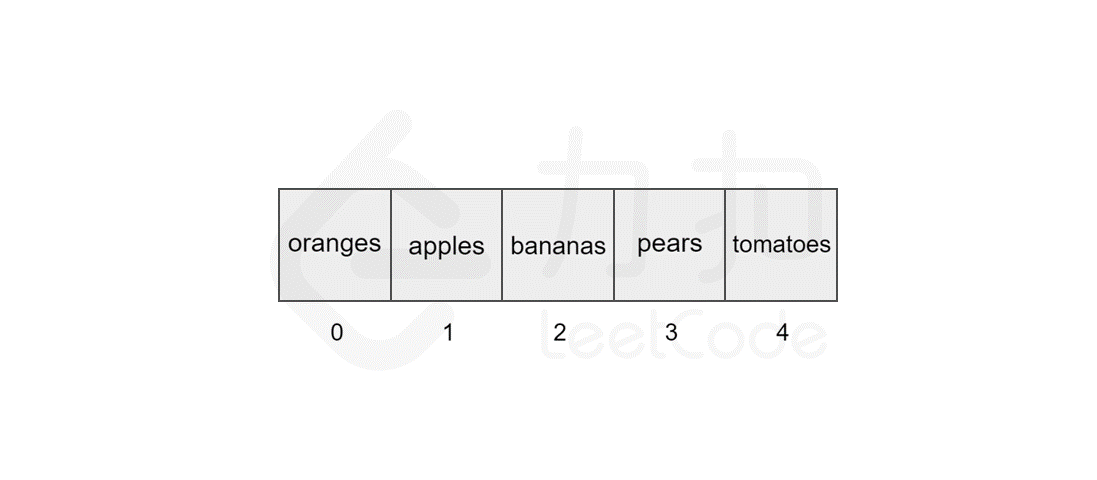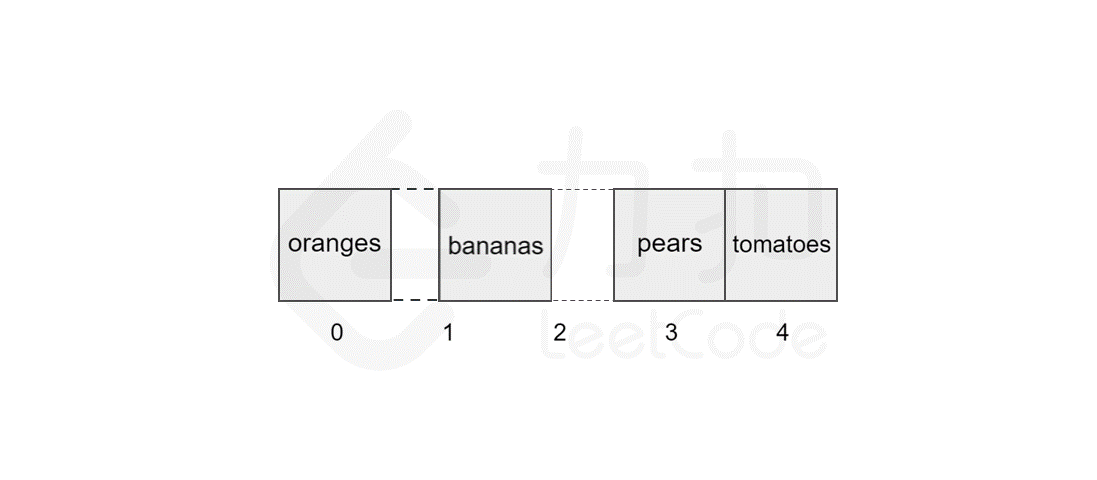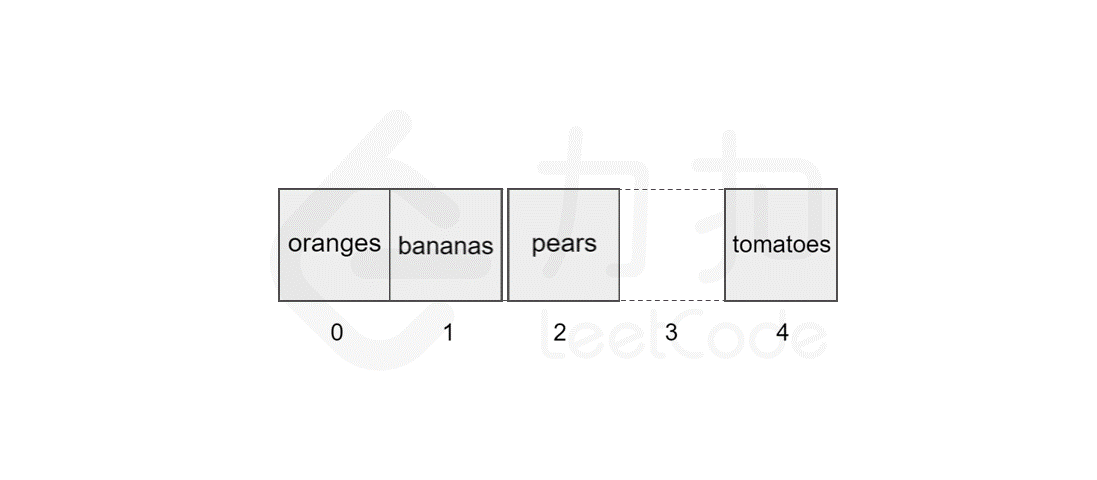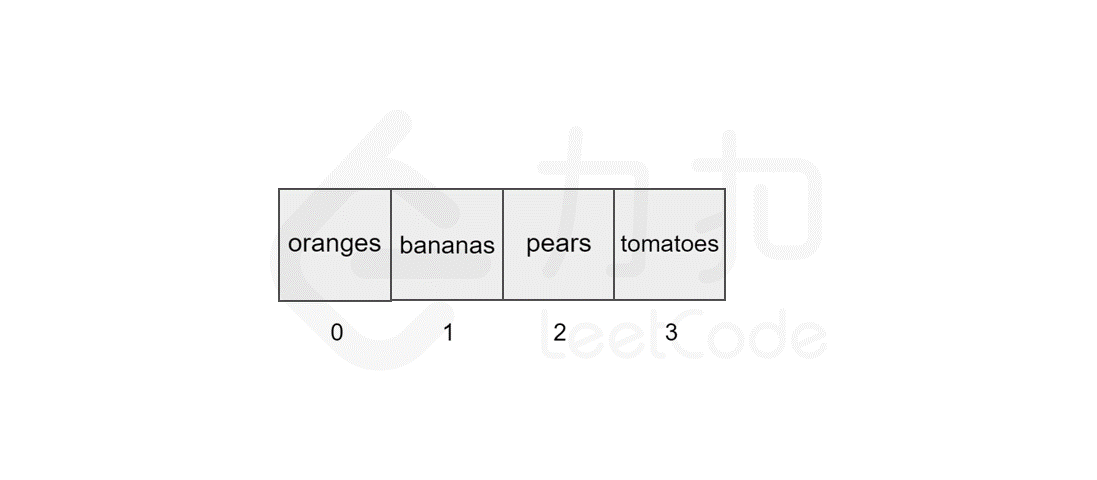
考虑 i 取不同值的情况:
- 删除末尾元素,移动
0次; - 删除开头元素,移动
n - 1次。
平均而言, 我们将要移动的次数为:
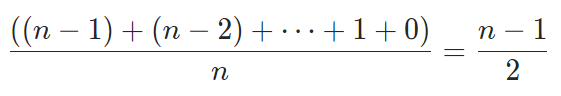
因此,找到待删除元素后,从数组中删除元素的时间复杂度将为 O(n)。
以下两种方案可以将时间复杂度从 O(n) 降低到 O(1)。
- 交换我们可以使用一种巧妙的策略。首先,用存储桶中的最后一个元素交换要移除的元素。然后删除最后一个元素。通过这种方法,我们成功的在 O(1) 的时间复杂度中去除了元素。
- 链表实现此目标的另一种方法是使用链表而不是数组列表。通过这种方式,我们可以在不修改数组中元素顺序的情况下删除元素。该策略时间复杂度为 O(1)。
然而,以上两种策略只改进了 找到元素之后 进行删除的时间复杂度,而对于整个删除操作,由于先要进行线性查找,所以时间复杂度仍为 O(n), n 为桶的大小。
要进一步改进此问题,我们可以使用 平衡二叉搜索树 作为桶,当进行删除操作时,则可以使用二分查找来快速定位被删除元素,使得删除操作的时间复杂度由 O(n) 减小为 O(log n),n 为桶的大小。
A 复杂度分析 – 哈希表
复杂度分析 – 哈希表
在本文中,我们将讨论哈希表的性能。
复杂度分析
对于哈希表,插入和搜索的平均时间复杂度为 O(1),空间复杂度为 O(n)。下面将进一步分析。
我们知道哈希表在设计的过程中总要考虑冲突问题,这是因为不发生冲突几乎是不可能的。
例如我们经常谈到的 —— “在 50 人中,至少有 2 人同一天生日的概率是 97%”,这就意味着,如果我们将 365 天看作 365 个桶,每个桶保存一个人的生日,那么发生冲突概率则高达 97%,而此时的装填因子仅为
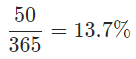
也就是说,为了使插入和查询的时间复杂度达到 O(1),我们可以选择牺牲空间复杂度,增加桶的个数,使其不发生冲突。然而经过分析,我们发现即使装填因子很低的情况下,冲突仍然难以避免。因此就有了前面文章中关于冲突解决的各种办法,本质上是为了达到时间与空间的平衡。
既然如此,插入和搜索的时间复杂度就不会总是 O(1),它将取决于桶内部存储发生冲突的键的方式。
- 如果桶内使用
链表或者数组,则最坏情况下,插入和搜索的时间复杂度为 O(n); - 如果桶内使用
高度平衡的二叉树来保存键,则最坏的情况下,插入和搜索的时间复杂度为 O(log n)。
其中,n 为桶的大小。且无论使用以上哪种方式,平均时间复杂度 均为 O(1)。
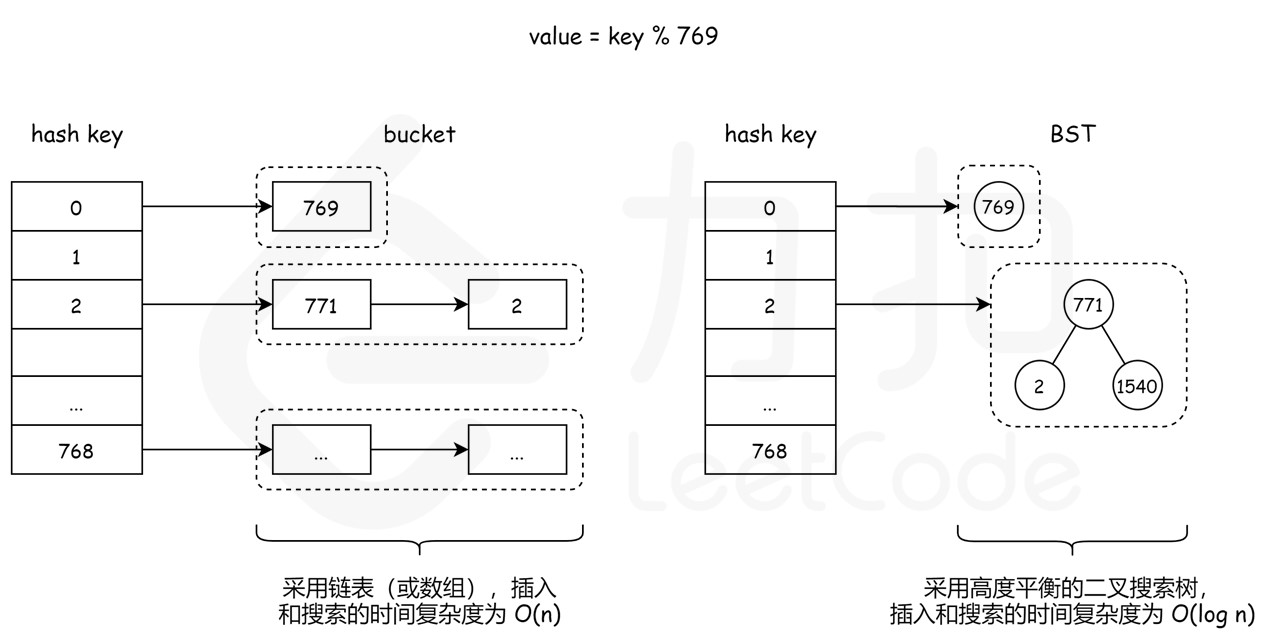
对于 空间复杂度,如果总共有 M 个键,那么至少需要分配 M 个桶,在实际的编程语言中,有各自的动态扩容机制,但总的来说,桶的个数与键呈线性关系。空间复杂度为 O(M)。
实际应用 – 哈希集合
上一章节中,我们对哈希集合和哈希映射的概念及复杂度进行了讲解。
本章节中,我们将讨论如何在 标准模板库 的帮助下使用哈希集合以及哈希集合的应用场景。
A 哈希集合的操作
哈希集合是集合的实现方式之一,它是一种存储 不重复值 的数据结构。
你可以通过下面的实例对相关操作进行练习。
public class Main {
    public static void main(String[] args) {
        // 1. 初始化哈希集合
        Set<Integer> hashSet = new HashSet<>();
        // 2. 新增键
        hashSet.add(3);
        hashSet.add(2);
        hashSet.add(1);
        // 3. 删除键
        hashSet.remove(2);
        // 4. 查询键是否包含在哈希集合中
        if (!hashSet.contains(2)) {
            System.out.println("键 2 不在哈希集合中");
        }
        // 5. 哈希集合的大小
        System.out.println("哈希集合的大小为: " + hashSet.size());
        // 6. 遍历哈希集合
        for (Integer i : hashSet) {
            System.out.print(i + " ");
        }
        System.out.println("在哈希集合中");
        // 7. 清空哈希集合
        hashSet.clear();
        // 8. 查看哈希集合是否为空
        if (hashSet.isEmpty()) {
            System.out.println("哈希集合为空!");
        }
    }
}
A 使用哈希集合查重
我们知道,由于哈希集合中的元素是 不重复的,因此可以使用哈希集合来判断是否包含重复元素。
实例
让我们来看一个例子:
给定一个整数数组,判断该数组中是否包含重复元素。
这是一个典型的问题,用来判断某个数据结构中是否包含重复元素,或者对某个数据结构进行 去重 的操作。解决这类问题的简单思路是遍历该数据结构,并将值插入到哈希集合中。如果该值已经存在与哈希集合中,表明发生了重复。
下面是伪代码模板:
/*
 * 使用哈希集合寻找重复元素的模板
 */
boolean findDuplicates(List<Type>& keys) {
    // 将 type 替换为 keys 的实际类型
    Set<Type> hashset = new HashSet<>();
    for (Type key : keys) {
        if (hashset.contains(key)) {
            return true;
        }
        hashset.insert(key);
    }
    return false;
}
LC 存在重复元素
给你一个整数数组 nums。如果任一值在数组中出现 至少两次,返回 true;如果数组中每个元素互不相同,返回 false。
示例 1:
输入:nums = [1,2,3,1]
输出:true
示例 2:
输入:nums = [1,2,3,4]
输出:false
示例 3:
输入:nums = [1,1,1,3,3,4,3,2,4,2]
输出:true提示:
- 1 <= nums.length <= 105
- -109 <= nums[i] <= 109
题解
class Solution {
    public boolean containsDuplicate(int[] nums) {
        Set<Integer> hashset = new HashSet<Integer>();
        for (int num : nums) {
            if (hashset.contains(num)) {
                return true;
            }
            hashset.add(num);
        }
        return false;
    }
}
复杂度分析
- 时间复杂度:O(N),其中 N 为数组的长度。
- 空间复杂度:O(N),其中 N 为数组的长度。
LC 只出现一次的数字
给你一个 非空 整数数组 nums,除了某个元素只出现一次以外,其余每个元素均出现两次。找出那个只出现了一次的元素。
你必须设计并实现线性时间复杂度的算法来解决此问题,且该算法只使用常量额外空间。
示例 1:
输入:nums = [2,2,1]
输出:1
示例 2:
输入:nums = [4,1,2,1,2]
输出:4
示例 3:
输入:nums = [1]
输出:1提示:
- 1 <= nums.length <= 3 * 104
- -3 * 104 <= nums[i] <= 3 * 104
- 除了某个元素只出现一次以外,其余每个元素均出现两次。
题解
class Solution {
  public int singleNumber(int[] nums) {
    Map<Integer, Integer> map = new HashMap<>();
    for (Integer i : nums) {
      Integer count = map.get(i);
      count = count == null ? 1 : ++count;
      map.put(i, count);
    }
    for (Integer i : map.keySet()) {
      Integer count = map.get(i);
      if (count == 1) {
        return i;
      }
    }
    return -1;
  }
}
复杂度分析
- 时间复杂度:O(n)
- 空间复杂度:O(n)
LC 两个数组的交集
给定两个数组 nums1 和 nums2,返回他们的交集。输出结果中的每个元素一定是 唯一 的。我们可以 不考虑输出结果的顺序。
示例 1:
输入:nums1 = [1,2,2,1], nums2 = [2,2]
输出:[2]
示例 2:
输入:nums1 = [4,9,5], nums2 = [9,4,9,8,4]
输出:[9,4]
解释:[4,9] 也是可通过的提示:
1 <= nums1.length, nums2.length <= 10000 <= nums1[i], nums2[i] <= 1000
题解
class Solution {
    public int[] intersection(int[] nums1, int[] nums2) {
        Set<Integer> set1 = new HashSet<Integer>();
        Set<Integer> set2 = new HashSet<Integer>();
        for (int num : nums1) {
            set1.add(num);
        }
        for (int num : nums2) {
            set2.add(num);
        }
        return getIntersection(set1, set2);
    }

    public int[] getIntersection(Set<Integer> set1, Set<Integer> set2) {
        if (set1.size() > set2.size()) {
            return getIntersection(set2, set1);
        }
        Set<Integer> intersectionSet = new HashSet<Integer>();
        for (int num : set1) {
            if (set2.contains(num)) {
                intersectionSet.add(num);
            }
        }
        int[] intersection = new int[intersectionSet.size()];
        int index = 0;
        for (int num : intersectionSet) {
            intersection[index++] = num;
        }
        return intersection;
    }
}
复杂度分析
- 时间复杂度:O(m + n),其中 m 和 n 分别是两个数组的长度。使用两个集合分别存储两个数组中的元素需要 O(m + n) 的时间,遍历较小的集合并判断元素是否在另一个集合中需要 O(min(m,n)) 的时间,因此总时间复杂度是 O(m + n)。
- 空间复杂度: O(m + n),其中 m 和 n 分别是两个数组的长度。空间复杂度主要取决于两个集合。
LC 快乐数
编写一个算法来判断一个数 n 是不是快乐数。
快乐数 定义为:
- 对于一个正整数,每一次将该数替换为它每个位置上的数字的平方和。
- 然后重复这个过程知道这个数变为 1,也可能是 无限循环 但始终变不到 1。
- 如果这个过程 结果为 1,那么这个数就是快乐数。
如果 n 是 快乐数 就返回 true;不是,则返回 false。
示例 1:
输入:n = 19
输出:true
解释:
12 + 92 = 82
82 + 22 = 68
62 + 82 = 100
12 + 02 + 02 = 1
示例 2:
输入:n = 2
输出:false提示:
- 1 <= n <= 231 – 1
题解
方法一:用哈希集合检测循环
查看解析
根据我们的探索,猜测会有以下三种可能
- 最终会得到1。
- 最终会进入循环。
- 值会越来越大,最后接近无穷大。
第三个情况比较难以检测和处理。我们如何知道它会继续变大,而不是最终得到 1 呢?我们可以想一想,每一位数字的下一位数是多少。
| Digits | Largest | Next |
|---|---|---|
| 1 | 9 | 81 |
| 2 | 99 | 162 |
| 3 | 999 | 243 |
| 4 | 9999 | 324 |
| 13 | 9999999999999 | 1053 |
对于 3 位数的数字,它不可能大于 243,。这意味着它要么被困在 243 以下的循环内,要么跌到 1。4 位或 4 位以上的数字在每一步都会丢失一位,直到降到 3 位为止。所以我们知道,最坏的情况下,算法可能会在 243 以下的所有数字上循环,然后回到它已经到达过的一个循环或者回到 1。但它不会无限期的进行下去,所以我们排除第三种选择。
class Solution {
    // 循环得出各个位数的平方后加入totalSum中
    private int getNext(int n) {
        int totalSum = 0;
        while (n > 0) {
            int d = n % 10;
            n = n / 10;
            totalSum += d * d;
        }
        return totalSum;
    }

    public boolean isHappy(int n) {
        Set<Integer> seen = new HashSet<Integer>();
        while (n != 1 && !seen.contains(n)) {
            seen.add(n);
            n = getNext(n);
        }
        return n == 1;
    }
}
复杂度分析
- 时间复杂度: O(243 * 3 + logn + loglogn + logloglogn)… = O(logn)。
- 查找给定数字的下一个值的成本为 O(logn),因为我们正在处理数字中的每位数字,而数字中的位数由 logn 给定。
- 要计算出总的时间复杂度,我们需要仔细考虑循环中有多少个数字,他们有多大。
- 我们在上面确定,一旦一个数字低于 243,它就不可能回到 243 以上。因此我们可以用 243 以下最长循环的长度来代替 243,不过因为常数无关紧要,所以不会担心它。
- 对于高于 243 的 n,我们需要考虑循环中每个数高于 243 的成本。通过数学运算,可以证明在最坏的情况下,成本将是 O(logn) + O(loglogn) + O(logloglogn)…。
- 空间复杂度: O(logn)。与时间复杂度密切相关的衡量是我们放入哈希集合中的数字以及他们有多大的指标。对于足够大的 n,大部分空间将由 n 本身占用。我们可以很容易的优化到 O(243 * 3) = O(1),方法是只保存集合中小于 243 的数字,因为对于较高的数字,无论如何都不能返回到他们。
实际应用 – 哈希映射
我们知道,哈希集合主要用来存储 不重复元素,而 哈希映射 可以使用 (key, value) 键值对。
本章节中,我们将讨论哈希映射的相关问题,主要有以下两个方面:
- 根据值的结构不同设计不同的
(key, value)键值对; - 利用哈希表解决与
滑动窗口相关的问题。
A 哈希表的操作
哈希表 是用来存储 (key, value) 键值对的一种实现。
下面的实例中,我们提供了有关哈希表的一些操作,如果你对这些操作不熟悉,可以浏览下方代码进行学习。
public class Main {
    public static void main(String[] args) {
        // 1. 初始化哈希表
        Map<Integer, Integer> hashmap = new HashMap<>();
        // 2. 插入一个新的(键,值)对
        hashmap.putIfAbsent(0, 0);
        hashmap.putIfAbsent(2, 3);
        // 3. 插入一个新的(键,值)对,或者更新值
        hashmap.put(1, 1);
        hashmap.put(1, 2);
        // 4. 获得特定键对应的值
        System.out.println("键 1 对应的值为: " + hashmap.get(1));
        // 5. 删除键
        hashmap.remove(2);
        // 6. 检查键是否存在于哈希表中
        if (!hashmap.containsKey(2)) {
            System.out.println("键 2 不在哈希表中");
        }
        // 7. 哈希表的大小
        System.out.println("哈希表的大小为: " + hashmap.size());
        // 8. 遍历哈希表
        for (Map.Entry<Integer, Integer> entry : hashmap.entrySet()) {
            System.out.print("(" + entry.getKey() + "," + entry.getValue() + ") ");
        }
        System.out.println("在哈希表中");
        // 9. 清空哈希表
        hashmap.clear();
        // 10. 检查哈希表是否为空
        if (hashmap.isEmpty()) {
            System.out.println("哈希表为空!");
        }
    }
}
A 情景Ⅰ – 构造哈希表
什么情况下会想到使用哈希表呢?当我们需要 同时得到关联信息 时,可以使用哈希表建立 key 与 value 的映射关系。
例如对于一个数组 A,我们想知道每个元素最后一次出现的位置,这时,元素和最后一次出现的位置信息相关联,则可以使用 {A[i]:A[i] 最后出现的下标} 这样的映射关系来构造哈希表。
学会构造哈希表,将是我们熟练应用哈希表的一个前提。构造哈希表前,我们需要仔细分析题目中相关因素之间的关系,然后为键和值选择合适的数据类型。
示例
这是一个经典问题:
两数之和:给定一个整数数组,返回两个元素的 索引,使这两个元素之和为
target。
如果我们枚举每一个下标 i 和 j,如果他们指向的元素等于 target,这时便找到了答案,但是时间复杂度将达到 O(N2)。
使用哈希表可以将时间复杂度降为 O(N)。首先返回的是元素的 下标,所以可以考虑使用 {元素:下标} 的结构构造哈希表;其次,遍历数组的过程中,如果当前元素为 x,target - x 在之前已经遍历过,则表明 [下标(x), 下标(target - x)] 就是答案,否则,将 x:下标(x) 添加到哈希表中。
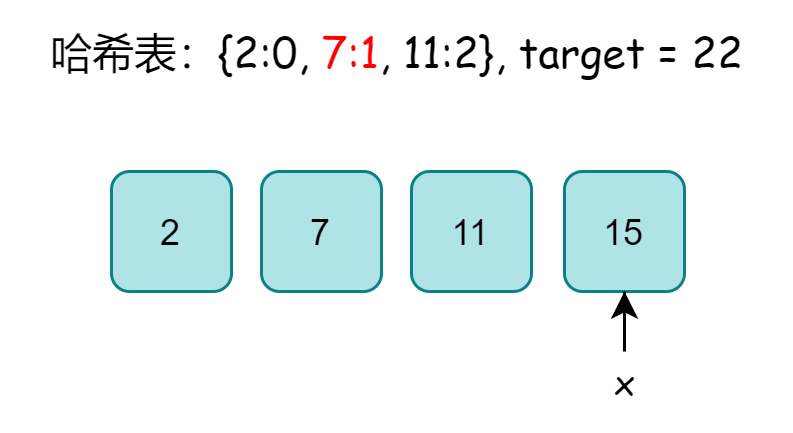
如图,当前 x 位于下标 3 且 x = 15,发现 target - x = 7 在哈希表中,所以直接返回 [1, 3]。
更多
注意到上面的例子中我们使用了 {键:下标} 的形式构建哈希表,除此之外,根据值类别的不同,常用的构造方法还有以下几种:
{键:频次}:使用频率最高,将元素出现的次数作为值;{键:数组}:如果一个键对应的信息是一组元素,可使用数组或链表存储。{键:平面坐标}:某些矩阵类习题可能会存储坐标;{键:其他}:一般出现在模拟题中,根据实际需要设计哈希表。
因此,当遇到某个问题可使用哈希表解决时,可以从以上几种构造方法中进行筛选。
LC 两数之和
给定一个整数数组 nums 和一个整数目标值 target,请你在该数组中找出 和为目标值 target 的那 两个 整数,并返回它们的数组下标。
你可以假设每种输入只会对应一个答案。但是,数组中同一个元素在答案例不能重复出现。
你可以按任意顺序返回答案。
示例 1:
输入:nums = [2,7,11,15], target = 9
输出:[0,1]
解释:因为 nums[0] + nums[1] == 9 ,返回 [0, 1] 。
示例 2:
输入:nums = [3,2,4], target = 6
输出:[1,2]
示例 3:
输入:nums = [3,3], target = 6
输出:[0,1]提示:
- 2 <= nums.length <= 104
- -109 <= nums[i] <= 109
- 109 <= target <= 109
- 只会存在一个有效答案
进阶:你可以想出一个时间复杂度小于 O(n2) 的算法吗?
题解
class Solution {
  public int[] twoSum(int[] nums, int target) {
    Map<Integer, Integer> hashtable = new HashMap<Integer, Integer>();
    for (int i = 0; i < nums.length; ++i) {
      // 查询哈希表中是否存在 target-x,然后将x插入哈希表中,保证不会让x和自己匹配
      if (hashtable.containsKey(target - nums[i])) {
        return new int[]{hashtable.get(target - nums[i]), i};
      }
      // 添加键值对
      hashtable.put(nums[i], i);
    }
    return new int[0];
  }
}复杂度分析
- 时间复杂度:O(N),其中 N 是数组中元素的数量。对于每一个元素
x,我们可以 O(1) 的寻找target - x。 - 空间复杂度:O(N),其中 N 是数组中的元素数量。主要为哈希表的开销。
给定两个字符串 s 和 t,判断他们是否是同构的。
如果 s 中的字符可以按某种映射关系替换得到 t,那么这两个字符串是同构的。
每个出现的字符都应当映射到另一个字符,同时不改变字符的顺序。不同字符不能映射到同一个字符上,相同字符只能映射到同一个字符上,字符可以映射到自己本身。
示例 1:
输入:s = "egg", t = "add"
输出:true
示例 2:
输入:s = "foo", t = "bar"
输出:false
示例 3:
输入:s = "paper", t = "title"
输出:true提示:
- 1 <= s.length <= 5 * 104
t.length == s.lengths和t由任意有效的 ASCLL 字符组成
题解
查看解析
我门需要判断 s 和 t 每个位置上的字符是否都一一对应,即 s 的任意一个字符被 t 中唯一的字符对应,同时 t 的任意一个字符被 s 中唯一的字符对应。这也被称为 双射 关系。
以示例 2 为例,t 中的字符 a 和 r 虽然有唯一的映射 o,但对于 s 中的字符 o 来说,其存在两个映射 {a, r},故不满足条件。
因此,我们维护两张哈希表,第一张哈希表 s2t 以 s 中字符为键,映射至 t 的字符为值,第二张哈希表 t2s 以 t 中字符为键,映射至 s 的字符为值。从左至右遍历两个字符串的字符,不断更新两张哈希表,如果出现冲突(即当前下标 index 对应的字符 s[index] 已经存在映射且不为 t[index] 或当前下标 index 对应的字符 t[index] 已经存在映射且不为 s[index]),说明两个字符串无法构成同构,返回 false。
如果遍历结束没有出现冲突,则表明两个字符串是同构的,返回 true。
class Solution {
  public boolean isIsomorphic(String s, String t) {
    Map<Character, Character> s2t = new HashMap<Character, Character>();
    Map<Character, Character> t2s = new HashMap<Character, Character>();
    int len = s.length();
    for (int i = 0; i < len; ++i) {
      char x = s.charAt(i), y = t.charAt(i);
      if ((s2t.containsKey(x) && s2t.get(x) != y) || (t2s.containsKey(y) && t2s.get(y) != x)) {
        return false;
      }
      s2t.put(x, y);
      t2s.put(y, x);
    }
    return true;
  }
}
复杂度分析
- 时间复杂度:O(n),其中 n 为字符串的长度。我们只需要同时遍历一遍字符串 s 和 t 即可。
- 空间复杂度:O(∣Σ∣),其中 Σ 是字符串的字符集。哈希表存储字符的空间取决于字符串的字符集大小,最坏情况下每个字符均不相同,需要 O(|Σ|) 的空间。
LC 两个列表的最小索引总和
假设 Andy 和 Doris 想在晚餐时选择一家餐厅,并且他们都有一个表示最喜A爱餐厅的列表,每个餐厅的名字用字符串表示。
你需要帮助他们用 最少的索引和 找出题目 共同喜爱的餐厅。如果答案不止一个,则输出所有答案并且不考虑顺序。你可以假设答案总是存在。
示例 1:
输入: list1 = ["Shogun", "Tapioca Express", "Burger King", "KFC"],list2 = ["Piatti", "The Grill at Torrey Pines", "Hungry Hunter Steakhouse", "Shogun"]
输出: ["Shogun"]
解释: 他们唯一共同喜爱的餐厅是“Shogun”。
示例 2:
输入:list1 = ["Shogun", "Tapioca Express", "Burger King", "KFC"],list2 = ["KFC", "Shogun", "Burger King"]
输出: ["Shogun"]
解释: 他们共同喜爱且具有最小索引和的餐厅是“Shogun”,它有最小的索引和1(0+1)。提示:
1 <= list1.length, list2.length <= 10001 <= list1[i].length, list2[i].length <= 30list1[i]和list2[i]由空格‘ ’和英文字母组成。list1的所有字符串都是 唯一 的。list2中的所有字符串都是 唯一 的。
题解
方法一:哈希表
查看题解
使用一个哈希表记录 list1 中每个餐厅对应的索引下标,然后遍历 list2,如果 list2 的餐厅存在于哈希表表中,那么说明该餐厅是两人共同喜爱的,计算它的索引和。如果该索引和比最小索引和小,则清空结果,将该餐厅加入结果中,该索引和作为最小索引和;如果该索引和等于最小索引和,则直接将该餐厅加入结果中。
class Solution {
  public String[] findRestaurant(String[] list1, String[] list2) {
    Map<String, Integer> index = new HashMap<String, Integer>();
    for (int i = 0; i < list1.length; i++) {
      index.put(list1[i], i);
    }

    List<String> ret = new ArrayList<String>();
    int indexSum = Integer.MAX_VALUE;
    for (int i = 0; i < list2.length; i++) {
      if (index.containsKey(list2[i])) {
        int j = index.get(list2[i]);
        if (i + j < indexSuzm) {
          ret.clear();
          ret.add(list2[i]);
          indexSum = i + j;
        }
        else if (i + j == indexSum) {
          ret.add(list2[i]);
        }
      }
    }
    return ret.toArray(new String[ret.size()]);
  }
}
复杂度分析
- 时间复杂度:O(∑1 + ∑2),其中 ∑1 和 ∑2 分别表示 list1 和 list2 中的字符串长度之和。建立哈希表需要 O(∑1),遍历 list2 需要 list2 需要 O(∑2)。
- 空间复杂度:O(∑1)。保存哈希表需要 O(∑1) 的空间,返回结果不计算空间复杂度。
A 情景Ⅱ – 哈希表与滑动窗口
情景Ⅱ – 哈希表与滑动窗口
本文将介绍滑动窗口技巧,以及哈希表在滑动窗口中的应用。
什么是滑动窗口
顾名思义,滑动窗口就是将数组或字符串中的一个分段,形象地看做一个 “窗口”,通过更改 “窗口” 的左右边界,实现窗口的移动、缩放等操作。
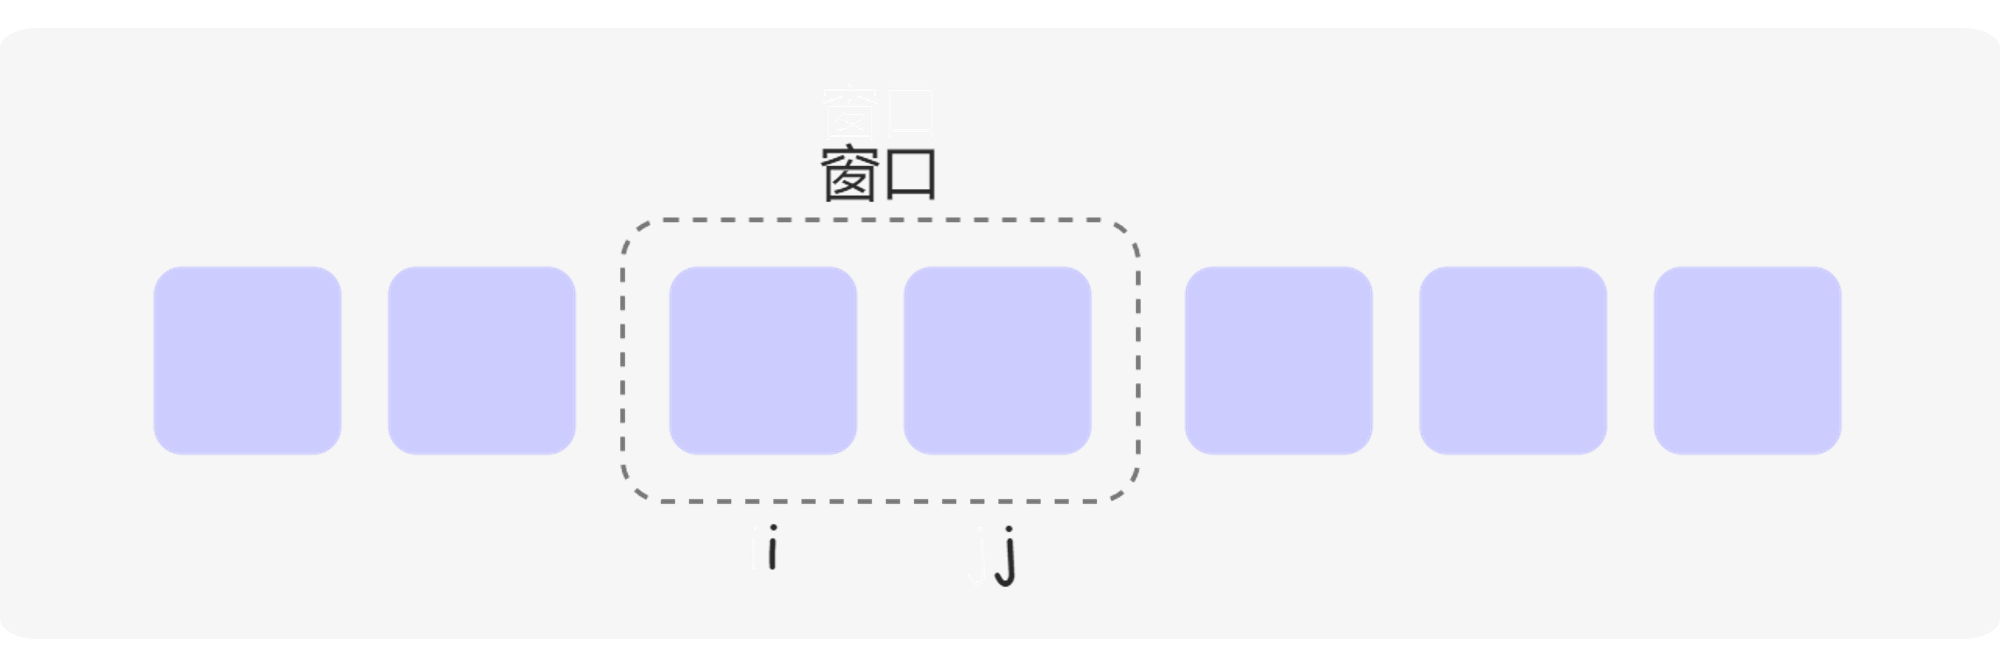
如图所示,窗口的左右边界使用 i,j 实现,当两个指针同时向右移动,则为窗口的 “滑动” 操作;而当其中一个指针不动,另一个指针向右移动时,窗口会扩大或缩小。
需要注意的是,一般情况下,在实际题目中指针只会沿 一个方向 移动。
使用哈希表
对于基本情况,滑动窗口使用双指针即可实现,但是有时会出现一些问题,假如如窗口中的元素为 "(aaaaaabc)",左右边界指针分别为 i 和 j,如果我们想要将窗口变为 "(abc)",可以选择将左边界指针 i 向右移动 5 步。
以上情况会造成时间的浪费,加入建立元素 a 为键,下标为值的哈希表 {"a" : 5},那么元素 a 只需 1 步即可 “跳跃” 到下标 5 的位置。
优化运行时间,是滑动窗口中使用哈希表的一个目的。除此之外,哈希表还被用来统计窗口中的元素个数,以及判断当前窗口的状态是否满足条件。以下是滑动窗口类题目的总结:
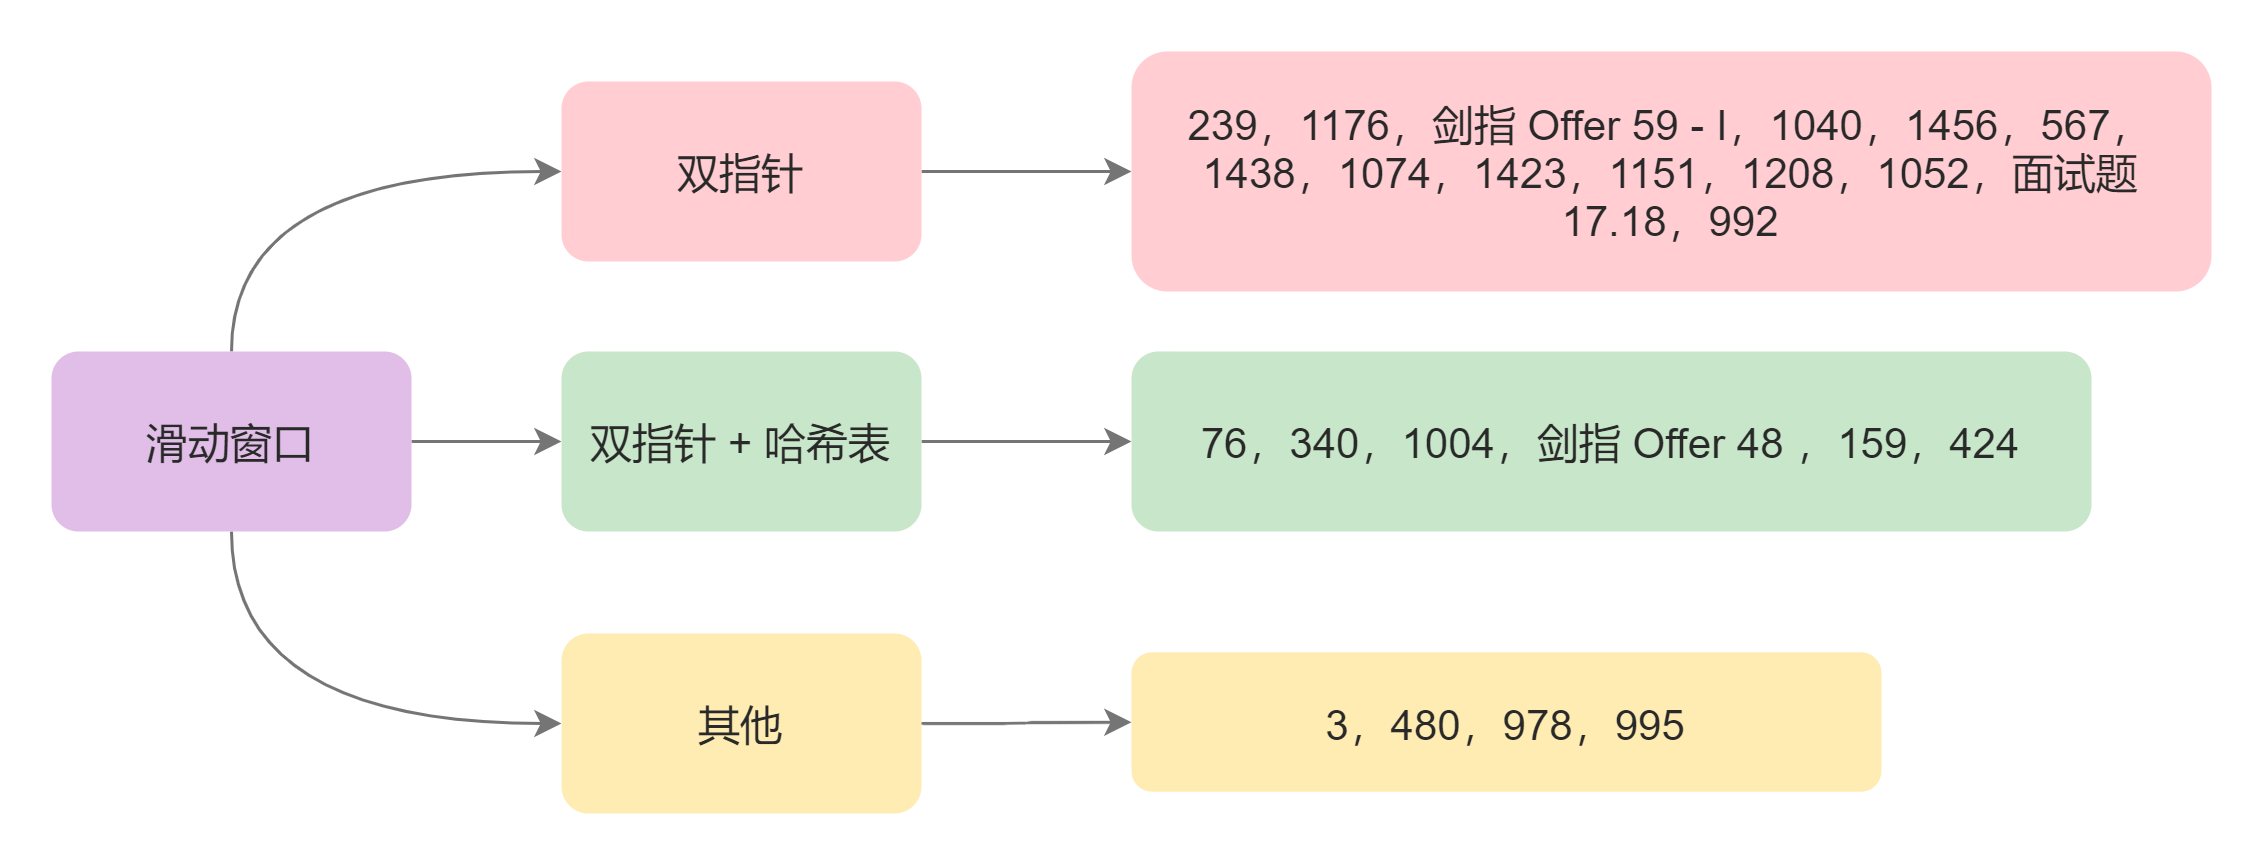
总之,滑动窗口类题目的思想比较简单,而实现时往往具有一定难度。下面是一些哈希表处理滑动窗口的题目。
LC 存在重复元素 Ⅱ
给你一个整数数组 nums 和一个整数 k,判断数组中是否存在两个 不同的索引 i 和 j,满足 nums[i] == nums[j] 且 abs(i - j) <= k。如果存在,返回 true;否则,返回 false。
示例 1:
输入:nums = [1,2,3,1], k = 3
输出:true
示例 2:
输入:nums = [1,0,1,1], k = 1
输出:true
示例 3:
输入:nums = [1,2,3,1,2,3], k = 2
输出:false提示:
- 1 <= nums.length <= 105
- -109 <= nums[i] <= 109
- 0 <= k <= 105
题解
方法二:滑动窗口
查看题解
考虑数组 nums 中的每个长度不超过 k+1 的滑动窗口,同一个滑动窗口中的任意两个下标差的绝对值不超过 k。如果存在一个滑动窗口,其中有重复元素,则存在两个不同的小标 i 和 j 满足 nums[i] = nums[j] 且 |i – j| ≤ k。如果所有滑动窗口中都没有重复元素,则不存在符合要求的下标。因此,只要遍历每个滑动窗口,判断滑动窗口中是否有重复元素即可。
如果一个滑动窗口的结束下标是 i,则该滑动窗口的开始下标是 max(0, i -k)。可以使用哈希集合存储滑动窗口中的元素。从左到右遍历数组 nums,当遍历到下标 i 时,具体操作如下:
- 如果 i > k,则下标 i – k – 1 处的元素被移出滑动窗口,因此将 nums[i – k -1] 从哈希集合中删除;
- 判断 nums[i] 是否在哈希集合中,如果在哈希集合中则在同一个滑动窗口中有重复元素,返回 true,如果不在哈希集合中则将其加入哈希集合。
当遍历结束时,如果所有滑动窗口中都没有重复元素,返回 false。
class Solution {
  public boolean containsNearbyDuplicate(int[] nums, int k) {
    Set<Integer> set = new HashSet<Integer>();
    int length = nums.length;
      for (int i = 0; i < length; i++) {
        if (i > k) {
          set.remove(nums[i - k -1]);
        }
        if (!set.add(nums[i])) {
          return true;
        }
      }
    return false;
  }
}
复杂度分析
- 时间复杂度:O(n),其中 n 是数组 nums 的长度。需要遍历数组一次,对于每个元素,哈希集合的操作时间都是 O(1)。
- 空间复杂度:O(k),其中 k 是判断重复元素时允许的下标差的绝对值的最大值。需要使用哈希集合存储滑动窗口中的元素,任意时刻滑动窗口中的元素个数最多为 k + 1 个。
LC 替换后的最长重复字符
给你一个字符串 s 和一个整数 k。你可以选择字符串中的任一字符,并将其更改为任何其他大写英文字符。该操作最多可执行 k 次。
在执行上述操作后,返回包含相同字母的最长子字符串的长度。
示例 1:
输入:s = "ABAB", k = 2
输出:4
解释:用两个'A'替换为两个'B',反之亦然。
示例 2:
输入:s = "AABABBA", k = 1
输出:4
解释:
将中间的一个'A'替换为'B',字符串变为 "AABBBBA"。
子串 "BBBB" 有最长重复字母, 答案为 4。提示:
- 1 <= s.length <= 105
s仅由大写英文字母组成0 <= k <= s.length
题解
class Solution {
    public int characterReplacement(String s, int k) {
        // if(s == null){
        //     return 0;
        // }//可以删去
        int[] map = new int[26];
        char[] chars = s.toCharArray();
        int left = 0;
        int right = 0;
        int historyCharMax = 0;//滑动窗口历史上在一个窗口内出现次数最多的字母的次数(仅限在当时的窗口内出现)
        for(right = 0;right < chars.length; right++){
            int index = chars[right] - 'A';
            map[index]++;//将右指针右移后对应的新元素添加到map中
            historyCharMax = Math.max(historyCharMax, map[index]);//更新历史最大出现次数
            //如果新加元素(即新加元素就是当下出现次数最多的字母)使得当下historyCharMax增加了1,则扩大窗口,以下if不执行
            //否则,不扩窗,窗口滑动(右指针已经右移一位了,需要把左指针左移,执行if语句)
            if(right - left + 1 > historyCharMax + k){
                map[chars[left] - 'A']--;
                left++;
            }
        }
        return chars.length - left;//即right - left最终窗口的长度 右指针right最终一定会移到chars.length即数组的末端
    }
}
LC 最大连续的个数 Ⅲ
给定一个二进制数组 nums 和一个整数 k,如果可以翻转最多 k 个 0,则返回数组中连续 1 的最大个数。
示例 1:
输入:nums = [1,1,1,0,0,0,1,1,1,1,0], K = 2
输出:6
解释:[1,1,1,0,0,1,1,1,1,1,1]
粗体数字从 0 翻转到 1,最长的子数组长度为 6。
示例 2:
输入:nums = [0,0,1,1,0,0,1,1,1,0,1,1,0,0,0,1,1,1,1], K = 3
输出:10
解释:[0,0,1,1,1,1,1,1,1,1,1,1,0,0,0,1,1,1,1]
粗体数字从 0 翻转到 1,最长的子数组长度为 10。提示:
- 1 <= nums.length <= 105
nums[i]不是 0 就是 10 <= k <= nums.length
题解
查看解析
对于数组 A 的区间 [left, right] 而言,只要它包含不超过 k 个 0,我们就可以根据它构造出一段满足要求,并且长度为 right – left + 1 的区间。
因此,我们可以将该问题进行如下的转换,即:
要想快速的判断一个区间内 0 的个数,我们可以考虑将数组 A 中的 0 变成 1,1 变成 0。此时,我们对数组 A 求出前缀和,记为数组 P,那么 [left, right] 中包含不超过 k 个 1(注意这里就不是 0 了),当且仅当二者的前缀和之差:
这样一来,我们就可以容易的去解决这个问题了。
继续观察,由于前缀和数组 P 是单调递增的,那么对于(1)右侧 P[right] – k 同样也是单调递增的。因此,我们可以发现:
随着 rigth 的增大,满足 (1) 式的最小的 left 值是单调递增的。
这样一来,我们就可以使用滑动窗口来实时的维护 left 和 right 了。在 right 向右移动的过程中,我们同步移动 left,直到 left 首个(即最小的)满足 (1) 式的位置,此时我们就可以使用此区间对答案进行更新了。
细节
当我们使用滑动窗口代替二分查找解决本题时,就不需要显式的计算并保存出前缀和数组了。我们只需要知到 left 和 right 作为下标在前缀和数组中对应的值,因此我们只需要用两个变量 lsum 和 rsum 记录 left 和 right 分别对应的前缀和即可。
class Solution {
    public int longestOnes(int[] nums, int k) {
        int n = nums.length;
        int left = 0, lsum = 0, rsum = 0;
        int ans = 0;
        for (int right = 0; right < n; ++right) {
            // 计算有多少个0
            rsum += 1 - nums[right];
            // 判断是向右移动还是扩张
            while (lsum < rsum - k) {
                lsum += 1 - nums[left];
                ++left;
            }
            // 窗口大小即为答案
            ans = Math.max(ans, right - left + 1);
        }
        return ans;
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 是数组 A 的长度。我们至多只需要遍历该数组两次(左右指针各一次)。
- 空间复杂度:O(1),我们只需要常数的空间保存若干变量。
LC 至多包含两个不同字符的最长子串
给你一个字符串 s,请你找出 至多 包含 两个不同字符 的最长子串,并返回该子串的长度。
示例 1:
输入:s = "eceba"
输出:3
解释:满足题目要求的子串是 "ece" ,长度为 3 。
示例 2:
输入:s = "ccaabbb"
输出:5
解释:满足题目要求的子串是 "aabbb" ,长度为 5 。提示:
- 1 <= s.length <= 105
s由英文字母组成
题解
查看题解
我们使用一个左指针和一个右指针表示滑动窗口的边界。
一开始,让两个指针都指向 0,当窗口包含的字符不超过 2 个不同的字符时,就不断将右指针往右边移动。如果在某一个位置有 3 个不同的字符,就开始移动左指针,直到窗口内包含不超过 2 个不同字符。
沿着字符串移动滑动窗口,并保持窗口内只有不超过 2 个不同字符,同时每一步都更新最长子串的长度。
我们使用一个 hashmap,把字符串的字符都当做键,在窗口中的最右边的字符作为值。每一时刻,这个 hashmap 包括不超过 3 个元素。
比方说,通过这个 hashmap,你可以知道窗口 “eeeeeeeet” 中字符 e 最右边的位置是 8,所以必须要至少将做指针移动到 8 + 1 = 9 的位置来将 e 从滑动窗口中移除。
class Solution {
  public int lengthOfLongestSubstringTwoDistinct(String s) {
    int n = s.length();
    if (n < 3) return n;

    int left = 0;
    int right = 0;

    HashMap<Character, Integer> hashmap = new HashMap<Character, Integer>();

    int max_len = 2;

    while (right < n) {
      if (hashmap.size() < 3) {
        hashmap.put(s.charAt(right), right++);
      }
      // 查找 hashmap 中最小的值(即左指针下标)
      if (hashmap.size() == 3) {
        int del_idx = Collections.min(hashmap.values());
        hashmap.remove(s.charAt(del_idx));
        left = del_idx + 1;
      }
      // 更新最长子串长度
      max_len = Math.max(max_len, right - left);
    }
    return max_len;
  }
}
复杂度分析
- 时间复杂度:O(N) 其中 N 是输入串的字符数目。
- 空间复杂度:O(1),因为额外的空间只有 hashmap,且它包含不超过 3 个元素。
实际应用 – 设计键
A 设计键
设计键
在前面的问题中,我们主要考虑了根据值不同形式构造哈希表,而键的设计相对简单。然而在某些题目中,我们可能已经想到了哈希表的解法,但受限于 无法设计出合适的键,本节将对键的设计做出总结。
示例
我们来看一个例子:
给定一组字符串,将字母异位词组合在一起。
字母异位词指字母相同,但排列不同的字符串,比如 "ate" 与 "eat" 是一组字母异位词。如果单纯地把每个字符串作为键,显然没有起到任何作用。
解决方案
经过分析发现,同一组字母异位词中,如果按照字典序排列,得到的字符串相同,且长度相等。这时我们自然想到以 按照字典序排列后的字符串 作为键,这样就能合理区分出字母异位词了。例如对于 "ate" 和 "eat" 构造的哈希表为 {"aet":["ate","eat"]}。
设计键的策略可能是非常棘手的,接下来将提供一些习题,并对键的设计技巧做出总结。
LC 字母异位词分组
给你一个字符串数组,请你将 字母异位词 组合在一起。可以按任意顺序返回结果列表。
字母异位词 是由重新排列源单词的字母得到的一个新单词,所有源单词中的字母通常恰好只用一次。
示例 1:
输入: strs = ["eat", "tea", "tan", "ate", "nat", "bat"]
输出: [["bat"],["nat","tan"],["ate","eat","tea"]]
示例 2:
输入: strs = [""]
输出: [[""]]
示例 3:
输入: strs = ["a"]
输出: [["a"]]提示:
- 1 <= strs.length <= 104
0 <= strs[i].length <= 100strs[i]仅包含小写字母
题解
方法一:排序
查看题解
由于互为字母异位词的两个字符串包含的字母相同,因此对两个字符串分别进行排序后得到的字符串一定是相同的,故可以将排序之后的字符串作为哈希表的键。
class Solution {
  public List<List<String>> groupAnagrams(String[] strs) {
    Map<String, List<String>> map = new HashMap<String,List<String>>();
    for (String str :strs) {
      char[] array = str.toCharArray();
      // 将字符串按字典序排序
      Arrays.sort(array);
      String key = new String(array);
      // 若 hashmap 中存在对应 key,则继承对应 value 值并在此基础上添加值
      // 若不存在,创建一个空数组,并添加值
      List<String> list = map.getOrDefault(key, new ArrayList<String>());
      list.add(str);
      map.put(key,list);
    }
    return new ArrayList<List<String>>(map.values());
  }
}
复杂度分析
- 时间复杂度:O(nk logk),其中 n 是 strs 中字符串的数量,k 是 strs 中字符串的最大长度。需要遍历 n 个字符串,对于每个字符串,需要 O(k logk) 的时间进行排序以及 O(1) 的时间更新哈希表,因此时间复杂度是 O(nk logk)。
- 空间复杂度:O(nk),其中 n 是 strs 中的字符串数量,k 是 strs 中字符串的最大长度。需要用哈希表存储全部字符串。
方法二:计数
查看解析
由于互为字母异位词的两个字符串包含的字母相同,因此两个字符串中的相同字母出现的次数一定是相同的,故可以将每个字母出现的次数使用字符串表示,作为哈希表的键。
由于字符串只包含小写字母,因此对每个字符串,可以使用长度为 26 的数组记录每个字母出现的次数,排序后的字符串进行哈希映射。
class Solution {
  public List<List<String>> groupAnagrams(String[] strs) {
    Map<String, List<String>> map = new HashMap<String, List<String>>();
    for (String str : strs) {
      int[] counts = new int[26];
      int length = str.length();
      for (int i = 0; i < length; i++) {
        // 将数组中字母对应下标处 +1(出现一次)
        counts[str.charAt(i) - 'a']++;
      }
      // 将每个出现次数大于 0 的字母和出现次数按顺序拼接成字符串,作为哈希表的键
      StringBuffer sb = new StringBuffer();
      for (int i = 0; i < 26; i++) {
        if (counts[i] != 0) {
          sb.append((char)('a' + i));
          sb.append(counts[i]);
        }
      }
      String key = sb.toString();
      List<String> list = map.getOrDefault(key, new ArrayList<String>());
      list.add(str);
      map.put(key,list);
    }
    return new ArrayList<List<String>>(map.values());
  }
}
复杂度分析
- 时间复杂度:O(n(k+|Σ|)),其中 n 是 strs 中的字符串数量,k 是 strs 中字符串的最大长度,Σ 是字符集,在本题中字符集为所有小写字母,|Σ| = 26。需要遍历 n 个字符串,对于每个字符串,需要 O(k) 的时间计算每个字母出现的次数,O(|Σ|) 的时间生成哈希表的键,以及 O(1) 的时间更新哈希表,因此总时间复杂度是 O(n(k+|Σ|))。
- 空间复杂度:O(n(k+|Σ|)),其中 n 是 strs 中的字符串数量,k 是 strs 中字符串的最大长度,Σ 是字符集,在本题中字符集为所有小写字母,|Σ| = 26。需要用哈希表存储全部字符串,而记录每个字符串中每个字母出现次数的数组需要的空间为 O(|Σ|),在渐进意义下小于 O(n(k+|Σ|)),可以忽略不计。
LC 移位字符串分组
给定一个字符串,对该字符串可以进行 “移位” 操作,也就是将字符串中每个字母都变为在字母表中的后序的字母,例如 "abc"->"bcd"。这样,我们可以持续进行移位操作,从而生成如下移位序列:
"abc" -> "bcd" -> ... -> "xyz"示例:
输入:["abc", "bcd", "acef", "xyz", "az", "ba", "a", "z"]
输出:
[
  ["abc","bcd","xyz"],
  ["az","ba"],
  ["acef"],
  ["a","z"]
]
解释:可以认为字母表首尾相接,所以 'z' 的后续为 'a',所以 ["az","ba"] 也满足 “移位” 操作规律。
题解
查看题解
使用哈希表存储,将相对首字母的偏移量组成的字符作为key,例如 “abc”,其键为#0#1#2。因为若字符串为 “za” 会出现负数键值,因此还要加上 26 再求余 26 转换为正数
class Solution {
    public List<List<String>> groupStrings(String[] strings) {
        if (strings == null || strings.length == 0) return new ArrayList<>();
        Map<String, List<String>> map = new HashMap<String, List<String>>();
        for (String str : strings) {
            StringBuilder sb = new StringBuilder();
            for (char c : str.toCharArray()) {
                sb.append("#");
                int shift = (c - str.charAt(0) + 26) % 26;
                sb.append(shift);
            }
            String key = sb.toString();
            if (!map.containsKey(key)) {
                map.put(key, new ArrayList<String>());
            }
            // 在对应 key 的列表值中加入新字符串
            map.get(key).add(str);
        }
        return new ArrayList<>(map.values());
    }
}
LC 有效的数独
请你判断一个 9×9 的数独是否有效。只需要 根据以下规则,验证已经填入的数字是否有效即可。
- 数字
1-9在每一行只能出现一次。 - 数字
1-9在每一列只能出现一次。 - 数字
1-9在每一个以粗实线分隔的3×3宫内只能出现一次。
注意:
- 一个有效的数独(部分已被填充)不一定是可解的。
- 只需要根据以上规则,验证已经填入的数字是否有效即可。
- 空白用
.表示。
示例 1: 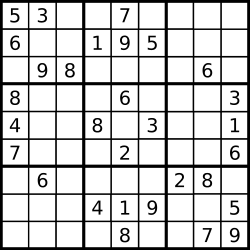
输入:board =
[["5","3",".",".","7",".",".",".","."]
,["6",".",".","1","9","5",".",".","."]
,[".","9","8",".",".",".",".","6","."]
,["8",".",".",".","6",".",".",".","3"]
,["4",".",".","8",".","3",".",".","1"]
,["7",".",".",".","2",".",".",".","6"]
,[".","6",".",".",".",".","2","8","."]
,[".",".",".","4","1","9",".",".","5"]
,[".",".",".",".","8",".",".","7","9"]]
输出:true
示例 2:
输入:board =
[["8","3",".",".","7",".",".",".","."]
,["6",".",".","1","9","5",".",".","."]
,[".","9","8",".",".",".",".","6","."]
,["8",".",".",".","6",".",".",".","3"]
,["4",".",".","8",".","3",".",".","1"]
,["7",".",".",".","2",".",".",".","6"]
,[".","6",".",".",".",".","2","8","."]
,[".",".",".","4","1","9",".",".","5"]
,[".",".",".",".","8",".",".","7","9"]]
输出:false
解释:除了第一行的第一个数字从 5 改为 8 以外,空格内其他数字均与 示例1 相同。 但由于位于左上角的 3x3 宫内有两个 8 存在, 因此这个数独是无效的。提示:
board.length == 9board[i].length == 9board[i][j]是一位数字1-9或者"."
题解
查看题解
我们只需要对 board 中出现的数进行判断,若违反了规则,返回 false,否则返回 true。对于九宫格,则是对他进行编号。然后推导出九宫格编号和行列的关系为:
idx = [i/3]*3 + [j/3]
class Solution {
    public boolean isValidSudoku(char[][] board) {
      Map<Integer, Set<Integer>> row = new HashMap<>(), col = new HashMap<>(), area = new HashMap<>();
      for (int i = 0; i < 9; i++) {
        row.put(i, new HashSet<>());
        col.put(i, new HashSet<>());
        area.put(i, new HashSet<>());
      }
      for (int i = 0; i < 9; i++) {
        for (int j = 0; j < 9; j++) {
          char c = board[i][j];
          if (c == '.') continue;
          int u = c - '0';
          int idx = i / 3 * 3 + j / 3;
          if (row.get(i).contains(u) || col.get(j).contains(u) || area.get(idx).contains(u)) return false;
          row.get(i).add(u);
          col.get(j).add(u);
          area.get(idx).add(u);
        }
      }
      return true;
    }
}复杂度分析
- 时间复杂度: O(1),在固定 9 * 9 的问题里,计算量不随数据变化而变化。
- 空间复杂度:O(1),在固定 9 * 9 的问题里,存储空间不随数据变化而变化。
LC 寻找重复的子树*
给你一棵二叉树的根节点 root,返回所有 重复的子树。
对于同一类的重复子树,你只需要返回其中任意 一棵 的根节点即可。
如果两棵具有 相同的结构 和 相同的结点值,则认为二者是 重复 的。
示例 1:
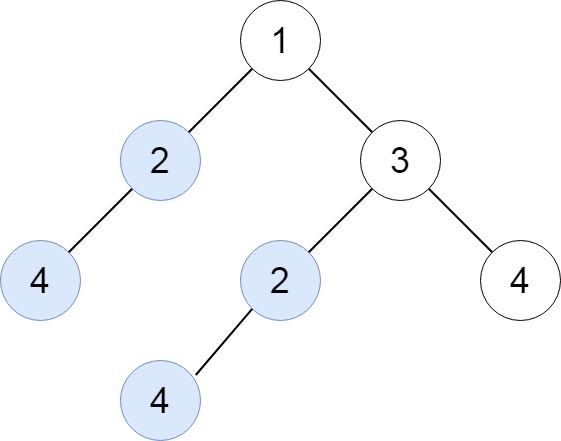
输入:root = [1,2,3,4,null,2,4,null,null,4]
输出:[[2,4],[4]]
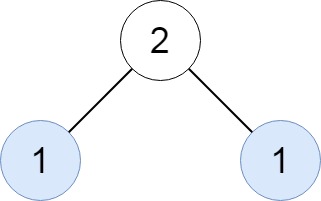
示例 2:
输入:root = [2,1,1]
输出:[[1]]
示例 3:
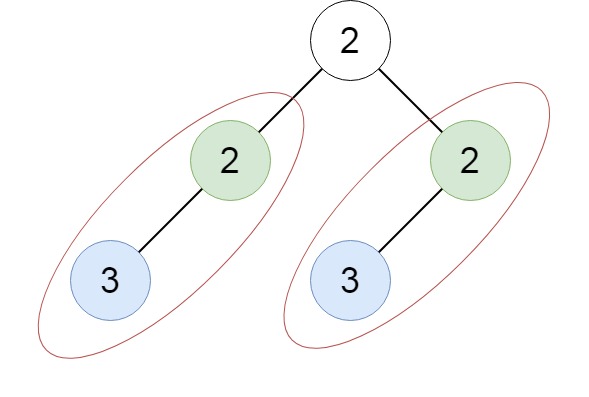
输入:root = [2,2,2,3,null,3,null]
输出:[[2,3],[3]]提示:
- 树中的结点树在
[1, 5000]范围内。 -200 <= Node.val <= 200
题解
查看题解
我们可以使用一个三元组直接表示一棵子树,即(x,l,r),他们分别表示:
- 根节点的值为 x
- 左子树的序号为 l
- 右子树的序号为 r
这里的 [序号] 指的是:每当我们发现一棵新的子树,就给这棵子树一个序号,用来表示其结构。那么两棵树是重复的,当且仅当他们对应的三元组完全相同。使用 [序号] 的好处在于同时减少了时间复杂度和空间复杂度。
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    Map<String, Pair<TreeNode, Integer>> seen = new HashMap<String, Pair<TreeNode, Integer>>();
    Set<TreeNode> repeat = new HashSet<TreeNode>();
    int idx = 0;

    public List<TreeNode> findDuplicateSubtrees(TreeNode root) {
        dfs(root);
        return new ArrayList<TreeNode>(repeat);
    }

    public int dfs(TreeNode node) {
        if (node == null) {
            return 0;
        }
        int[] tri = {node.val, dfs(node.left), dfs(node.right)};
        String hash = Arrays.toString(tri);
        if (seen.containsKey(hash)) {
            Pair<TreeNode, Integer> pair = seen.get(hash);
            repeat.add(pair.getKey());
            return pair.getValue();
        } else {
            seen.put(hash, new Pair<TreeNode, Integer>(node, ++idx));
            return idx;
        }
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 是树中节点的数目。
- 空间复杂度:O(n),即为哈希表需要使用的空间。
LC 稀疏矩阵的乘法*
给定两个 稀疏矩阵:大小为 m × k 的稀疏矩阵 mat1 和大小为 k × n 的稀疏矩阵 mat2,返回 mat1 × mat2 的结果。你可以假设乘法总是可能的。
示例 1:
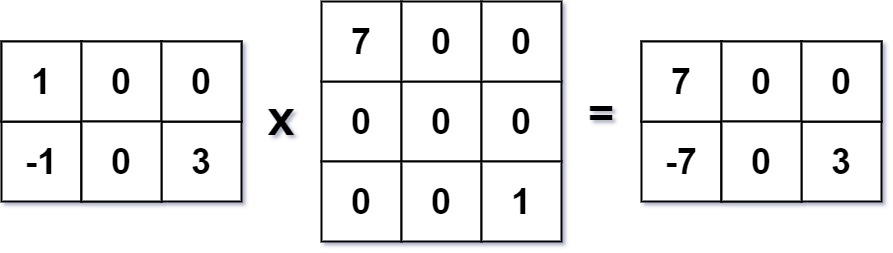
输入:mat1 = [[1,0,0],[-1,0,3]], mat2 = [[7,0,0],[0,0,0],[0,0,1]]
输出:[[7,0,0],[-7,0,3]]
示例 2:
输入:mat1 = [[0]], mat2 = [[0]]
输出:[[0]]提示:
m == mat1.lengthk == mat1[i].length == mat2.lengthn == mat2[i].length1 <= m, n, k <= 100-100 <= mat1[i][j] <= 100
题解
查看题解
先对A、B两个矩阵转存储方式,利用哈希表存;也就是 transA 和 transB 这两个方法
对于A,先索引行号,再索引列号;B矩阵则先索引列,再索引行,对非0元素进行存储
完成了矩阵稀疏化存储后,对于A中的key(A的行)和B中的key(B的列),进行对应行列的向量点乘操作,点乘结果放置到结果的对应索引(A行B列)处。
对于向量的点乘,由于是稀疏向量点乘,所以只需要考虑这两个哈希表的公共索引即可,这里增加了一个 retainAll 操作,避免乘0操作。
class Solution {
    public int[][] multiply(int[][] mat1, int[][] mat2) {
      int m = mat1.length;
      int n = mat2[0].length;
      int[][] res = new int[m][n];
      Map<Integer, Map<Integer, Integer>> map1 = transA(mat1);
      Map<Integer, Map<Integer, Integer>> map2 = transB(mat2);
      for (Map.Entry<Integer, Map<Integer,Integer>> e1:map1.entrySet()) {
        Map<Integer,Integer> m1 = e1.getValue();
        Set<Integer> s1 = m1.keySet();
        int i = e1.getKey();
        for (Map.Entry<Integer, Map<Integer, Integer>> e2:map2.entrySet()) {
          Map<Integer, Integer> m2 = e2.getValue();
          Set<Integer> s2 = new HashSet<>(m2.keySet());
          int j = e2.getKey();
          s2.retainAll(s1);
          for (Integer idx : s2) {
            res[i][j] += m1.get(idx) * m2.get(idx);
          }
        }
      }
      return res;
    }

    public Map<Integer, Map<Integer, Integer>> transA(int[][] A) {
      Map<Integer, Map<Integer, Integer>> mA = new HashMap<>();
      for (int i = 0; i < A.length; i++) {
        Map<Integer, Integer> rowA = new HashMap<>();
        for (int j = 0; j < A[0].length; j++) {
          if (A[i][j] != 0) {
            rowA.put(j, A[i][j]);
          }
        }
        if (rowA.size() > 0) {
            mA.put(i, rowA);
          }
      }
      return mA;
    }

    public Map<Integer, Map<Integer, Integer>> transB(int[][] B) {
      Map<Integer, Map<Integer, Integer>> mB = new HashMap<>();
      for (int i = 0; i < B[0].length; i++) {
        Map<Integer, Integer> colB = new HashMap<>();
        for (int j = 0; j < B.length; j++) {
          if (B[j][i] != 0) {
            colB.put(j, B[j][i]);
          }
        }
        if (colB.size() > 0) {
          mB.put(i, colB);
        }
      }
      return mB;
    }
}A 设计键 – 总结
设计键 – 总结
以下是一些关于设计键的方法的总结。
- 当字符串 / 数组中每个元素的顺序不重要时,可以使用
排序后的字符串 / 数组作为键。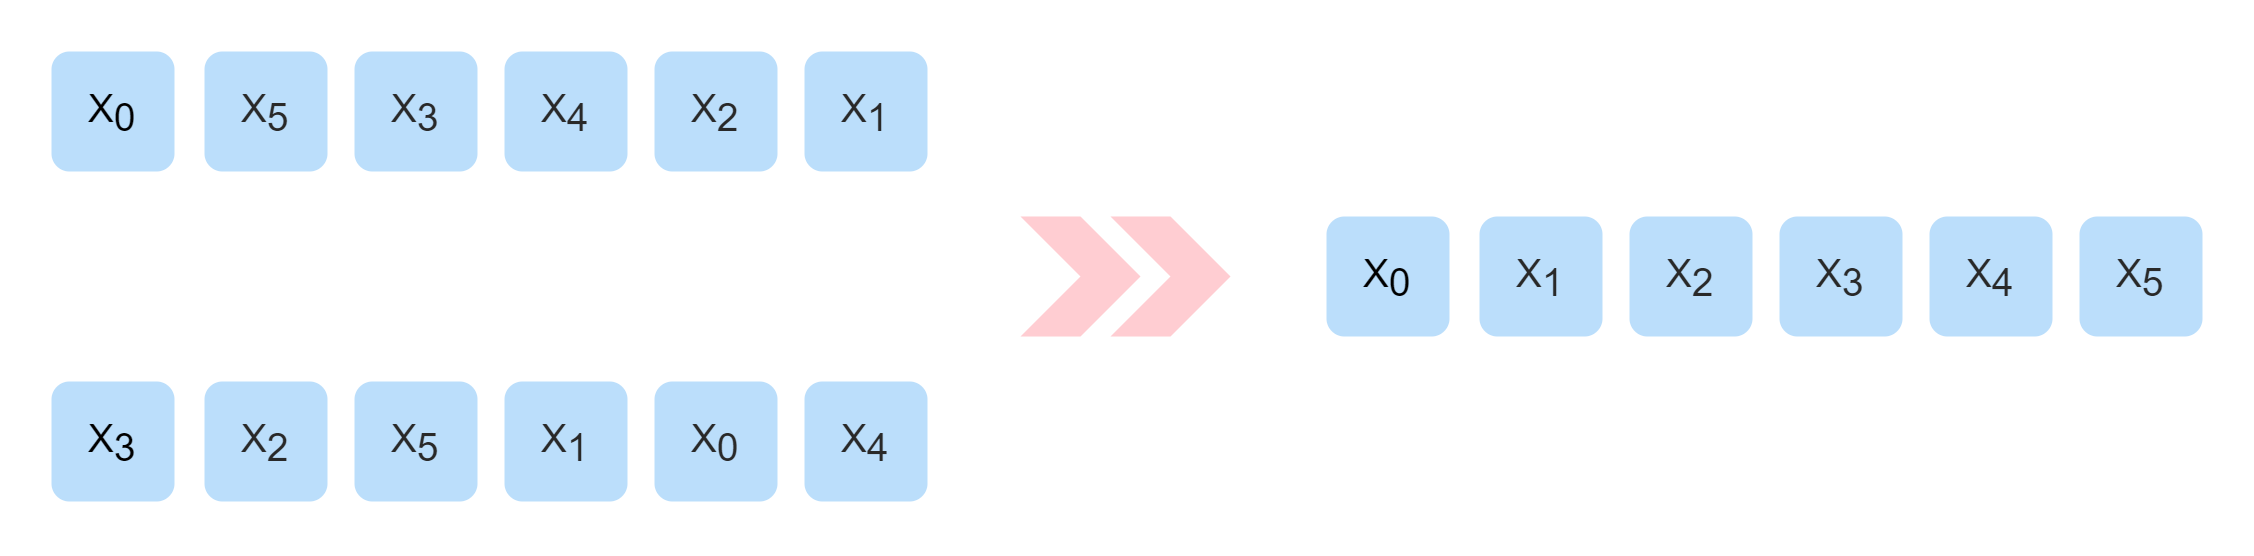
- 如果只关心每个值的偏移量,通常是第一个值的偏移量,则可以使用偏移量作为键。

- 在树的题目中,可以直接使用
TreeNode作为键。但在大多数情况下,可以将子树的序列化结果作为键。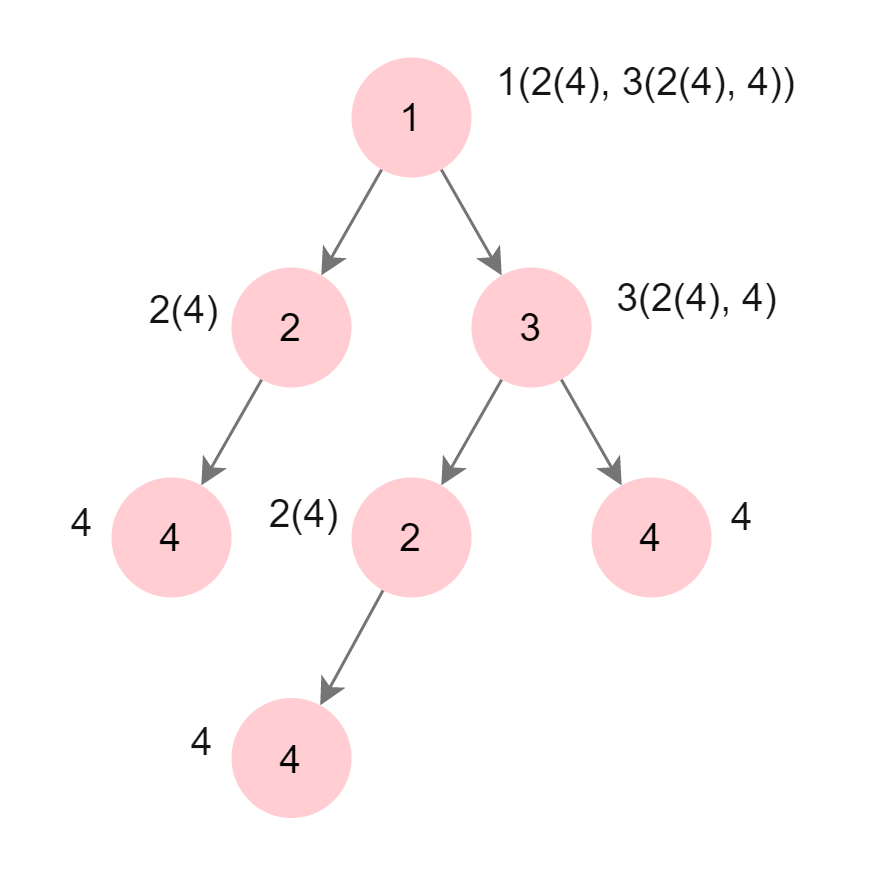
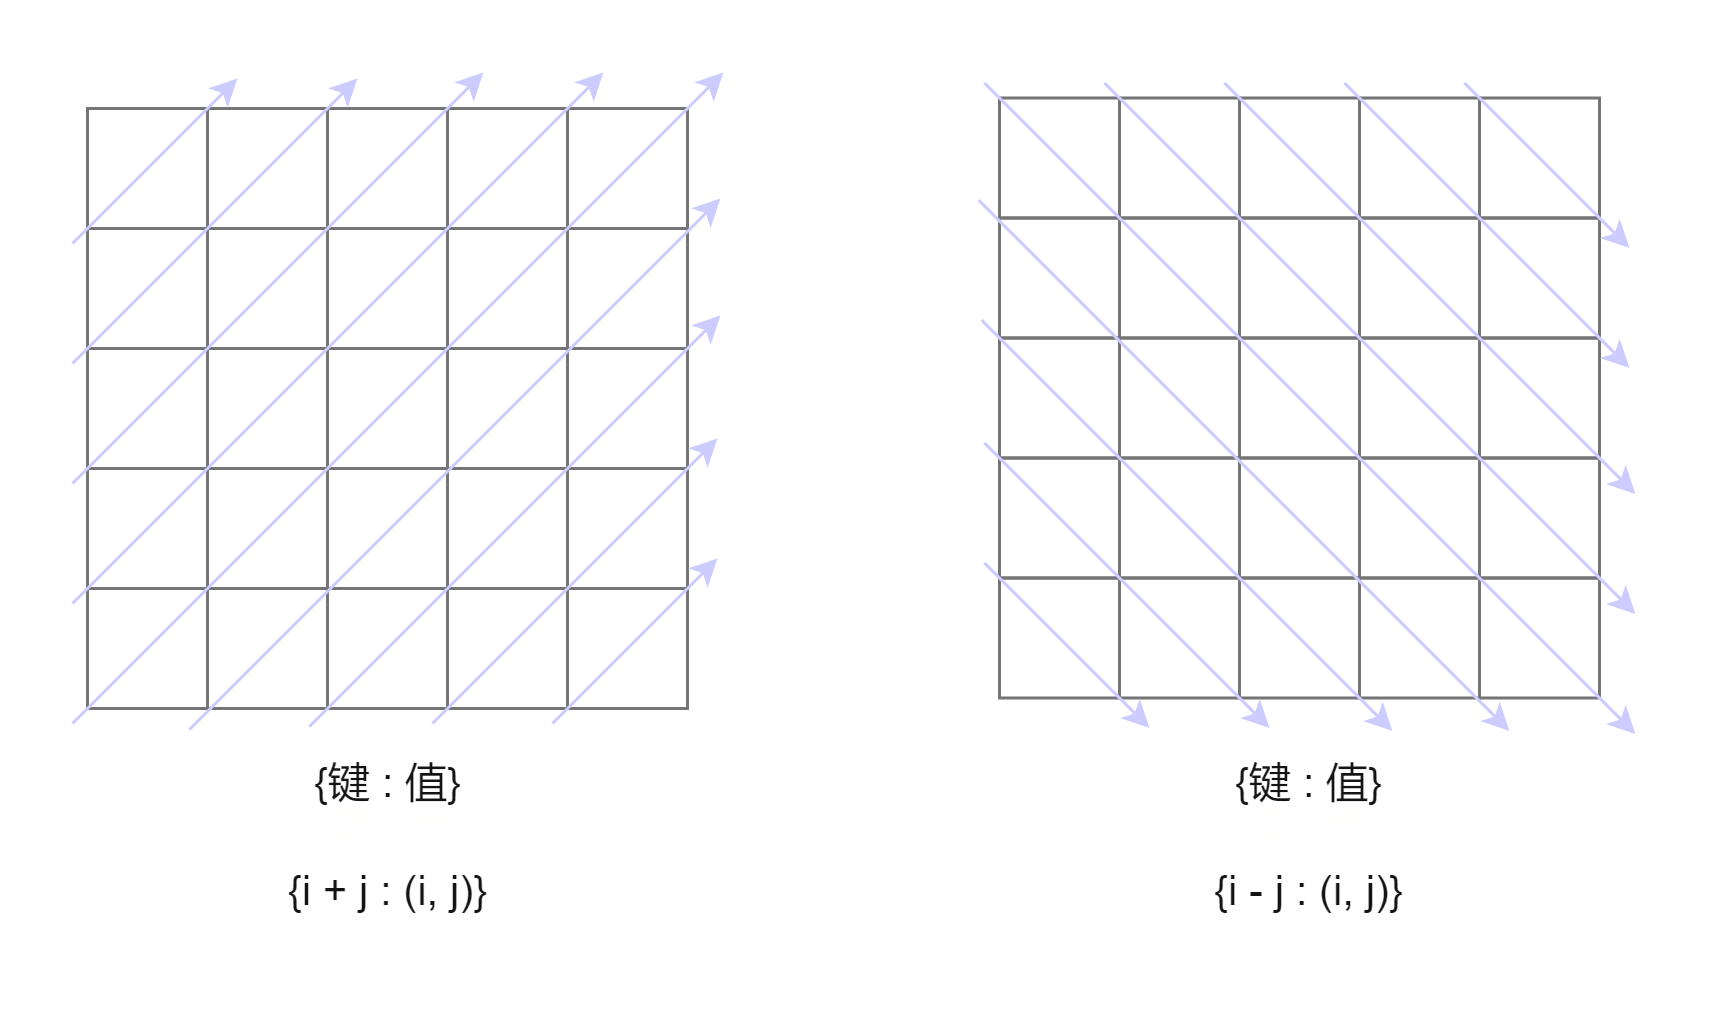
- 在矩阵中,你看可能会使用
行索引或列索引作为键。 - 如果需要将矩阵分块,可以将行索引和列索引进行组合以标识该元素属于哪个
块。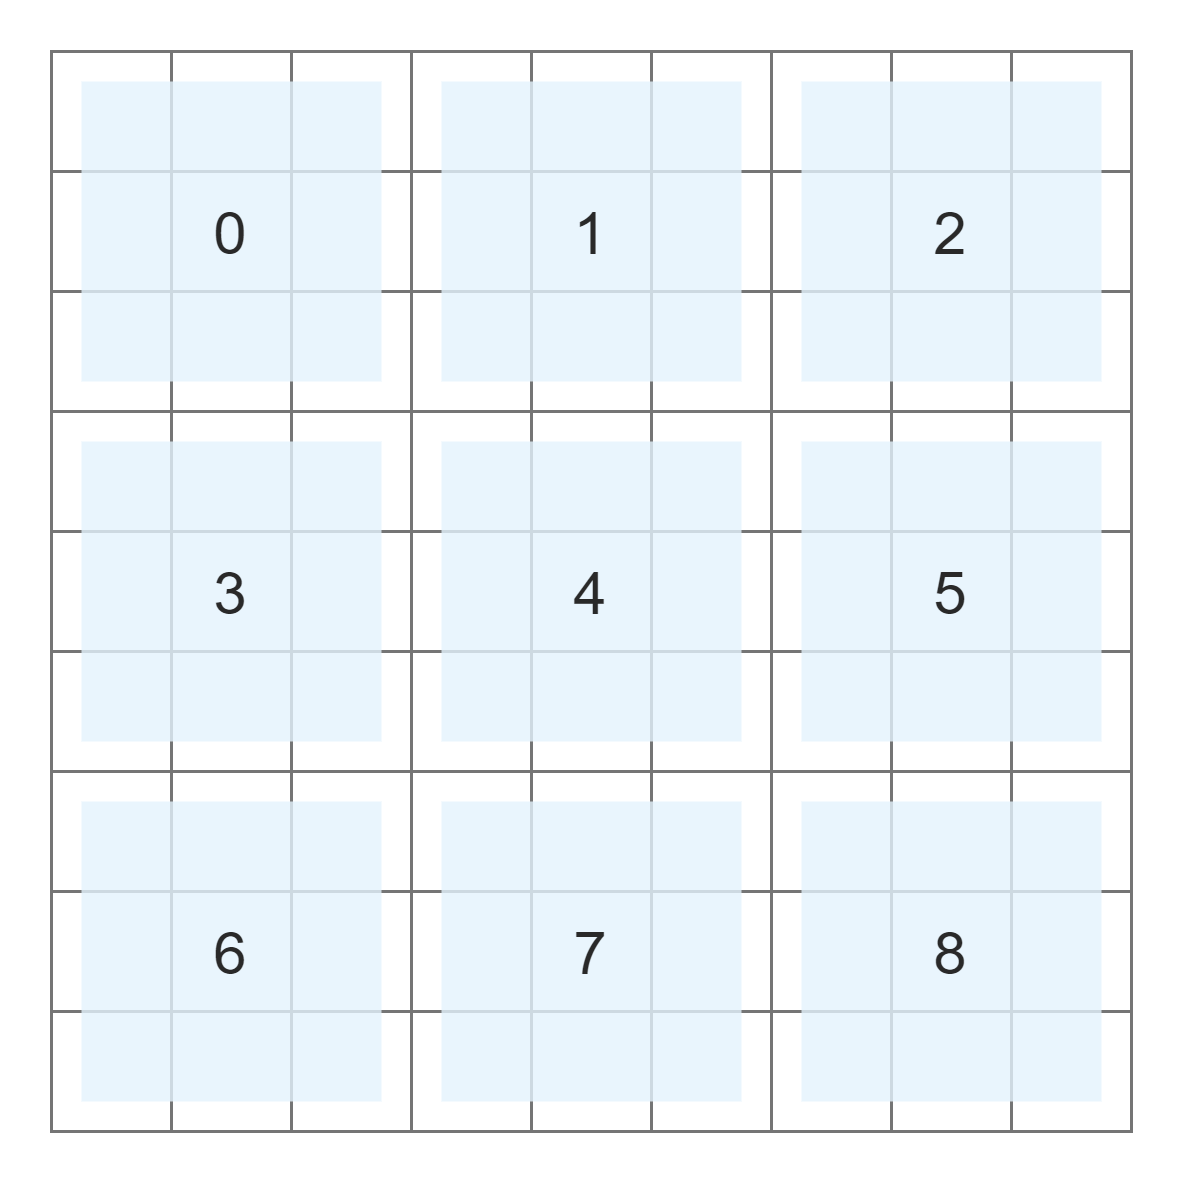
- 有时,在矩阵中,你可能会希望将对角线的元素组合在一起。
小结与讨论
相信你一定对 哈希表的原理和用法 有了全新的认识。
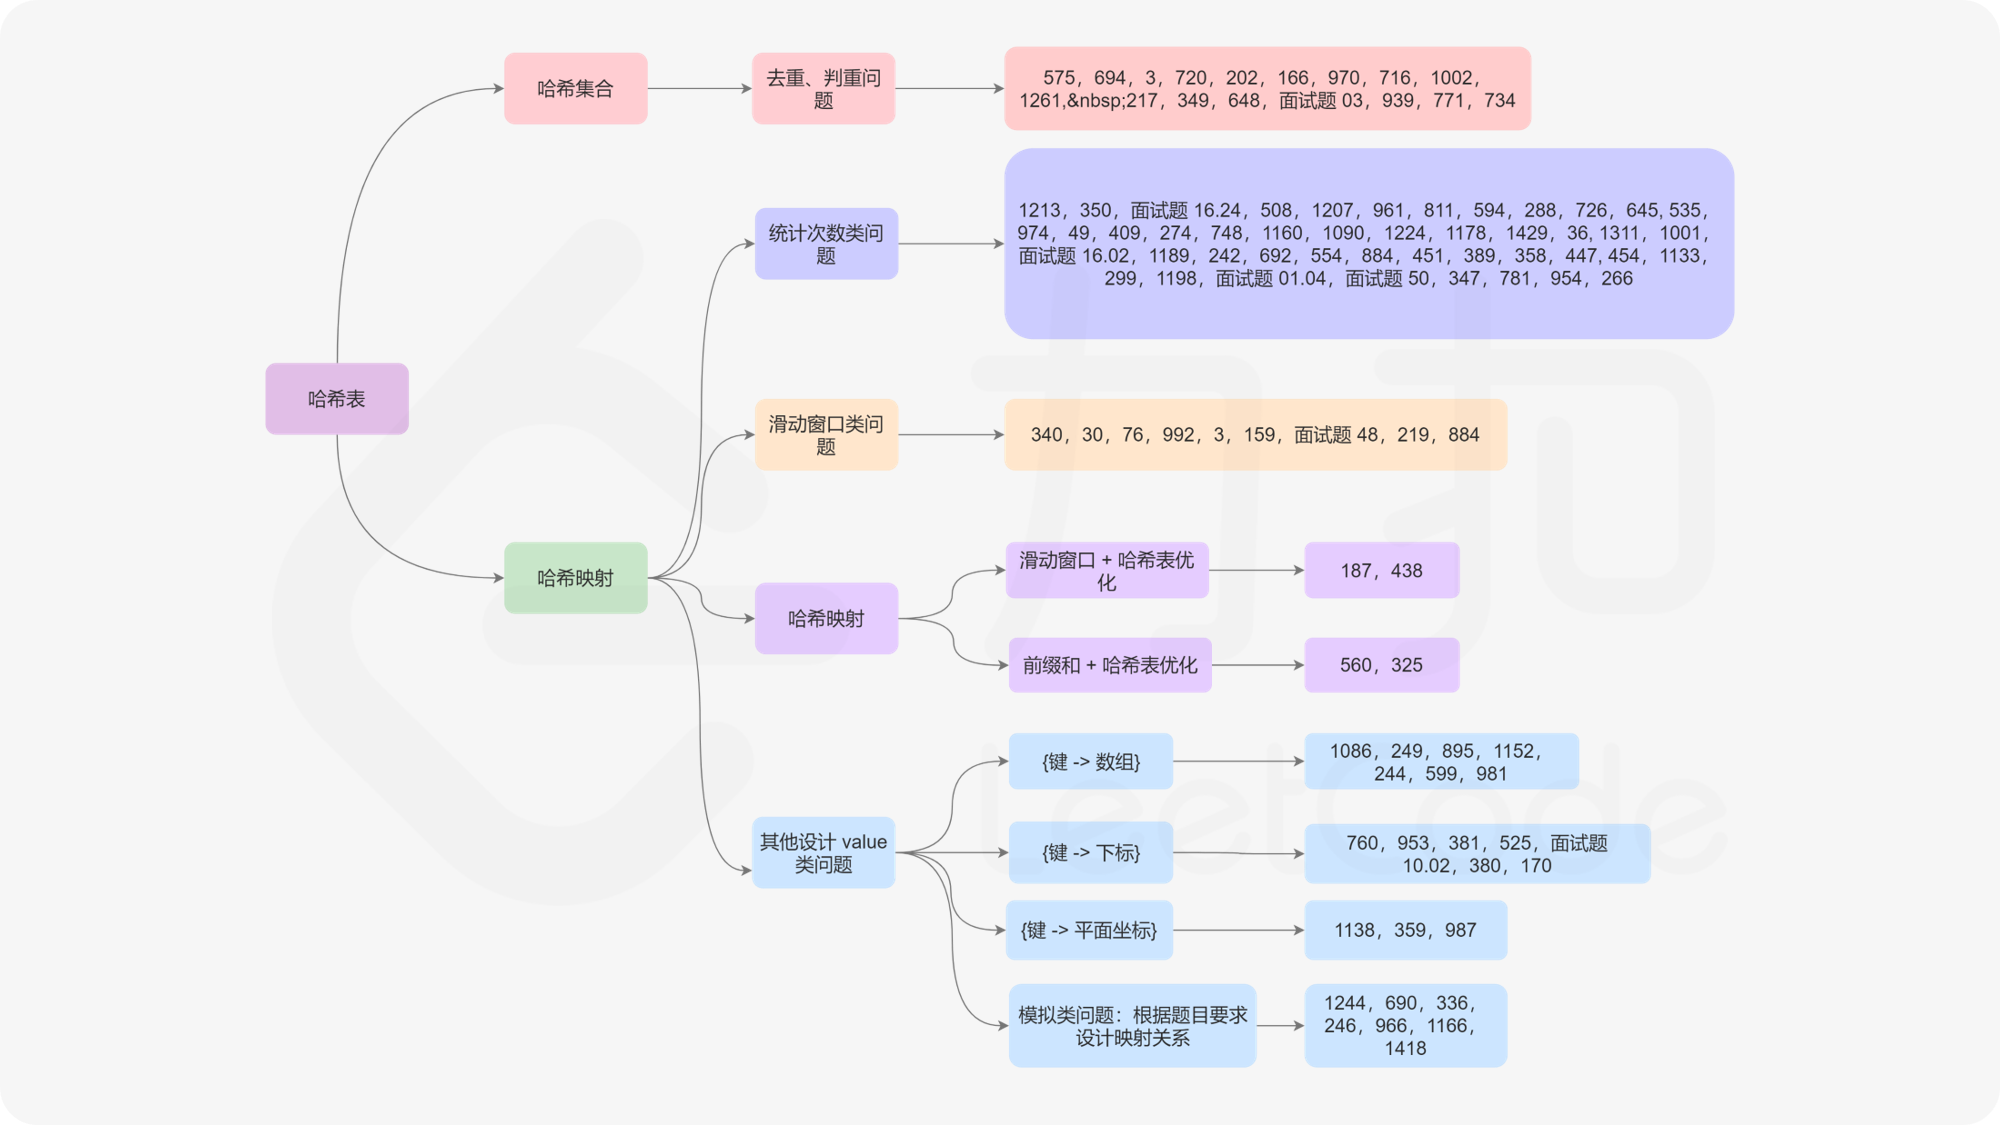
在前面的章节中,我们已经从三个方面讨论了 如何应用哈希表。在这里,我们将哈希表的习题进行整合,帮助你对相关习题形成较为清晰的框架。
更重要的是,我们有时会遇到更复杂的问题。我们可能需要:
- 使用多个哈希表
- 将哈希表与其他数据结构相结合
- 将哈希表与其他算法结合
- ……
最后我们在本章提供了一些练习。
LC 宝石与石头
给你一个字符串 jewels 代表石头中宝石的类型,另有一个字符串 stones 代表你拥有的石头。stones 中每个字符代表了一种你拥有的石头的类型,你想知道你拥有的石头中有多少是宝石。
字母区分大小写,因此 "a" 和 "A" 是不同类型的石头。
示例 1:
输入:jewels = "aA", stones = "aAAbbbb"
输出:3
示例 2:
输入:jewels = "z", stones = "ZZ"
输出:0
提示
1 <= jewels.length, stones.length <= 50jewles和stones仅由英文字母组成jewels中的所有字符都是 唯一的
题解
class Solution {
    public int numJewelsInStones(String jewels, String stones) {
        int jewelsCount = 0;
        Set<Character> jewelsSet = new HashSet<Character>();
        int jewelsLength = jewels.length(), stonesLength = stones.length();
        for (int i = 0; i < jewelsLength; i++) {
            char jewel = jewels.charAt(i);
            jewelsSet.add(jewel);
        }
        for (int i = 0; i < stonesLength; i++) {
            char stone = stones.charAt(i);
            if (jewelsSet.contains(stone)) {
                jewelsCount++;
            }
        }
        return jewelsCount;
    }
}
复杂度分析
- 时间复杂度:O(m+n),其中 m 是字符串 jewels 的长度,n 是字符串 stones 的长度。遍历字符串 jewels 将其中的字符存储到哈希集合中,时间复杂度是 O(m),然后遍历字符串 stones,对于 stones 中的每个字符在 O(1) 的时间内判断当前字符是否是宝石,时间复杂度是 O(n),因此总时间复杂度是 O(m+n)。
- 空间复杂度:O(m),其中 m 是 jewels 的长度。使用哈希集合存储字符串 jewels 中的字符。
LC 无重复字符的最长子串
给定一个字符串 s,请你找出其中不含有重复字符的 最长子串 的长度。
示例 1:
输入: s = "abcabcbb"
输出: 3
解释: 因为无重复字符的最长子串是 "abc",所以其长度为 3。
示例 2:
输入: s = "bbbbb"
输出: 1
解释: 因为无重复字符的最长子串是 "b",所以其长度为 1。
示例 3:
输入: s = "pwwkew"
输出: 3
解释: 因为无重复字符的最长子串是 "wke",所以其长度为 3。
请注意,你的答案必须是 子串 的长度,"pwke" 是一个子序列,不是子串。提示:
- 0 <= s.length <= 5*104
s由英文字母、数字、符号和空格组成
题解
查看题解
每次左指针右移一位,移除set的一个字符,会导致很多无用的循环,应直接用map记下每个字符的索引,若发现重复字符,直接进行跳转,并使用put进行索引的更新。
class Solution {
    public int lengthOfLongestSubstring(String s) {
      HashMap<Character, Integer> map = new HashMap<>();
      int maxlength = 0, left = 0;
      for(int right = 0; right < s.length(); right++) {
        char ch = s.charAt(right);
        if (map.containsKey(ch)) {
          left = Math.max(map.get(ch)+1, left);
        }
        maxlength = Math.max(maxlength, right - left + 1);
        map.put(ch, right);
      }
      return maxlength;
    }
}
LC 两数之和 Ⅲ – 数据结构设计
设计一个接收整数流的数据结构,该数据结构支持检查是否存在两数之和等于特定值。
实现 TwoSum 类:
TwoSum()使用空数组初始化TwoSum对象void add(int number)向数据结构添加一个数numberboolean find(int value)寻找数据结构中是否存在一对整数,使得两数之和与给定的值相等。如果存在,返回true;否则,返回false。
示例:
输入:
["TwoSum", "add", "add", "add", "find", "find"]
[[], [1], [3], [5], [4], [7]]
输出:
[null, null, null, null, true, false]
解释:
TwoSum twoSum = new TwoSum();
twoSum.add(1);   // [] --> [1]
twoSum.add(3);   // [1] --> [1,3]
twoSum.add(5);   // [1,3] --> [1,3,5]
twoSum.find(4);  // 1 + 3 = 4,返回 true
twoSum.find(7);  // 没有两个整数加起来等于 7 ,返回 false
提示:
- -105 <= number <= 105
- -231 <= value <= 231 – 1
- 最多调用 104 次
add和find
题解
查看题解
给定一个目标值 S,对于每个数字 a,我们只需要验证哈希表中是否存在 S-a。哈希表可以提供快速的查找和插入操作,非常适合上述要求。
- 首先初始化一个哈希表。
- 在 add(number) 函数中:在哈希表中添加 number 到 number 频数之间的映射关系。
- 在 find(value) 函数中:遍历哈希表,对于每个键值 number,我们应该检查哈希表中是否存在 value – number。如果存在,终止循环并返回结果。
- 当 number = value – number 时,在哈希表中 number 对应的值应大于 2.
class TwoSum {
  private HashMap<Integer, Integer> numCounts;
    public TwoSum() {
      this.numCounts = new HashMap<Integer, Integer>();
    }

    public void add(int number) {
      if (this.numCounts.containsKey(number)) {
        this.numCounts.replace(number, this.numCounts.get(number) + 1);
      }
      else {
        this.numCounts.put(number, 1);
      }
    }

    public boolean find(int value) {
      for (Map.Entry<Integer, Integer> entry : this.numCounts.entrySet()) {
        int complement = value - entry.getKey();
        if (complement != entry.getKey()) {
          if (this.numCounts.containsKey(complement)) {
            return true;
          }
        }
        else {
          if (entry.getValue() > 1){
            return true;
          }
        }
      }
      return false;
    }
}

/**
 * Your TwoSum object will be instantiated and called as such:
 * TwoSum obj = new TwoSum();
 * obj.add(number);
 * boolean param_2 = obj.find(value);
 */
复杂度分析
- 时间复杂度:
- 在
add(number)中:O(1),只进行了哈希表的更新。 - 在
find(value)中:O(N),其中 N 指的是哈希表中键值对的数量。在最坏的情况下,会遍历整个表。
- 在
- 空间复杂度:O(N),哈希表所使用的空间大小。
LC 四数相加 Ⅱ
给你四个整数数组 nums1、nums2、nums3 和 nums4,数组长度都是 n,请你计算有多少个元组 (i, j, k, l) 能满足:
0 <= i, j, k, l < nnums[i] + nums2[j] + nums3[k] + nums4[l] == 0
示例 1:
输入:nums1 = [1,2], nums2 = [-2,-1], nums3 = [-1,2], nums4 = [0,2]
输出:2
解释:
两个元组如下:
1. (0, 0, 0, 1) -> nums1[0] + nums2[0] + nums3[0] + nums4[1] = 1 + (-2) + (-1) + 2 = 0
2. (1, 1, 0, 0) -> nums1[1] + nums2[1] + nums3[0] + nums4[0] = 2 + (-1) + (-1) + 0 = 0
示例 2:
输入:nums1 = [0], nums2 = [0], nums3 = [0], nums4 = [0]
输出:1
提示
n == nums1.lengthn == nums2.lengthn == nums3.lengthn == nums4.length1 <= n <= 200- -228 <= nums1[i], nums2[i], nums3[i], nums4[i] <= 228
题解
查看解析
我们可以将四个数组分成两部分,A 和 B 为一组,C 和 D 为一组。
对于 A 和 B,我们使用二重循环进行遍历,得到所有 A[i] + B[j] 的值并存入哈希映射中。对于每个键值对,键表示 A[i] + B[j],对应的值则是其出现的频次。
对于 C 和 D,我们同样用二重循环进行遍历,若 0-(C[k] + D[l]) 出现在哈希映射中,则将 0-(C[k] + D[l]) 对应的值(频次)累加进答案中。
class Solution {
    public int fourSumCount(int[] nums1, int[] nums2, int[] nums3, int[] nums4) {
       Map<Integer, Integer> countsAB = new HashMap<>();
       for (Integer i : nums1) {
         for (Integer j : nums2) {
           countsAB.put(i+j, countsAB.getOrDefault(i+j, 0) + 1);
         }
       }
       int res = 0;
       for (Integer i : nums3) {
         for (Integer j : nums4) {
           if (countsAB.containsKey(-i-j)) {
             res += countsAB.get(-i-j);
           }
         }
       }
       return res;
    }
}
复杂度分析
- 时间复杂度:O(n2)。我们使用了两次二重循环,时间复杂度均为 O(n2)。在循环中对哈希映射进行的修改以及查询操作的期望时间复杂度均为 O(1),因此总时间复杂度为 O(n2)。
- 空间复杂度:O(n2),即为哈希映射需要使用的空间。在最坏的情况下,
A[i] + B[j]的值均不相同,因此值的个数为 n2,也就需要 O(n2) 的空间。
LC 前 K 个高频元素
给你一个整数数组 nums 和一个整数 k,请你返回其中出现频率前 k 高的元素。你可以按 任意顺序 返回答案。
示例 1:
输入: nums = [1,1,1,2,2,3], k = 2
输出: [1,2]
示例 2:
输入: nums = [1], k = 1
输出: [1]提示:
- 1 <= nums.length <= 105
k的取值范围是[1, 数组中不相同的元素的个数]- 题目数据保证答案唯一,换句话说,数组中前
k个高频元素的集合是唯一的
进阶:你所设计算法的时间复杂度 必须 优于 O(n log n) ,其中 n 是数组大小。
题解
查看解析
题目最终需要返回的是前 k 个频率最大的元素,可以借助堆这种数据结构,对于 k 频率之后的元素不用再去处理,进一步优化时间复杂度。
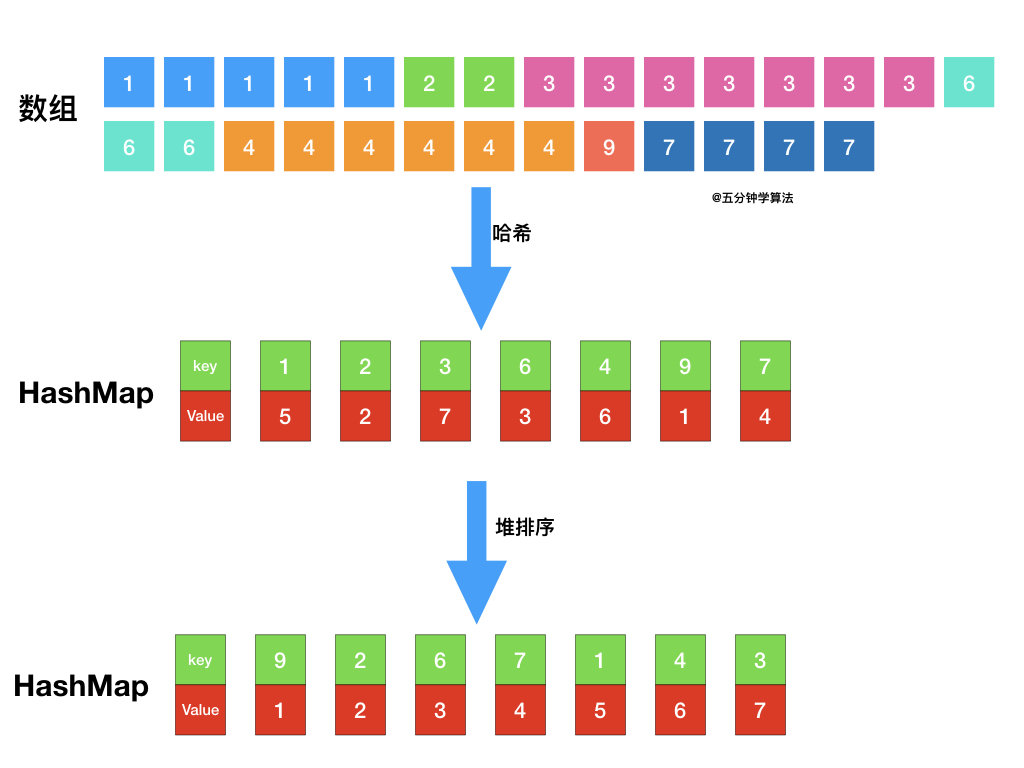
- 借助哈希表来建立数字和其出现次数的映射,遍历一遍数组统计元素的频率
- 维护一个元素数目为 k 的最小堆
- 每次都将新的元素与堆頂元素(堆中频率最小的元素)进行比较
- 如果新的元素频率比堆頂的元素大,则弹出堆顶端的元素,将新元素加入堆中
- 最后,堆中的 k 个元素即为前 k 个高频元素
class Solution {
  public int[] topKFrequent(int[] nums, int k) {
    // 设置一个map集合,key存放数字,value存放出现次数
    Map<Integer, Integer> map = new HashMap<>();
    // 统计出现次数
    for(int num : nums) {
      map.put(num, map.getOrDefault(num, 0) + 1);
    }
    // 建立小根堆,用来存放key值,堆内元素按照key对应的value值从大到小排序
    PriorityQueue<Integer> queue = new PriorityQueue<>(new Comparator<Integer>() {
      public int compare(Integer a, Integer b) {
        return map.get(a) - map.get(b);
      }
    });
    // 将map中的数字,插入到小根堆中
    for(Integer key : map.keySet()) {
      if(queue.size() < k) {
        queue.add(key);
      }
      else if(map.get(key) > map.get(queue.peek())) {
        queue.poll();
        queue.add(key);
      }
    }
    // 将小根堆中的k个数字放到数组中
    int[] res = new int[k];
    int index = 0;
    while(!queue.isEmpty()) {
      res[index++] = queue.poll();
    }
    return res;
  }
}Comparator Comparator 与 Comparable 区别
复杂度分析
- 时间复杂度:O(Nlogk),其中 N 为数组的长度。我们首先遍历原数组,并使用哈希表记录出现次数,每个元素需要 O(1) 的时间,共需 O(N) 的时间。随后,我们遍历 “出现次数数组”,由于堆的大小至多为 k,因此每次堆操作需要 O(logk) 的时间,共需 O(Nlogk) 的时间。
- 空间复杂度:O(N)。哈希表的大小为 O(N),堆的大小为 O(k),共计为 O(N)。
LC 单词的唯一缩写
单词的 缩写 需要遵循 <起始字母><中间字母数><结尾字母>这样的格式。如果单词只有两个字符,那么它就是它自身的 缩写。
以下是一些单词缩写的范例:
dog --> dig因为第一个字母"d"和最后一个字母"g"之间有1个字母internationallization --> il8n因为第一个字母"i"和最后一个字母"n"之间有18个字母it --> it单词只有两个字符,它就是它自身的 缩写
实现 ValidWordAbbr 类:
ValidWordAbbr(String[] dictionary)使用单词字典dictionary初始化对象boolean isUnique(string word)如果满足下述任意一个条件,返回true;否则,返回false:- 字典
dictionary中没有任何其他单词的 缩写 与该单词word的 缩写 相同 - 字典
dictionary中的所有 缩写 与该单词word的 缩写 相同的单词都与word相同。
- 字典
示例:
输入
["ValidWordAbbr", "isUnique", "isUnique", "isUnique", "isUnique", "isUnique"]
[[["deer", "door", "cake", "card"]], ["dear"], ["cart"], ["cane"], ["make"], ["cake"]]
输出
[null, false, true, false, true, true]

解释
ValidWordAbbr validWordAbbr = new ValidWordAbbr(["deer", "door", "cake", "card"]);
validWordAbbr.isUnique("dear"); // 返回 false,字典中的 "deer" 与输入 "dear" 的缩写都是 "d2r",但这两个单词不相同
validWordAbbr.isUnique("cart"); // 返回 true,字典中不存在缩写为 "c2t" 的单词
validWordAbbr.isUnique("cane"); // 返回 false,字典中的 "cake" 与输入 "cane" 的缩写都是 "c2e",但这两个单词不相同
validWordAbbr.isUnique("make"); // 返回 true,字典中不存在缩写为 "m2e" 的单词
validWordAbbr.isUnique("cake"); // 返回 true,因为 "cake" 已经存在于字典中,并且字典中没有其他缩写为 "c2e" 的单词
提示:
- 1 <= dictionary.length <= 3 * 104
1 <= dictionary[i].length <= 20dictionary[i]由小写英文字母组成1 <= word <= 20word由小写英文字母组成- 最多调用
5000次isUnique
题解
方法一:哈希表
查看题解
注意到 isUnique 对同样集合的单词每次调用都要重新计算,我们可以预处理字典来加速。理想状态下,哈希表支持常数时间的查找,那么键值对应该是怎样呢?
其实想法就是把相同缩写的单词分成同一组。对于值,我们建立一个 Set 而不是一个 List 来保证唯一性。
isUnique(word) 需要考虑以下情况:
- 单词的缩写是否在字典中出现过?
- 若没有,则它就是唯一的
- 若出现过,它是唯一的条件是:这个组里除了它本身 word 以外没有其他任何单词。
public class ValidWordAbbr {
    private final Map<String, Set<String>> abbrDict = new HashMap<>();

    public ValidWordAbbr(String[] dictionary) {
        for (String s : dictionary) {
            String abbr = toAbbr(s);
            Set<String> words = abbrDict.containsKey(abbr)
                ? abbrDict.get(abbr) : new HashSet<>();
            words.add(s);
            abbrDict.put(abbr, words);
        }
    }

    public boolean isUnique(String word) {
        String abbr = toAbbr(word);
        Set<String> words = abbrDict.get(abbr);
        return words == null || (words.size() == 1 && words.contains(word));
    }

    private String toAbbr(String s) {
        int n = s.length();
        if (n <= 2) {
            return s;
        }
        return s.charAt(0) + Integer.toString(n - 2) + s.charAt(n - 1);
    }
}
方法二:哈希表(2)
查看题解
我们使用一个计数器作为表的值。比方说,假设字典为 [“door”,”deer”],我们可以得到映射 {“d2r” -> 2}。然而,这个映射是不够的,因为我们需要考虑每个单词是否有其他相同的单词出现在字典里。这个问题通过把整个字典插入一个 set 里可以轻松判断。
当一个缩写出现的次数超过一次,我们知道这个缩写肯定不是唯一的,因为至少有两个不一样的单词有同样的缩写。因此,我们进一步可以把计数器变成一个 boolean 值变量。
class ValidWordAbbr {
    private final Map<String, Boolean> abbrDict = new HashMap<>();
    private final Set<String> dict;
    public ValidWordAbbr(String[] dictionary) {
      dict = new HashSet<>(Arrays.asList(dictionary));
      for (String s: dict) {
        String abbr = toAbbr(s);
        abbrDict.put(abbr, !abbrDict.containsKey(abbr));
      }
    }

    public boolean isUnique(String word) {
      String abbr = toAbbr(word);
      Boolean hasAbbr = abbrDict.get(abbr);
      return hasAbbr == null || (hasAbbr && dict.contains(word));
    }

    private String toAbbr(String s) {
      int n = s.length();
      if (n <= 2) {
        return s;
      }
      return s.charAt(0) + Integer.toString(n-2) + s.charAt(n-1);
    }
}

/**
 * Your ValidWordAbbr object will be instantiated and called as such:
 * ValidWordAbbr obj = new ValidWordAbbr(dictionary);
 * boolean param_1 = obj.isUnique(word);
*/复杂度分析
- 时间复杂度:O(n) 的预处理,每次调用
isUnique()函数 O(1)。方法一 和 方法二 都需要 O(n) 的时间预处理。但 方法二 在isUnique被多次调用的时候表现更好。 - 空间复杂度:O(n),我们用额外的 O(n) 空间保存哈希表来减少
isUnique被调用时的时间复杂度。
实现 RandomizedSet 类:
RandomizedSet()初始化RandomizedSet对象bool insert(int val)当元素val不存在时,向集合中插入该项,并返回ture;否则,返回false。bool remove(int val)当元素val存在时,从集合中移除该项,并返回ture;否则返回false。int getRandom()随机返回现有集合中的一项(测试用例保证调用此方法时集合中至少存在一个元素)。每个元素应该有 相同的概率 被返回。
你必须实现类的所有函数,并满足每个函数的 平均 时间复杂度为 O(1)。
示例:
["RandomizedSet", "insert", "remove", "insert", "getRandom", "remove", "insert", "getRandom"]
[[], [1], [2], [2], [], [1], [2], []]
输出
[null, true, false, true, 2, true, false, 2]
解释
RandomizedSet randomizedSet = new RandomizedSet();
randomizedSet.insert(1); // 向集合中插入 1 。返回 true 表示 1 被成功地插入。
randomizedSet.remove(2); // 返回 false ,表示集合中不存在 2 。
randomizedSet.insert(2); // 向集合中插入 2 。返回 true 。集合现在包含 [1,2] 。
randomizedSet.getRandom(); // getRandom 应随机返回 1 或 2 。
randomizedSet.remove(1); // 从集合中移除 1 ,返回 true 。集合现在包含 [2] 。
randomizedSet.insert(2); // 2 已在集合中,所以返回 false 。
randomizedSet.getRandom(); // 由于 2 是集合中唯一的数字,getRandom 总是返回 2 。提示:
- -231 <= val <= 231 – 1
- 最多调用
insert、remove、 和getRandom函数 2 * 105 次 - 在调用
getRandom方法时,数据结构中 至少存在一个 元素。
题解
方法:变长数组 + 哈希表
查看题解
变长数组可以在 O(1) 的时间内完成获取随机元素操作,但是无法在 O(1) 的时间内判断元素是否存在;哈希表能在 O(1) 的时间内判断元素是否存在,但因为无法根据下标定位到特定元素,因此不能在 O(1) 的时间内完成获取随机元素操作。为了满足题目要求,需要将变长数组与哈希表结合,变长数组中存储元素,哈希表中存储每个元素在变长数组中的下标。
class RandomizedSet {
    List<Integer> nums;
    Map<Integer, Integer> indices;
    Random random;

    public RandomizedSet() {
        nums = new ArrayList<Integer>();
        indices = new HashMap<Integer, Integer>();
        random = new Random();
    }

    public boolean insert(int val) {
        if (indices.containsKey(val)) {
            return false;
        }
        int index = nums.size();
        nums.add(val);
        indices.put(val, index);
        return true;
    }

    public boolean remove(int val) {
        if (!indices.containsKey(val)) {
            return false;
        }
        int index = indices.get(val);
        int last = nums.get(nums.size() - 1);
        nums.set(index, last);
        indices.put(last, index);
        nums.remove(nums.size() - 1);
        indices.remove(val);
        return true;
    }

    public int getRandom() {
        int randomIndex = random.nextInt(nums.size());
        return nums.get(randomIndex);
    }
}
复杂度分析
- 时间复杂度:初始化和各项操作的时间复杂度都是 O(1)。
- 空间复杂度:O(n),其中 n 是集合中的元素个数。存储元素的数组和哈希表都需要 O(n) 的空间。
