共计 40779 个字符,预计需要花费 102 分钟才能阅读完成。
队列 & 栈
概述
在数组中,可以通过索引访问 随机 元素。但是,某些情况下,可能需要限制处理的顺序。
在本章中,将会介绍两种不同的处理顺序,先入先出 和 后入先出;以及两个相应的线性数据结构,队列 和 栈。
我们将详细介绍每个数据结构的定义,实现和内置函数。更多的关注者两种数据结构的实际应用。
在本章中,你将:
- 了解 FIFO 和 LIFO 处理顺序的原理;
- 实现这两个数据结构;
- 熟悉内置的队列和栈结构;
- 解决基本的队列相关问题,尤其是
BFS; - 解决基本的栈相关问题;
- 理解在使用
DFS和其他递归算法来解决问题时,系统栈是如何发挥作用的。
队列:先入先出的数据结构
本章节中,我们将首先介绍 先入先出(FIFO)及其在队列中的工作方式。
本章可以帮助你:
- 理解 FIFO 和队列的
定义; - 能够自己
实现队列; - 熟悉
内置队列结构; - 使用队列来解决简单的问题。
A 先入先出的数据结构
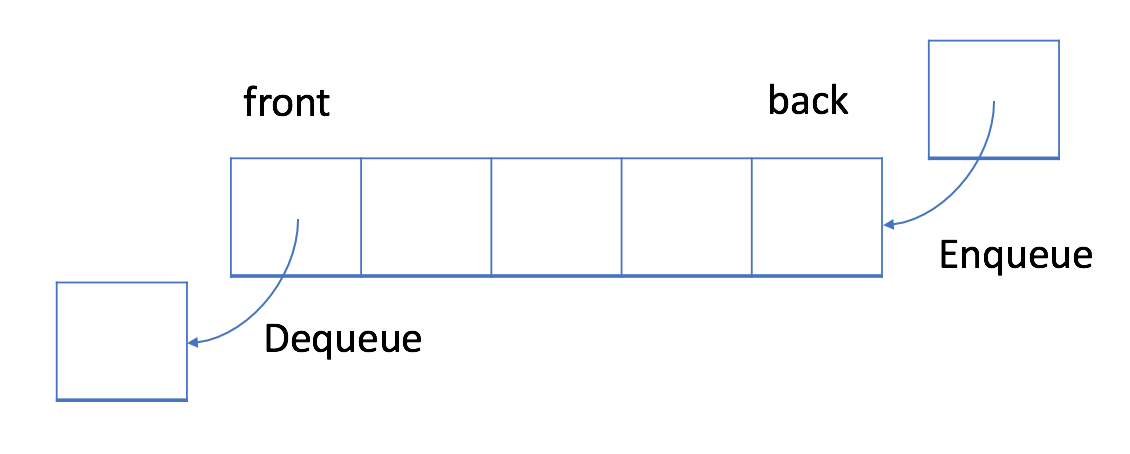
在 FIFO 数据结构中,将 首先处理添加到队列中的第一个元素。
如上图所示,队列是典型的 FIFO 数据结构。插入(insert)操作也称作入队(enqueue),新元素始终被添加在 队列的末尾。删除(delete)操作也被称作出队(dequeue)。你只能移除 第一个元素
A 队列 – 实现
为了实现队列,我们可以使用动态数组和指向队列头部的索引。
如上所述,队列应支持两种操作:入队和出队。入队会向队列追加一个新元素,而出队会删除第一个元素。所以我们需要一个索引来指出起点。
参考:
// "static void main" must be defined in a public class.
class MyQueue {
// store elements
private List<Integer> data;
// a pointer to indicate the start position
private int p_start;
public MyQueue() {
data = new ArrayList<Integer>();
p_start = 0;
}
/** Insert an element into the queue. Return true if the operation is successful. */
public boolean enQueue(int x) {
data.add(x);
return true;
};
/** Delete an element from the queue. Return true if the operation is successful. */
public boolean deQueue() {
if (isEmpty() == true) {
return false;
}
p_start++;
return true;
}
/** Get the front item from the queue. */
public int Front() {
return data.get(p_start);
}
/** Checks whether the queue is empty or not. */
public boolean isEmpty() {
return p_start >= data.size();
}
};
public class Main {
public static void main(String[] args) {
MyQueue q = new MyQueue();
q.enQueue(5);
q.enQueue(3);
if (q.isEmpty() == false) {
System.out.println(q.Front());
}
q.deQueue();
if (q.isEmpty() == false) {
System.out.println(q.Front());
}
q.deQueue();
if (q.isEmpty() == false) {
System.out.println(q.Front());
}
}
}缺点
上面的实现很简单,但在某些情况下效率很低。随着起始指针的移动,浪费了越来越多的空间。当我们有空间限制时,这将是难以接受的。
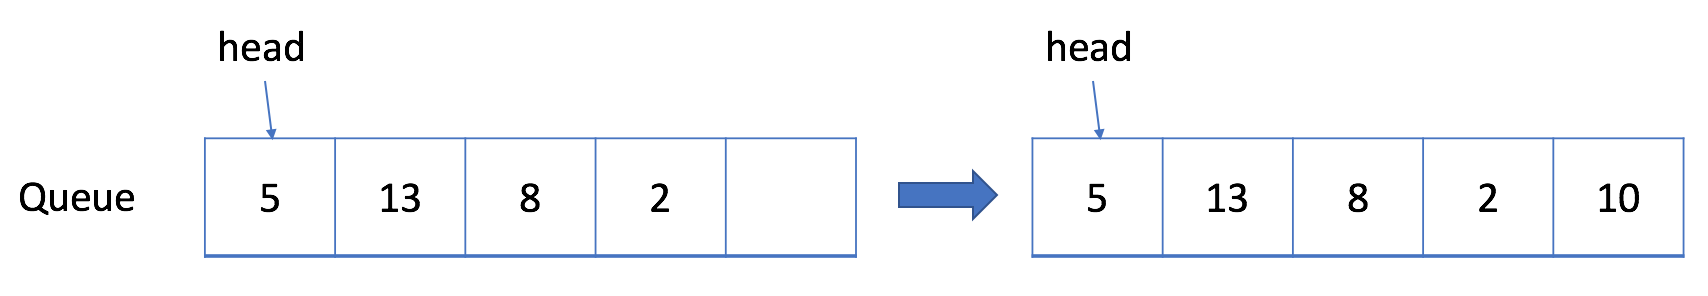
让我们考虑一种情况,即我们只能分配一个最大长度为 5 的数组。当我们只添加少于 5 个元素时,我们的解决方案很有效。例如,如果我们只调用入队函数四次后还想要将元素 10 入队,那么我们可以成功。
但是我们不能接受更多的入队请求,这是合理的,因为现在队列已经满了。但是如果我们将一个元素出队呢?
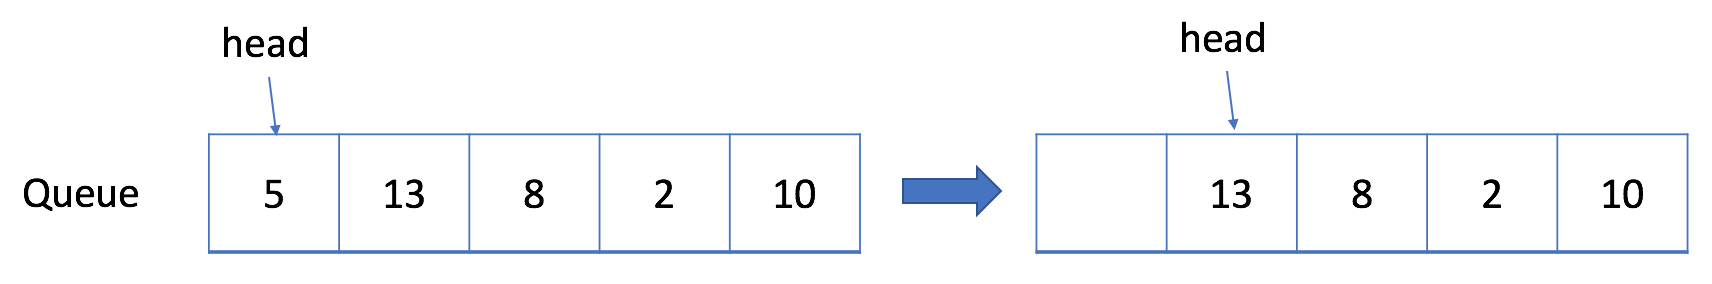
实际上,在这种情况下,我们应该能够再接受一个元素。
A 循环队列
此前,我们提供了一种简单但低效的队列实现。
更有效的方法是使用循环队列。具体来说,我们可以使用 固定大小的数组 和 两个指针 来指示起始位置和结束位置。目的是 重用 我们之前提到的 被浪费的存储。
让我们通过一个示例来查看循环队列的工作原理。你应该注意我们 入队 或 出队 元素时使用的策略。
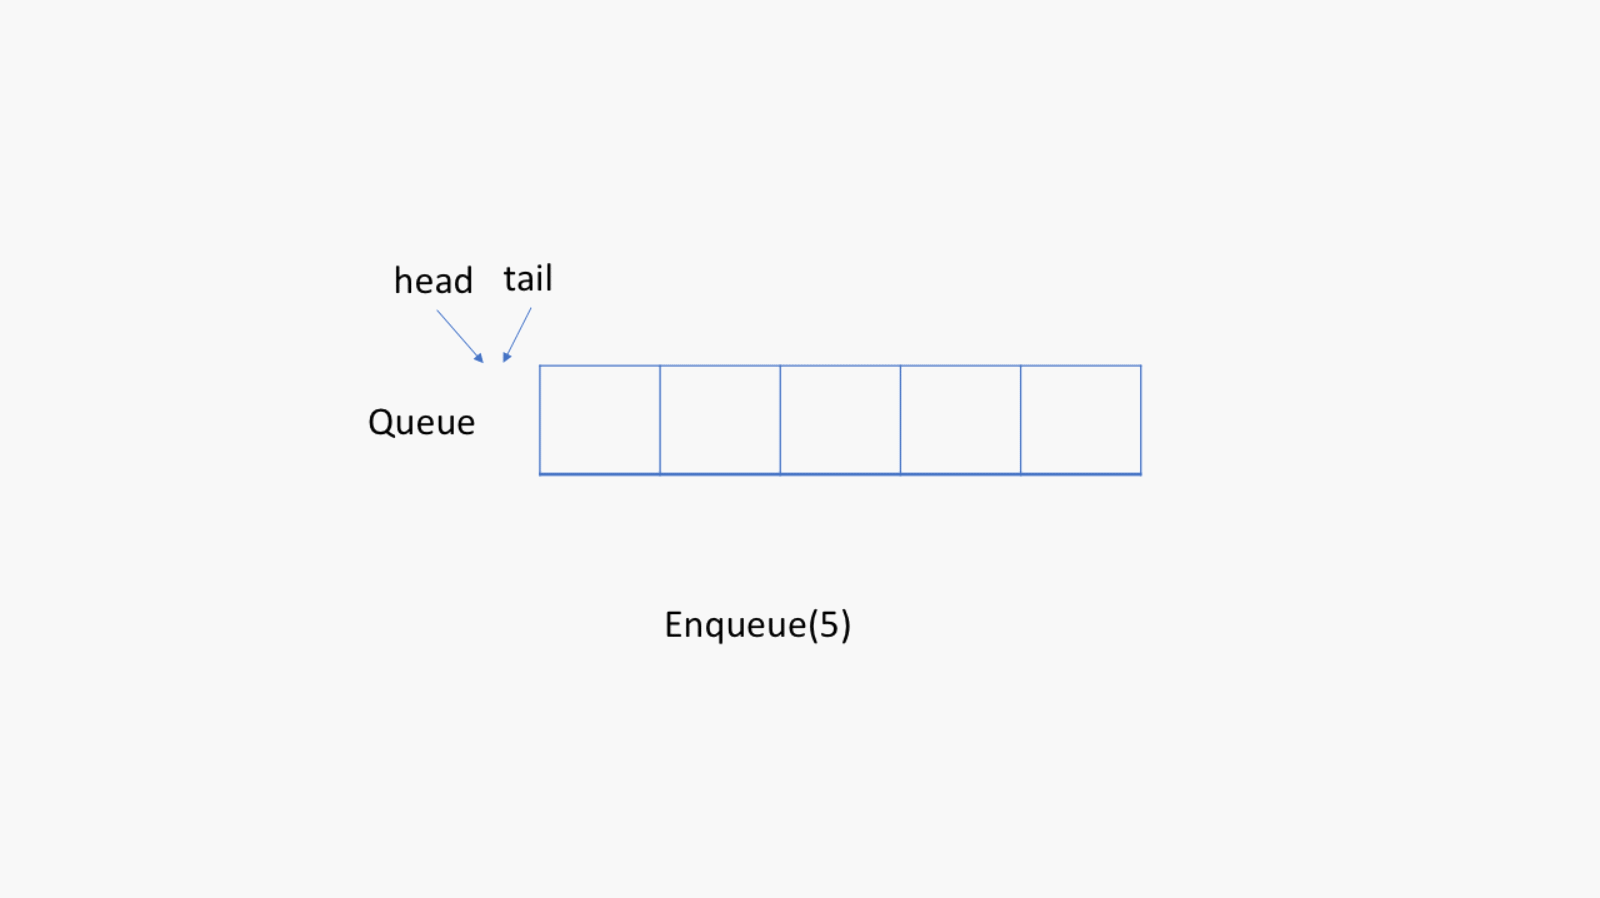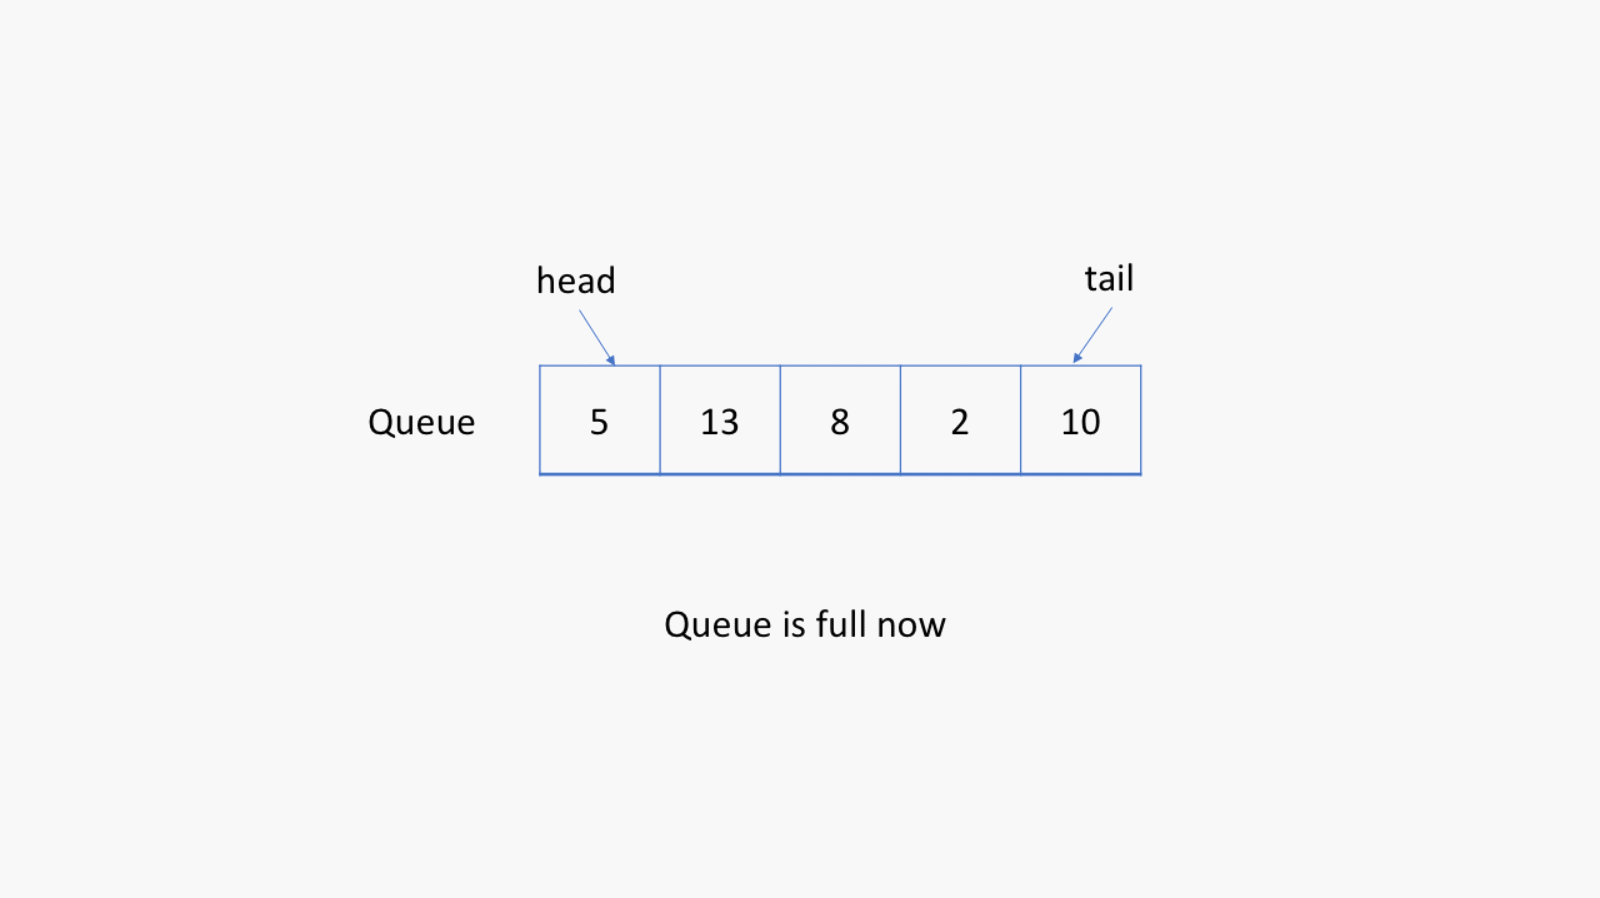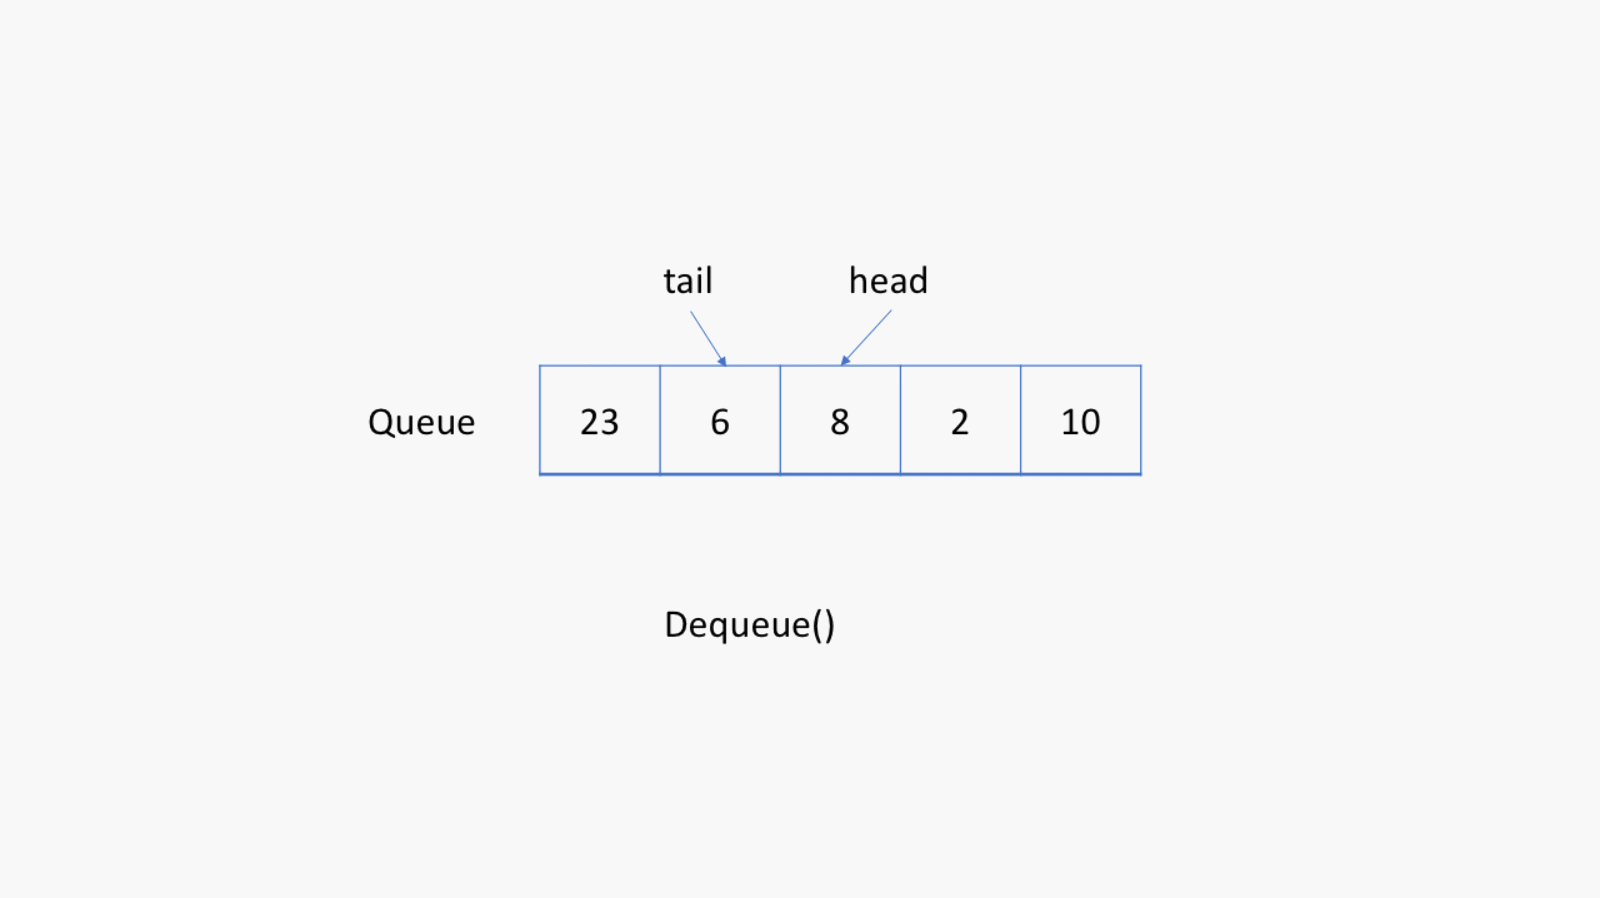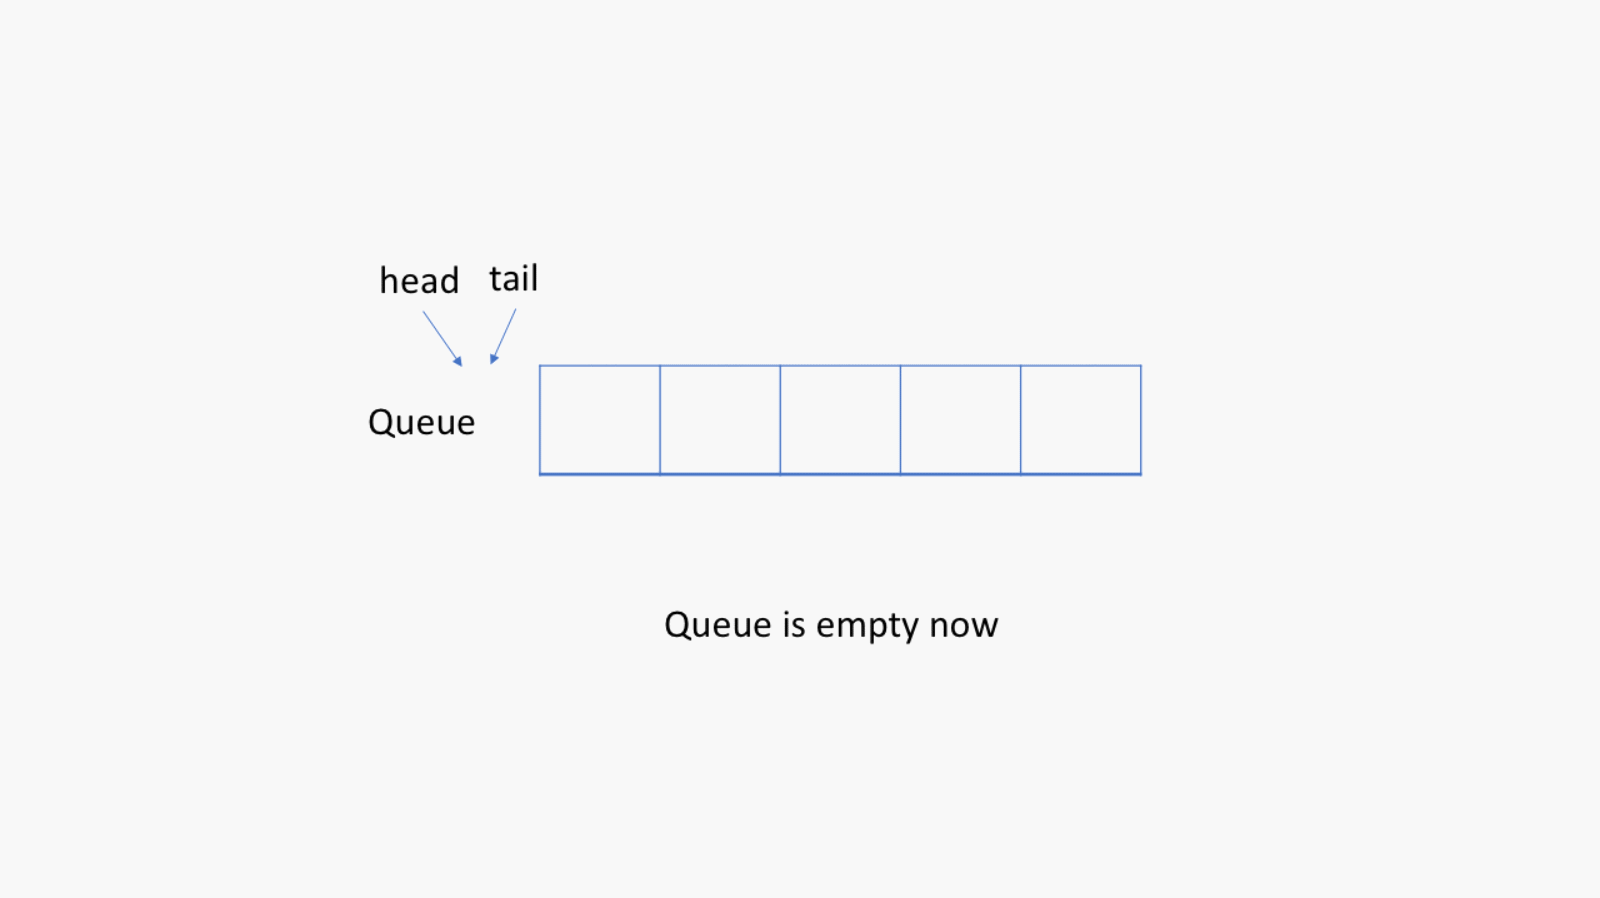
查看动画,找出我们用来检查队列是 空 还是 满 的策略。
LC 设计循环队列
设计你的循环队列实现。 循环队列是一种线性数据结构,其操作表现基于 FIFO(先进先出)原则并且队尾被连接在队首之后以形成一个循环。它也被称为“环形缓冲器”。
循环队列的一个好处是我们可以利用这个队列之前用过的空间。在一个普通队列里,一旦一个队列满了,我们就不能插入下一个元素,即使在队列前面仍有空间。但是使用循环队列,我们能使用这些空间去存储新的值。
你的实现应该支持如下操作:
MyCircularQueue(k): 构造器,设置队列长度为 k 。Front: 从队首获取元素。如果队列为空,返回 -1 。Rear: 获取队尾元素。如果队列为空,返回 -1 。enQueue(value): 向循环队列插入一个元素。如果成功插入则返回真。deQueue(): 从循环队列中删除一个元素。如果成功删除则返回真。isEmpty(): 检查循环队列是否为空。isFull(): 检查循环队列是否已满。
示例:
 MyCircularQueue circularQueue = new MyCircularQueue(3); // 设置长度为 3
 circularQueue.enQueue(1);  // 返回 true
 circularQueue.enQueue(2);  // 返回 true
 circularQueue.enQueue(3);  // 返回 true
 circularQueue.enQueue(4);  // 返回 false,队列已满
 circularQueue.Rear();  // 返回 3
 circularQueue.isFull();  // 返回 true
 circularQueue.deQueue();  // 返回 true
 circularQueue.enQueue(4);  // 返回 true
circularQueue.Rear(); // 返回 4提示:
- 所有的值都在 0 至 1000 的范围内;
- 操作数将在 1 至 1000 的范围内;
- 请不要使用内置的队列库。
题解
方法一:数组
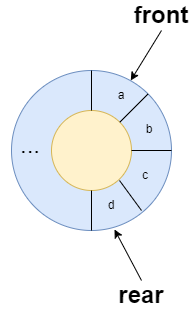
在循环队列中,当队列为空时和队列空间占满时都有 front = rear。为了区分这两种情况,假设队列使用的数组有 capacity 个存储空间,则此时规定循环队列中最多只能有 capacity – 1 个队列元素,当循环队列中只剩下一个空存储单元时,则表示队列已满。查看队列设计思路
 class MyCircularQueue {
     private int front;
     private int rear;
     private int capacity;
     private int[] elements;
     // 初始化队列
     public MyCircularQueue(int k) {
         capacity = k + 1;
         elements = new int[capacity];
         rear = front = 0;
     }
     // 入队
     public boolean enQueue(int value) {
         if (isFull()) {
             return false;
         }
         elements[rear] = value;
         rear = (rear + 1) % capacity;
         return true;
     }
     // 出队
     public boolean deQueue() {
         if (isEmpty()) {
             return false;
         }
         front = (front + 1) % capacity;
         return true;
     }
     // 返回队首元素
     public int Front() {
         if (isEmpty()) {
             return -1;
         }
         return elements[front];
     }
     // 返回队尾元素
     public int Rear() {
         if (isEmpty()) {
             return -1;
         }
         return elements[(rear - 1 + capacity) % capacity];
     }
     // 检查队列是否为空
     public boolean isEmpty() {
         return rear == front;
     }
     // 检查队列是否已满
     public boolean isFull() {
         return ((rear + 1) % capacity) == front;
     }
 }
复杂度分析
- 时间复杂度:初始化和每项操作的时间复杂度均为 O(1)。
- 空间复杂度:O(k),其中 k 为给定的队列元素数目。
方法二:链表
class MyCircularQueue {
private ListNode head;
private ListNode tail;
private int capacity; // 队列容量
private int size; // 队列当前元素数量
public MyCircularQueue(int k) {
capacity = k;
size = 0;
}
public boolean enQueue(int value) {
if (isFull()) {
return false;
}
ListNode node = new ListNode(value);
if (head == null) {
head = tail = node;
} else {
tail.next = node;
tail = node;
}
size++;
return true;
}
public boolean deQueue() {
if (isEmpty()) {
return false;
}
ListNode node = head;
head = head.next;
size--;
return true;
}
public int Front() {
if (isEmpty()) {
return -1;
}
return head.val;
}
public int Rear() {
if (isEmpty()) {
return -1;
}
return tail.val;
}
public boolean isEmpty() {
return size == 0;
}
public boolean isFull() {
return size == capacity;
}
}复杂度分析
- 时间复杂度: 初始化和每项操作的时间复杂度均为 O(1)。
- 空间复杂度:O(k),其中 k 为给定的队列元素数目。
A 队列 – 用法
大多数流行语言都提供内置的队列库,因此你无需重新造轮子。
如前所述,队列有两个重要的操作,入队 enqueue 和 出队 dequeue。此外,我们应该能够 获得队列中的第一个元素,因为应该首先处理它。
下面是使用内置队列库及其常见操作的一些示例:
 // "static void main" must be defined in a public class.
 public class Main {
     public static void main(String[] args) {
         // 1. Initialize a queue.
         Queue<Integer> q = new LinkedList();
         // 2. Get the first element - return null if queue is empty.
         System.out.println("The first element is: " + q.peek());
         // 3. Push new element.
         q.offer(5);
         q.offer(13);
         q.offer(8);
         q.offer(6);
         // 4. Pop an element.
         q.poll();
         // 5. Get the first element.
         System.out.println("The first element is: " + q.peek());
         // 7. Get the size of the queue.
         System.out.println("The size is: " + q.size());
     }
 }
LC 数据流中的移动平均值
给定一个整数数据流和一个窗口大小,根据该滑动窗口的大小,计算其所有整数的移动平均值。
实现 MovingAverage 类:
MovingAverage(int size)用窗口大小size初始化对象。double next(int val)计算并返回数据流中最后size个值的移动平均值。
示例:
输入:
["MovingAverage", "next", "next", "next", "next"]
[[3], [1], [10], [3], [5]]
输出:
[null, 1.0, 5.5, 4.66667, 6.0]
解释:
MovingAverage movingAverage = new MovingAverage(3);
movingAverage.next(1); // 返回 1.0 = 1 / 1
movingAverage.next(10); // 返回 5.5 = (1 + 10) / 2
movingAverage.next(3); // 返回 4.66667 = (1 + 10 + 3) / 3
movingAverage.next(5); // 返回 6.0 = (10 + 3 + 5) / 3提示:
1 <= size <= 1000- -105 <= val <= 105
- 最多调用
next方法 104 次
题解
该题即要求计算窗口内数字的平均值,窗口大小 size 不变,滑动窗口规则即为先进先出。
class MovingAverage {
Queue<Integer> queue;
int size;
double sum;
public MovingAverage(int size) {
queue = new ArrayDeque<Integer>();
this.size = size;
sum = 0;
}
public double next(int val) {
if (queue.size() == size) {
sum -= queue.poll();
}
queue.offer(val);
sum += val;
return sum / queue.size();
}
}复杂度分析
- 时间复杂度:初始化和每次调用 next 的时间复杂度都是 O(1)。
- 空间复杂度:O(size),其中 size 是滑动窗口的大小。空间复杂度主要取决于队列,队列中的数字个数不超过 size。
队列和广度优先搜索
先决条件:树的层序遍历
广度优先搜索(BFS)是一种 遍历或搜索 数据结构(如树或图)的算法。
如前所述,我们可以使用 BFS 在 树 中执行层序遍历。
我们也可以使用 BFS 遍历 图。例如,我们可以使用 BFS 找到从起始结点到目标结点的路径,特别是最短路径。
我们可以在更抽象的情景中使用 BFS 遍历 所有可能的状态。在这种情况下,我们可以把状态看作是图中的结点,而以合法的过渡路径作为图中的边。
本章中,我们将简要介绍 BFS 是如何工作的,并着重关注队列如何帮助我们实现 BFS 算法。
A 队列和 BFS
广度优先搜索(BFS)的一个常见应用是找出从根结点到目标结点的最短路径。在本文中,我们提供了一个示例来解释在 BFS 算法中是如何逐步应用队列的。
示例
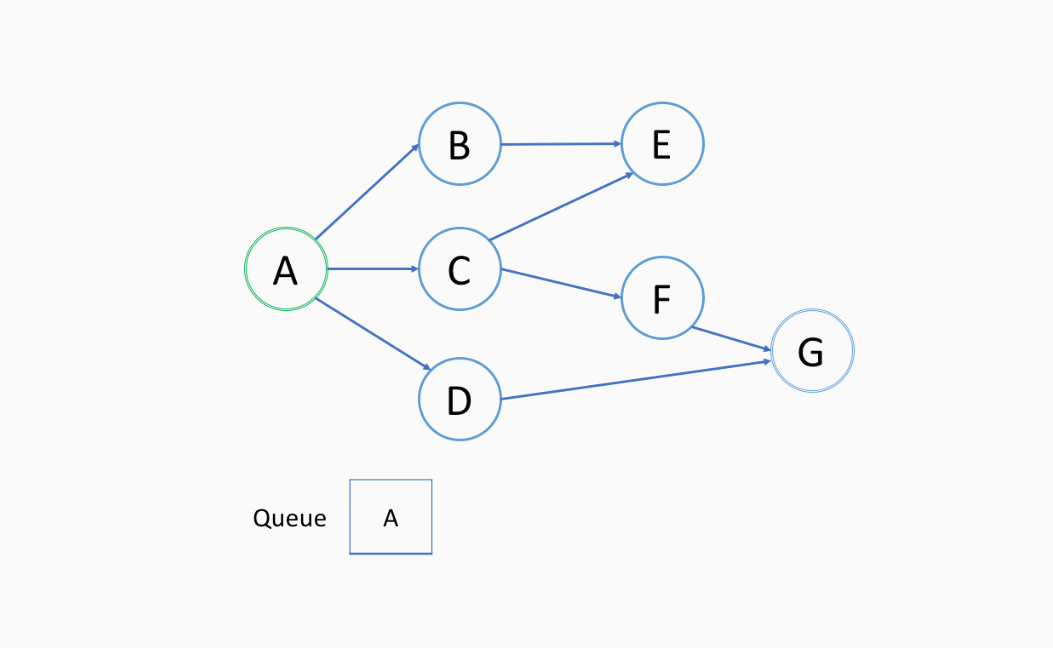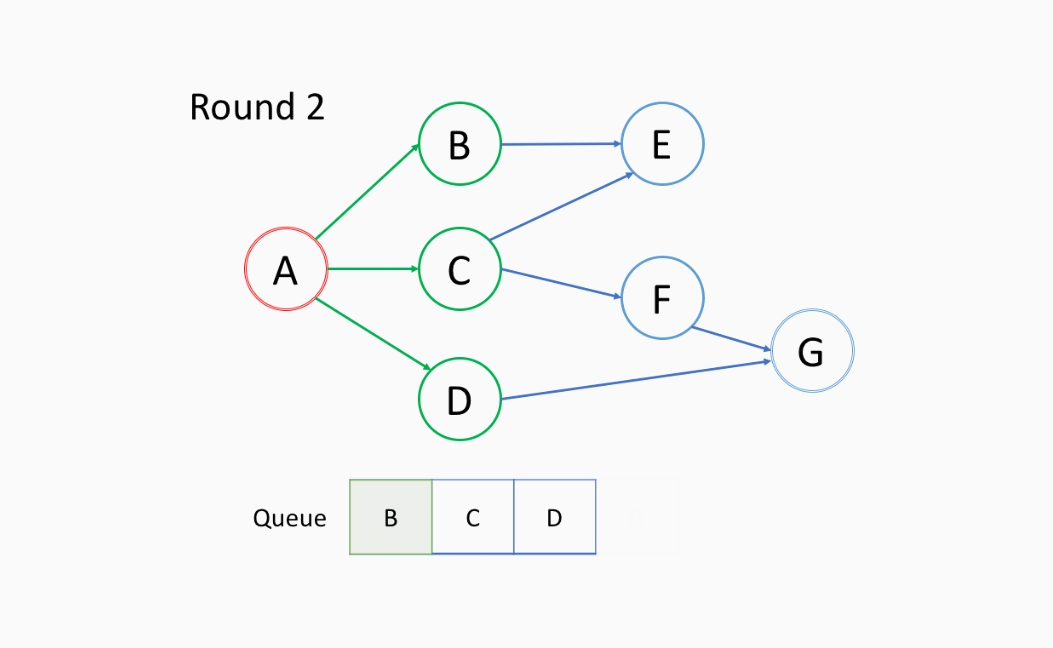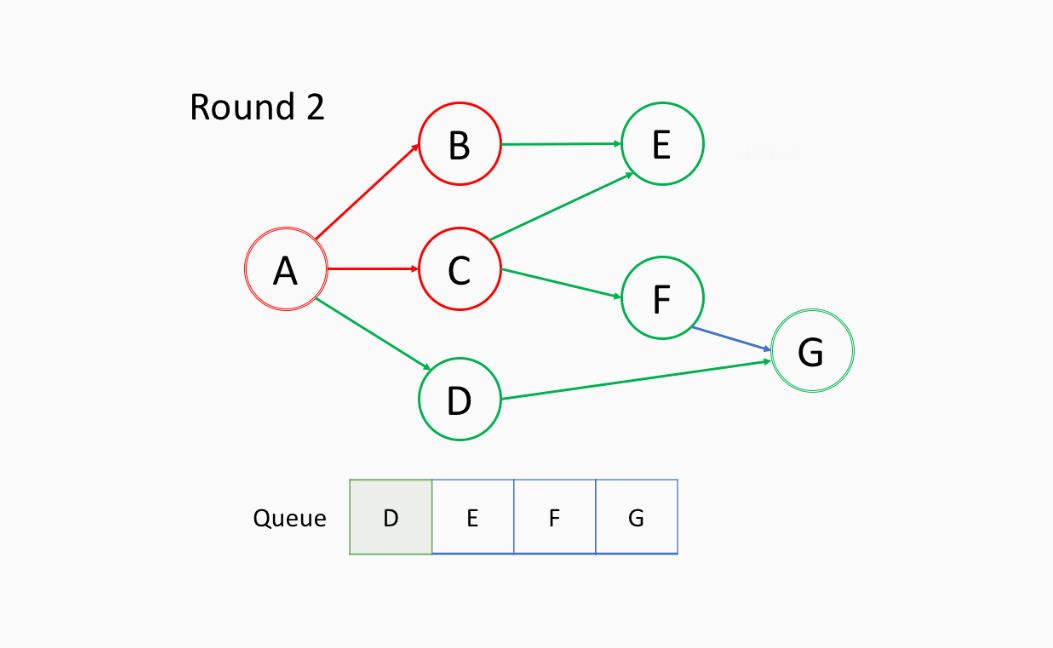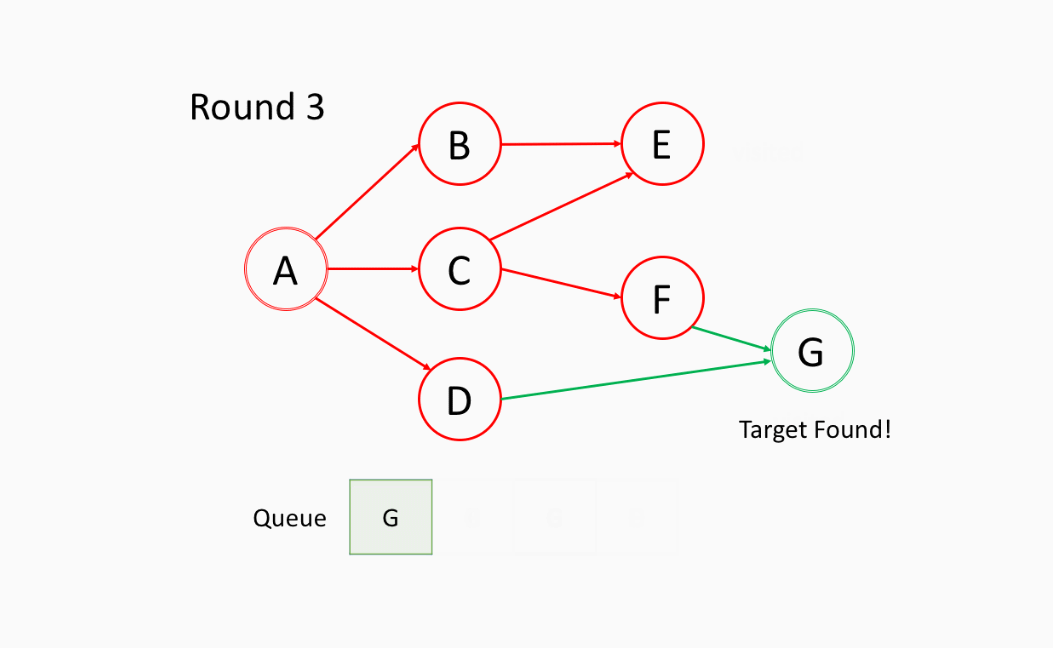
这里我们提供一个示例来说明如何使用 BFS 来找出根结点 A 和目标结点 G 之间的最短路径。
洞悉
观看上面的动画后,回答以下问题:
- 结点的处理顺序是什么?在第一轮中,我们处理根节点。在第二轮中,我们处理根节点旁边的结点;在第三轮中,我们处理距结点两步的结点;等等。与树的层序遍历类似,
越是接近根结点的结点将越早的遍历。如果在第 k 轮中将结点X添加到队列中,则根结点与X之间的最短路径的长度恰好是k。也就是说,第一次找到目标结点时,你已经处于最短路径中。 - 队列的入队和出队顺序是什么?如上面的动画所示,我们首先将根结点排入队列。然后在每一轮中,我们逐个处理已经在队列中的结点,并将所有邻居添加到队列中。值得注意的是,新添加的节点
不会立即遍历,而是在下一轮中处理。结点的处理顺序与它们添加到队列的顺序是完全相同的顺序,即先进先出(FIFO)。这就是我们在 BFS 中使用队列的原因。
A 广度优先搜索 – 模板
之前,我们已经介绍了使用 BFS 的两个主要方案:遍历 或 找出最短路径。通常,发生在树或图中。正如我们在章节描述中提到的,BFS 也可以用于更抽象的场景中。
在本文中,我们将为你提供一个模板。
在特定问题中执行 BFS 之前确定结点和边缘非常重要。通常,结点将是实际结点或是状态,而边缘将是实际边缘或可能的转换。
模板 Ⅰ
在这里,我们为你提供伪代码作为模板:
 /**
  * Return the length of the shortest path between root and target node.
  */
 int BFS(Node root, Node target) {
     Queue<Node> queue;  // store all nodes which are waiting to be processed
     int step = 0;       // number of steps neeeded from root to current node
     // initialize
     add root to queue;
     // BFS
     while (queue is not empty) {
         step = step + 1;
         // iterate the nodes which are already in the queue
         int size = queue.size();
         for (int i = 0; i < size; ++i) {
             Node cur = the first node in queue;
             return step if cur is target;
             for (Node next : the neighbors of cur) {
                 add next to queue;
             }
             remove the first node from queue;
         }
     }
     return -1;          // there is no path from root to target
}- 如代码所示,在每一轮中,队列中的结点是
等待处理的结点。 - 在每个更外一层的
while循环之后,我们距离根结点更远一步。变量step指示从根结点到我们正在访问的当前结点的距离。
模板 Ⅱ
有时,确保我们永远 不会访问一个结点两次 很重要,否则我们可能陷入无限循环。如果是这样,我们我们可以在上面的代码中添加一个哈希集来解决这个问题。这是修改后的伪代码:
/**
 * Return the length of the shortest path between root and target node.
 */
int BFS(Node root, Node target) {
    Queue<Node> queue;  // store all nodes which are waiting to be processed
    Set<Node> used;     // store all the used nodes
    int step = 0;       // number of steps neeeded from root to current node
    // initialize
    add root to queue;
    add root to used;
    // BFS
    while (queue is not empty) {
        step = step + 1;
        // iterate the nodes which are already in the queue
        int size = queue.size();
        for (int i = 0; i < size; ++i) {
            Node cur = the first node in queue;
            return step if cur is target;
            for (Node next : the neighbors of cur) {
                if (next is not in used) {
                    add next to queue;
                    add next to used;
                }
            }
            remove the first node from queue;
        }
    }
    return -1;          // there is no path from root to target
}
有两种情况你不需要使用哈希集:
- 你完全确定没有循环,例如,在树遍历中;
- 你确实希望多次将结点添加到队列中。
LC 墙与门*
你被给定一个 m × n 的二维网格 rooms,网格中有以下三种可能的初始化值:
-1表示墙或是障碍物0表示一扇门INF无限表示一个空的房间。然后,我们用231 - 1 = 2147483647代表INF。你可以认为通往门的距离总是小于2147483647的。
你要给每个空房间位上填上该房间到 最近门的距离 ,如果无法到达门,则填 INF 即可。
示例 1:
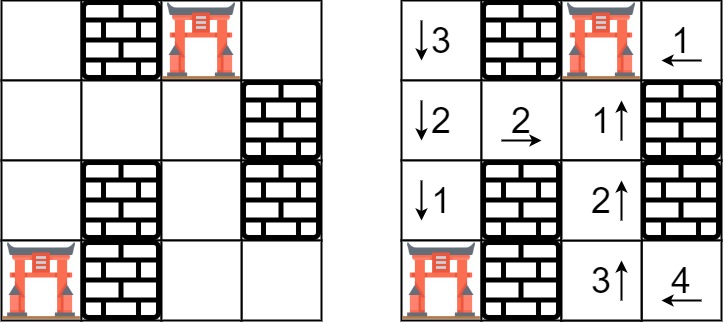
输入:rooms = [[2147483647,-1,0,2147483647],[2147483647,2147483647,2147483647,-1],[2147483647,-1,2147483647,-1],
[0,-1,2147483647,2147483647]]
输出:[[3,-1,0,1],[2,2,1,-1],[1,-1,2,-1],[0,-1,3,4]]
示例 2:
输入:rooms = [[-1]]
输出:[[-1]]
示例 3:
输入:rooms = [[2147483647]]
输出:[[2147483647]]
示例 4:
输入:rooms = [[0]]
输出:[[0]]提示:
m == rooms.lengthn == rooms[i].length1 <= m, n <= 250rooms[i][j]是-1、0或 231 – 1
题解
方法:宽度优先搜索
将所有门都找出来,使用队列,同时走一步,先到达的就是距离短的。
private static final int EMPTY = Integer.MAX_VALUE;
private static final int GATE = 0;
private static final List<int[]> DIRECTIONS = Arrays.asList(
        new int[] { 1,  0},
        new int[] {-1,  0},
        new int[] { 0,  1},
        new int[] { 0, -1}
);

public void wallsAndGates(int[][] rooms) {
    int m = rooms.length;
    if (m == 0) return;
    int n = rooms[0].length;
    Queue<int[]> q = new LinkedList<>();
    for (int row = 0; row < m; row++) {
        for (int col = 0; col < n; col++) {
            if (rooms[row][col] == GATE) {
                q.add(new int[] { row, col });
            }
        }
    }
    while (!q.isEmpty()) {
        int[] point = q.poll();
        int row = point[0];
        int col = point[1];
        for (int[] direction : DIRECTIONS) {
            int r = row + direction[0];
            int c = col + direction[1];
            if (r < 0 || c < 0 || r >= m || c >= n || rooms[r][c] != EMPTY) {
                continue;
            }
            rooms[r][c] = rooms[row][col] + 1;
            q.add(new int[] { r, c });
        }
    }
}
复杂度分析
- 时间复杂度:O(mn)。如果对直接得到时间复杂度有困难的话,可以从简单的情况开始。我们首先考虑只有一个门的情况,宽度优先搜索最多只需要 m × n 步就能到达所有房间,所以时间复杂度是 O(mn)。但是从 k 个门开始呢?一旦我们到达了一个房间,并记录下它的距离时,这意味着我们也标记了这个房间已经被访问过了,这意味着每个房间最多会被访问一次。因此,时间复杂度与门的数量无关,所以时间复杂度为 O(mn)。
- 空间复杂度:O(mn)。空间复杂度与队列的大小有关。我们最多将 m × n 个位置插入队列,所以空间最大为 m × n。
LC 岛屿数量
给你一个由 ‘1’(陆地)和 ‘0’(水)组成的二维网格,请你计算网格中岛屿的数量。
岛屿总是被水包围,并且每座岛屿只能由水平方向和 / 或竖直方向上相邻的陆地连接形成。
此外,你可以假设该网格的四条边均被水包围。
示例 1:
输入:grid = [
  ["1","1","1","1","0"],
  ["1","1","0","1","0"],
  ["1","1","0","0","0"],
  ["0","0","0","0","0"]
]
输出:1
示例 2:
输入:grid = [
  ["1","1","0","0","0"],
  ["1","1","0","0","0"],
  ["0","0","1","0","0"],
  ["0","0","0","1","1"]
]
输出:3提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 300grid[i][j]的值为'0'或'1'
题解
方法一:深度优先搜索
我们可以将二维网格看成一个无向图,竖直或水平相邻的 1 之间有边相连。
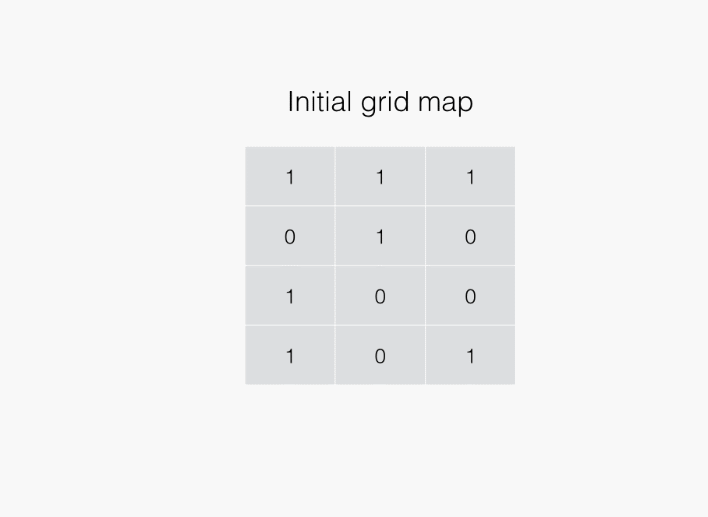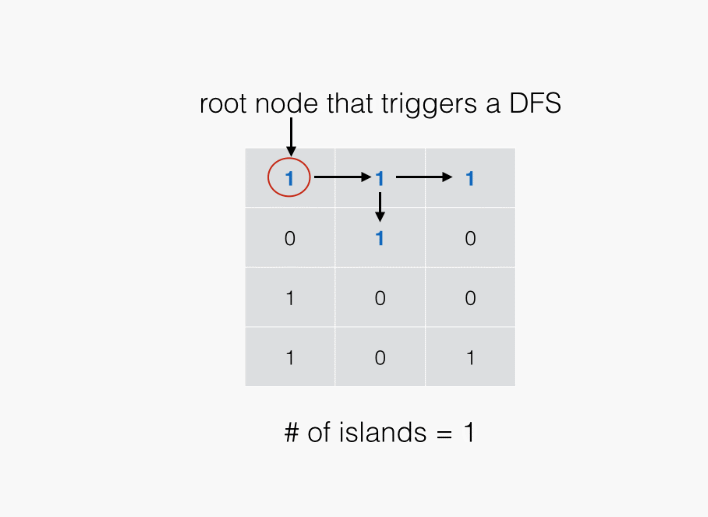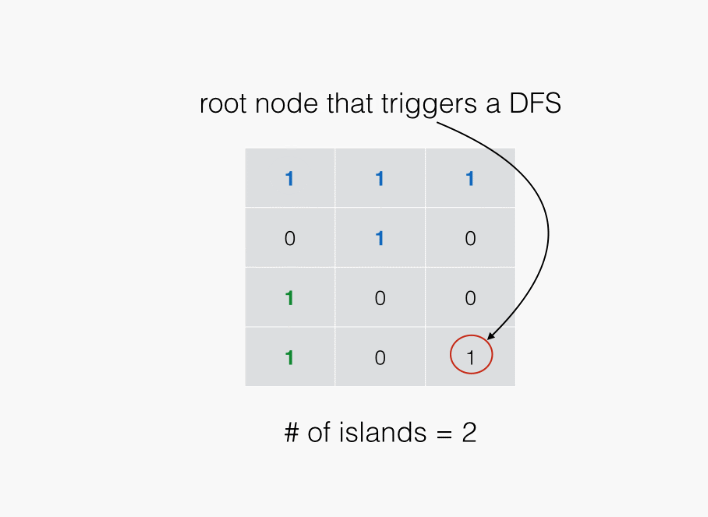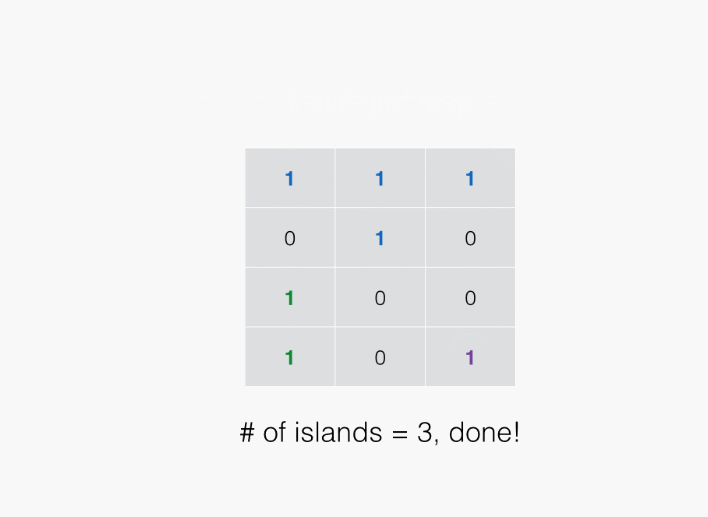
为了求出岛屿的数量,我们可以扫描整个二维网格。如果一个位置为 1,则以其为起始节点开始进行深度优先搜索。在深度优先搜索的过程中,每个搜索到的 1 都会被重新标记为 0。
最终岛屿的数量就是我们进行深度优先搜索的次数。
class Solution {
    /**
    * grid 二维数组,可能是修改过的
    * r row 数组的行
    * c column 数组的列
    */
    void dfs(char[][] grid, int r, int c) {
        int nr = grid.length;
        int nc = grid[0].length;

        if (r < 0 || c < 0 || r >= nr || c >= nc || grid[r][c] == '0') {
            return;
        }

        // 将探索到的岛屿改为 '0' 避免造成重复
        grid[r][c] = '0';
        // 递归,向左侧递去,到边界后归来,以下操作类似(深度优先)
        dfs(grid, r - 1, c);
        dfs(grid, r + 1, c);
        dfs(grid, r, c - 1);
        dfs(grid, r, c + 1);
    }

    public int numIslands(char[][] grid) {
        if (grid == null || grid.length == 0) {
            return 0;
        }

        int nr = grid.length;
        int nc = grid[0].length;
        int num_islands = 0;
        for (int r = 0; r < nr; ++r) {
            for (int c = 0; c < nc; ++c) {
                if (grid[r][c] == '1') {
                    ++num_islands;
                    dfs(grid, r, c);
                }
            }
        }

        return num_islands;
    }
}
复杂度分析
- 时间复杂度:O(MN),其中 M 和 N 分别为行数和列数。
- 空间复杂度:O(MN),在最坏的情况下,整个网格均为陆地,深度优先搜索的深度达到 MN。
方法二:广度优先搜索
同样的,我们也可以使用广度优先搜索代替深度优先搜索。
为了求出岛屿的数量,我们可以扫描整个二维网格。如果一个位置为 1,则将其加入队列,开始进行广度优先搜索。在广度优先搜索的过程中,每个搜索到的 1 都会被重新标记为 0。直到队列为空,搜索结束。
最终岛屿的数量就是我们进行广度优先搜索的次数。
class Solution {
    public int numIslands(char[][] grid) {
        if (grid == null || grid.length == 0) {
            return 0;
        }

        int nr = grid.length;
        int nc = grid[0].length;
        int num_islands = 0;

        for (int r = 0; r < nr; ++r) {
            for (int c = 0; c < nc; ++c) {
                if (grid[r][c] == '1') {
                    ++num_islands;
                    grid[r][c] = '0';
                    Queue<Integer> neighbors = new LinkedList<>();
                    neighbors.add(r * nc + c); // 入队
                    while (!neighbors.isEmpty()) {
                        int id = neighbors.remove(); // 出队并赋值
                        int row = id / nc; // 计算对应行数
                        int col = id % nc; // 计算对应列数
                        if (row - 1 >= 0 && grid[row-1][col] == '1') {
                            neighbors.add((row-1) * nc + col);
                            grid[row-1][col] = '0';
                        }
                        if (row + 1 < nr && grid[row+1][col] == '1') {
                            neighbors.add((row+1) * nc + col);
                            grid[row+1][col] = '0';
                        }
                        if (col - 1 >= 0 && grid[row][col-1] == '1') {
                            neighbors.add(row * nc + col-1);
                            grid[row][col-1] = '0';
                        }
                        if (col + 1 < nc && grid[row][col+1] == '1') {
                            neighbors.add(row * nc + col+1);
                            grid[row][col+1] = '0';
                        }
                    }
                }
            }
        }

        return num_islands;
    }
}
复杂度分析
- 时间复杂度:O(MN),其中 M 和 N 分别为行数和列数。
- 空间复杂度:O(min(M, N)),在最坏情况下,整个网格均为陆地,队列的大小可以达到 min(M, N)。
LC 打开转盘锁
你有一个带有四个圆形拨轮的转盘锁。每个拨轮都有10个数字:'0', '1', '2', '3', '4', '5', '6', '7', '8', '9' 。每个拨轮可以自由旋转:例如把 '9' 变为 '0','0' 变为 '9' 。每次旋转都只能旋转一个拨轮的一位数字。
锁的初始数字为 '0000' ,一个代表四个拨轮的数字的字符串。
列表 deadends 包含了一组死亡数字,一旦拨轮的数字和列表里的任何一个元素相同,这个锁将会被永久锁定,无法再被旋转。
字符串 target 代表可以解锁的数字,你需要给出解锁需要的最小旋转次数,如果无论如何不能解锁,返回 -1 。
示例 1:
输入:deadends = ["0201","0101","0102","1212","2002"], target = "0202"
输出:6
解释:
可能的移动序列为 "0000" -> "1000" -> "1100" -> "1200" -> "1201" -> "1202" -> "0202"。
注意 "0000" -> "0001" -> "0002" -> "0102" -> "0202" 这样的序列是不能解锁的,
因为当拨动到 "0102" 时这个锁就会被锁定。
示例 2:
输入: deadends = ["8888"], target = "0009"
输出:1
解释:把最后一位反向旋转一次即可 "0000" -> "0009"。
示例 3:
输入: deadends = ["8887","8889","8878","8898","8788","8988","7888","9888"], target = "8888"
输出:-1
解释:无法旋转到目标数字且不被锁定。提示:
1 <= deadends.length <= 500deadends[i].length == 4target.length == 4target不在deadends之中target和deadends[i]仅由若干位数字组成
题解
方法一:广度优先搜索
查看思路
我们可以使用广度优先搜索,找出从初始数字 0000 到解锁数字 target 的最小旋转次数。
具体地,我们在一开始将 (0000,0) 加入队列,并使用该队列进行广度优先搜索。在搜索的过程中,设当前搜索到的数字为 status,旋转的次数为 step,我们可以枚举 status 通过一次旋转得到的数字。设其中的某个数字为 next_status,如果其没有被搜索过,我们就将 (next_status,step+1) 加入队列。如果搜索到了 target,我们就返回其对应的旋转次数。
为了避免搜索到死亡数字,我们可以使用哈希表存储 deadends 中的所有元素,这样在搜索的过程中,我们可以均摊 O(1) 地判断一个数字是否为死亡数字。同时,我们还需要一个哈希表存储所有搜索到的状态,避免重复搜索。
如果搜索完成后,我们仍没有搜索到 target,说明我们无法解锁,返回 −1。
注意:
1. 如果 target 就是初始数字 “0000”,则直接返回答案 0;
2. 如果初始数字 “0000” 出现在 deadends 中,则直接返回答案 -1。
class Solution {
    public int openLock(String[] deadends, String target) {
        // 若 "0000" 等于目标,返回 0
        if ("0000".equals(target)) {
            return 0;
        }
        // 利用哈希存储死亡数组
        Set<String> dead = new HashSet<String>();
        for (String deadend : deadends) {
            dead.add(deadend);
        }
        // 若死亡数组内含有 "0000" 则返回 -1
        if (dead.contains("0000")) {
            return -1;
        }
        // 旋转次数
        int step = 0;
        // 创建队列存储所有已搜索且不包含死亡数字的数字
        Queue<String> queue = new LinkedList<String>();
        queue.offer("0000");
        // 用哈希存储已搜索数字,避免重复
        Set<String> seen = new HashSet<String>();
        seen.add("0000");

        while (!queue.isEmpty()) {
            ++step;
            // 更新队列大小
            int size = queue.size();
            for (int i = 0; i < size; ++i) {
                String status = queue.poll();
                // 循环所有能通过一次旋转得到的数字
                for (String nextStatus : get(status)) {
                    if (!seen.contains(nextStatus) && !dead.contains(nextStatus)) {
                        if (nextStatus.equals(target)) {
                            return step;
                        }
                        queue.offer(nextStatus);
                        seen.add(nextStatus);
                    }
                }
            }
        }
        return -1;
    }
    //前一个数字
    public char numPrev(char x) {
        return x == '0' ? '9' : (char) (x - 1);
    }
    // 下一个数字
    public char numSucc(char x) {
        return x == '9' ? '0' : (char) (x + 1);
    }

    // 枚举 status 通过一次旋转得到的数字
    public List<String> get(String status) {
        // 存储所有可以通过一次旋转得到的数字
        List<String> ret = new ArrayList<String>();
        // 将字符串转换为字符数组
        char[] array = status.toCharArray();
        // 按左到右顺序枚举
        for (int i = 0; i < 4; ++i) {
            char num = array[i];
            array[i] = numPrev(num);
            ret.add(new String(array));
            array[i] = numSucc(num);
            ret.add(new String(array));
            // 恢复旋转前数字
            array[i] = num;
        }
        return ret;
    }
}
Java toCharArray() 方法:toCharArray() 方法将字符串转换为字符数组。
Java String contains() 方法:contains() 方法用于判断字符串中是否包含指定的字符或字符串。
Java equals() 方法:equals() 方法用于判断 Number 对象与方法的参数进是否相等。
复杂度分析
- 时间复杂度:O(bd ⋅ d2 + md),其中 b 是数字的进制,d 是转盘数字的位数,m 是数组 deadends 的长度,在本题中 b = 10,d = 4。
- 转盘数字的可能性一共有 bd 种,这也是我们可以搜索到的状态数上限。对于每一个转盘数字,我们需要 O(d) 的时间枚举旋转的数位,同时需要 O(d) 的时间生成旋转后的数字(即加入队列),因此广度优先搜索的总时间复杂度为 O(bd ⋅ d2 + md)。
- 此外,在搜索前我们需要将 deadends 中的所有元素放入哈希表中,计算一个字符串哈希值需要的时间为 O(d),因此需要的总时间为 O(md)。
- 空间复杂度:O(bd ⋅ d + m)。
- 我们最多需要在队列中存储 O(bd) 个长度为 d 的字符串,空间复杂度为 O(bd ⋅ d);
- 哈希表需要 O(m) 的空间。如果使用的语言存储的是元素的拷贝,那么需要的空间为 O(md)。
LC 完全平方数
给你一个整数 n,返回和为 n 的完全平方数的最少数量。
完全平方数 是一个整数,其值等于另一个整数的平方;换句话说,其值等于一个整数自乘的积。例如,1、4、9 和 16 都是完全平方数,而 3 和 11 不是。
示例 1:
输入:n = 12
输出:3
解释:12 = 4 + 4 + 4
示例 2:
输入:n = 13
输出:2
解释:13 = 4 + 9提示:
- 1 <= n <= 104
题解
方法一:动态规划
查看解题思路
我们可以依据题目的要求写出状态表达式:f[i] 表示最少需要多少个数的平方来表示整数 i。
这些数必然落在区间 [1, sqrt(n)]。我们可以枚举这些数,假设当前枚举到 j,那么我们还需要取若干数的平方,构成 i – j²。此时我们发现该子问题和原问题类似,只是规模变小了。这符合了动态规划的要求,于是我们可以写出 状态转移方程
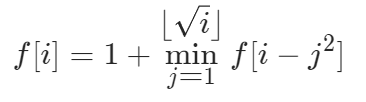
其中 f[0] = 0 为边界条件,实际上我们无法表示数字 0,只是为了保证状态转移过程中遇到 j 恰为 sqrt(i) 的情况合法。
同时因为计算 f[i] 时所需要用到的状态仅有 f[i – j²],必然小于 i,因此我们只需要从小到大的枚举 i 来计算 f[i] 即可。
- 首先初始化长度为 n+1 的数组 dp,每个位置都为 0
- 如果 n 为 0,则结果为 0
- 对数组进行遍历,下标为 i,每次都将当前数字先更新为最大的结果,即dp[i] = i,比如 i=4,最坏的结果为 4=1+1+1+1 即为 4 个数字
- 动态转移方程为:dp[i] = MIN(dp[i], dp[i – j²] + 1),i 表示当前数字,j² 表示平方数
class Solution {
    public int numSquares(int n) {
        int[] dp = new int[n + 1]; // 默认初始化值都为0
        for (int i = 1; i <= n; i++) {
            dp[i] = i; // 最坏的情况就是每次+1
            for (int j = 1; i - j * j >= 0; j++) {
                dp[i] = Math.min(dp[i], dp[i - j * j] + 1); // 动态转移方程
            }
        }
        return dp[n];
    }
}
复杂度分析
- 时间复杂度:O(n * sqrt(n)),其中 n 为给定的正整数。状态转移方程的时间复杂度为 O(sqrt(n)),共需要计算 n 个状态,因此总时间复杂度为 O(n * sqrt(n))。
- 空间复杂度:O(n)。我们需要 O(n) 的空间保存状态。
方法二:数学
查看解题思路
一个数学定理可以帮助解决本题:「四平方和定理」。
四平方和定理证明了任意一个正整数都可以被表示为至多四个正整数的平方和。这给出了本题的答案的上界。
同时四平方和定理包含了一个更强的结论:当且仅当 n ≠ 4^k × (8m + 7) 时,n 可以被表示为至多三个正整数的平方和。因此,当 n = 4^k × (8m + 7) 时,n 只能被表示为四个正整数的平方和。此时我们可以直接返回 4。
当 n ≠ 4^k × (8m + 7) 时,我们需要判断到底多少个完全平方和能够表示 n,我们知道答案只会是 1, 2, 3 中的一个:
- 答案为 1 时,则必有 n 为完全平方数;
- 答案为 2 时,则有 n = a² + b²,我们只需要枚举所有的 a(1 ≤ a ≤ sqrt(n)),判断 n – a² 是否为完全平方数即可;
- 答案为 3 时,我们很难在一个优秀的时间复杂度内解决它,但我们只需要检查答案为 1 或 2 的两种情况,即可利用排除法确定答案。
class Solution {
    public int numSquares(int n) {
        if (isPerfectSquare(n)) {
            return 1;
        }
        if (checkAnswer4(n)) {
            return 4;
        }
        for (int i = 1; i * i <= n; i++) {
            int j = n - i * i;
            if (isPerfectSquare(j)) {
                return 2;
            }
        }
        return 3;
    }

    // 判断是否为完全平方数
    public boolean isPerfectSquare(int x) {
        int y = (int) Math.sqrt(x);
        return y * y == x;
    }

    // 判断是否能表示为 4^k*(8m+7)
    public boolean checkAnswer4(int x) {
        while (x % 4 == 0) {
            x /= 4;
        }
        return x % 8 == 7;
    }
}
复杂度分析
- 时间复杂度:O(sqrt(n)),其中 n 为给定的正整数。最坏情况下答案为 3,我们需要运行所有的判断,而判断答案是否为 1 的时间复杂度为 O(1),判断答案是否为 4 的时间复杂度为 O(logn),剩余判断为 O(sqrt(n)),因此总时间复杂度为 O(logn + sqrt(n)) = O(sqrt(n)) = O(sqrt(n))。
- 空间复杂度:O(1)。我们只需要常数的空间保存若干变量。
栈:后入先出的数据结构
本章中,我们将介绍另一种处理顺序 后入先出(LIFO),以及相应的数据结构,栈。
完成本章后,你将:
- 理解 LIFO 和栈的
定义; - 能够用动态数组
实现栈; - 熟悉
内置栈结构; - 能够使用栈解决问题。
A 后入先出的数据结构
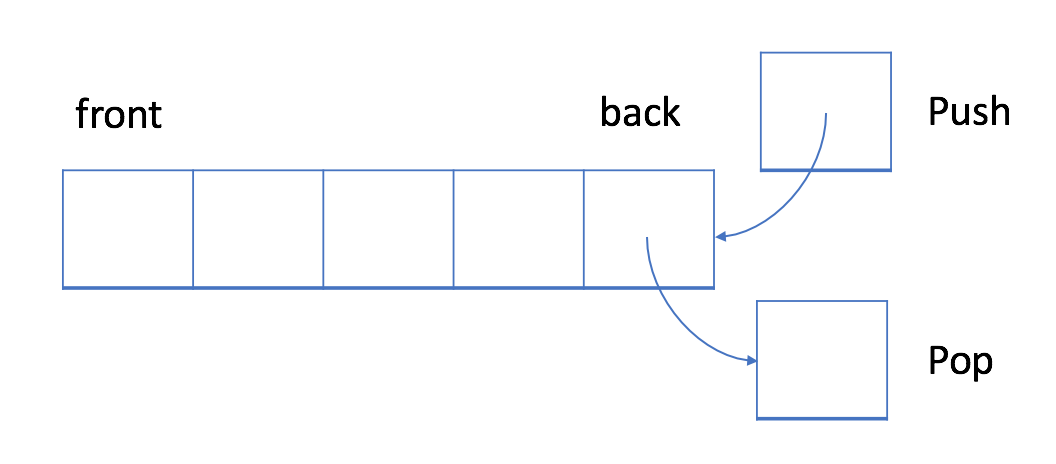
在 LIFO 数据结构中,将 首先处理添加到队列 中的 最新元素。
与队列不同,栈是一个 LIFO 数据结构。通常,插入操作在栈中被称作入栈 push。与队列类似,总是 在堆栈的末尾添加一个新元素。但是,删除操作,退栈 pop ,将始终删除队列中相对于它的最后一个元素。
示例 – 栈
入栈与出栈
实现 – 栈
栈的实现比队列容易。动态数组足以实现堆栈结构。这里我们提供了一个简单的实现供你参考:
// "static void main" must be defined in a public class.
class MyStack {
    private List<Integer> data;               // store elements
    public MyStack() {
        data = new ArrayList<>();
    }
    /** Insert an element into the stack. */
    public void push(int x) {
        data.add(x);
    }
    /** Checks whether the queue is empty or not. */
    public boolean isEmpty() {
        return data.isEmpty();
    }
    /** Get the top item from the queue. */
    public int top() {
        return data.get(data.size() - 1);
    }
    /** Delete an element from the queue. Return true if the operation is successful. */
    public boolean pop() {
        if (isEmpty()) {
            return false;
        }
        data.remove(data.size() - 1);
        return true;
    }
};

public class Main {
    public static void main(String[] args) {
        MyStack s = new MyStack();
        s.push(1);
        s.push(2);
        s.push(3);
        for (int i = 0; i < 4; ++i) {
            if (!s.isEmpty()) {
                System.out.println(s.top());
            }
            System.out.println(s.pop());
        }
    }
}
A 栈 – 用法
大多数流行的语言都提供了内置的栈库,因此你不必重新发明轮子。除了初始化,我们还需要知道如何使用两个最重要的操作:入栈和退栈。除此之外,你应该能够从栈中获得顶部元素。下面是一些供你参考的代码示例:
// "static void main" must be defined in a public class.
public class Main {
    public static void main(String[] args) {
        // 1. Initialize a stack.
        Stack<Integer> s = new Stack<>();
        // 2. Push new element.
        s.push(5);
        s.push(13);
        s.push(8);
        s.push(6);
        // 3. Check if stack is empty.
        if (s.empty() == true) {
            System.out.println("Stack is empty!");
            return;
        }
        // 4. Pop an element.
        s.pop();
        // 5. Get the top element.
        System.out.println("The top element is: " + s.peek());
        // 6. Get the size of the stack.
        System.out.println("The size is: " + s.size());
    }
}
LC 最小栈
设计一个支持 push,pop ,top 操作,并能在常数时间内检索到最小元素的栈。
实现 MinStack 类:
MinStack()初始化堆栈对象。void push(int val)将元素val推入堆栈。void pop()删除堆栈顶部的元素。int top()获取堆栈顶部的元素。int getMin()获取堆栈中的最小元素。
示例 1:
["MinStack","push","push","push","getMin","pop","top","getMin"]
[[],[-2],[0],[-3],[],[],[],[]]

输出:
[null,null,null,null,-3,null,0,-2]
解释: MinStack minStack = new MinStack(); minStack.push(-2); minStack.push(0); minStack.push(-3); minStack.getMin(); –> 返回 -3. minStack.pop(); minStack.top(); –> 返回 0. minStack.getMin(); –> 返回 -2.
提示
- -231 <= val <= 231 – 1
pop、top和getMin操作总是在 非空栈 上调用push,pop,top, andgetMin最多被调用 3 * 104 次
题解
方法一:辅助栈
查看思路
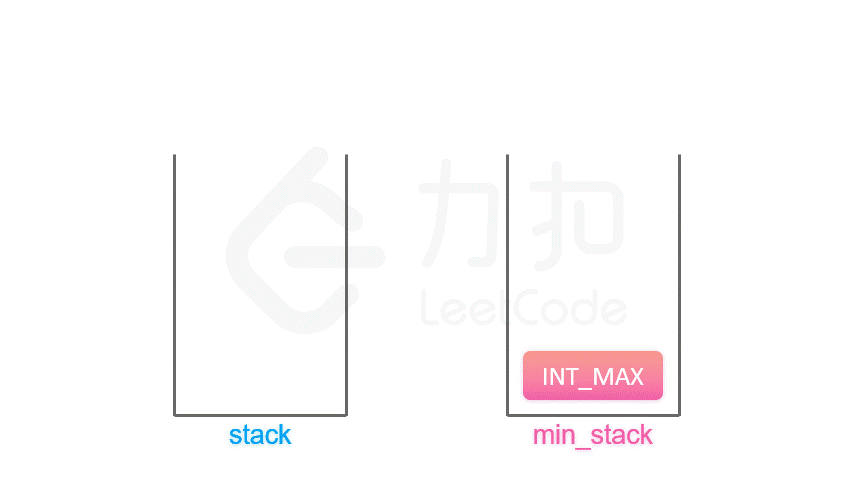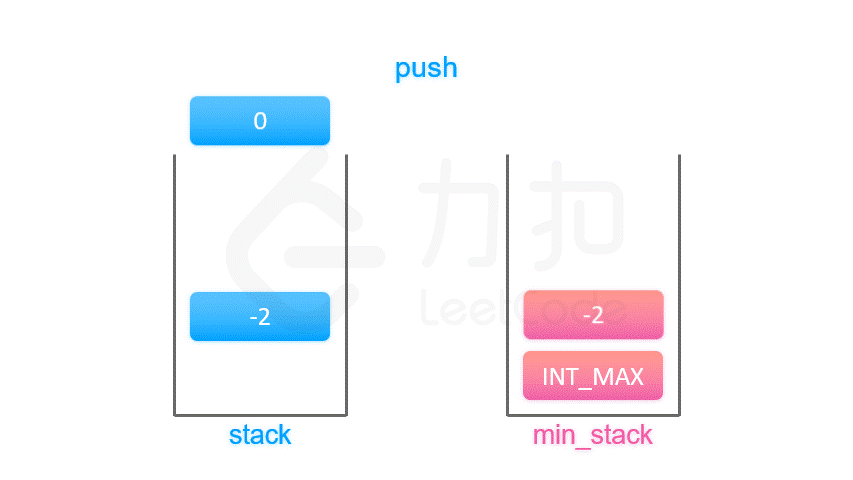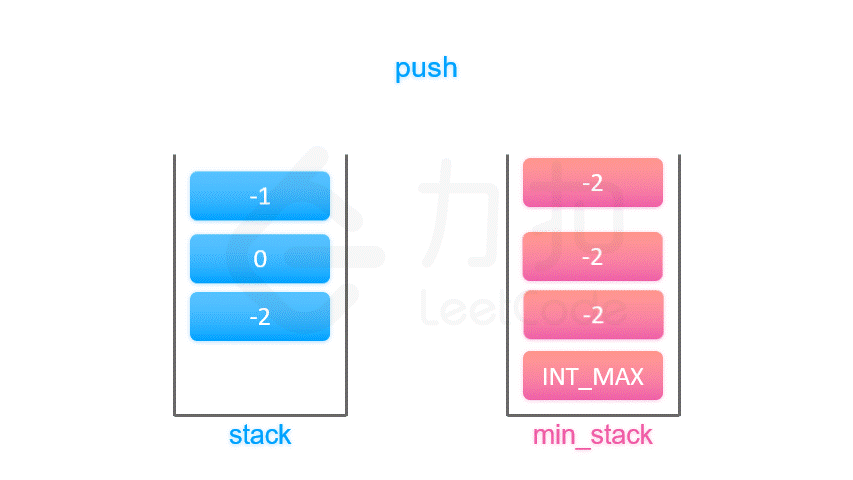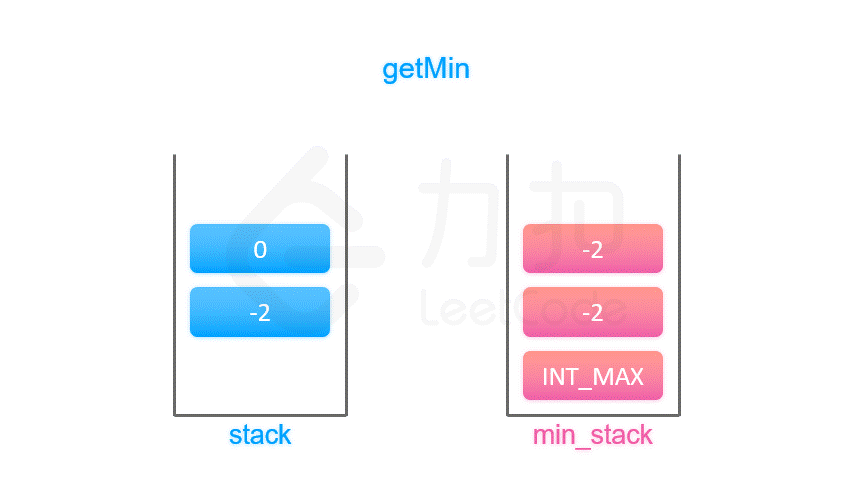
我们可以在每个元素 a 入栈时,将当前栈的最小值 m 存储起来,在这之后,若栈顶元素是 a,我们就可以直接返回存储的最小值 m。
按上面的思路,我们只需要设计一个辅助栈,与元素栈同步插入与删除,使得每个元素 a 与其相应的最小值 m 时刻保持一一对应。
- 当一个元素要入栈时,我们取当前辅助栈的栈顶存储的最小值,与当前元素比较得出最小值,将这个最小值插入辅助栈中;
- 当一个元素要出栈时,我们把辅助栈的栈顶元素也一并弹出;
- 在任意一个时刻,栈内元素的最小值就存储在辅助栈的栈顶元素中。
class MinStack {
    Deque<Integer> xStack;
    Deque<Integer> minStack;

    public MinStack() {
        xStack = new LinkedList<Integer>();
        minStack = new LinkedList<Integer>();
        minStack.push(Integer.MAX_VALUE);
    }

    public void push(int val) {
        xStack.push(val);
        minStack.push(Math.min(val, minStack.peek()));
    }

    public void pop() {
        xStack.pop();
        minStack.pop();
    }

    public int top() {
        return xStack.peek();
    }

    public int getMin() {
        return minStack.peek();
    }
}复杂度分析
- 时间复杂度:对于题目中的所有操作,时间复杂度均为 O(1)。因为栈的插入、删除与读取操作都是 O(1),我们定义的每个操作最多调用栈操作两次。
- 空间复杂度:O(n),其中 n 为总操作数。最坏的情况下,我们会连续插入 n 个元素,此时两个栈占用的空间为 O(n)。
LC 有效的括号
给定一个只包括 '(',')','{','}','[',']' 的字符串 s ,判断字符串是否有效。
有效字符串需满足:
- 左括号必须用相同类型的右括号闭合。
- 左括号必须以正确的顺序闭合。
- 每个右括号都有一个对应的相同类型的左括号。
示例 1:
输入:s = "()"
输出:true
示例 2:
输入:s = "()[]{}"
输出:true
示例 3:
输入:s = "(]"
输出:false提示:
- 1 <= s.length <= 104
s仅由括号'()[]{}'组成
题解
class Solution {
    public boolean isValid(String s) {
        // 检查是否为偶数
        int n = s.length();
        if (n % 2 == 1) {
            return false;
        }
        // 用哈希键值对记录
        Map<Character, Character> pairs = new HashMap<Character, Character>() {{
            put(')', '(');
            put(']', '[');
            put('}', '{');
        }};
        Deque<Character> stack = new LinkedList<Character>();
        for (int i = 0; i < n; i++) {
            // 获取对应位置字符
            char ch = s.charAt(i);
            // 若哈希表中有对应键
            if (pairs.containsKey(ch)) {
                // 检查栈顶是否对应
                if (stack.isEmpty() || stack.peek() != pairs.get(ch)) {
                    return false;
                }
                stack.pop();
            } else {
                stack.push(ch);
            }
        }
        return stack.isEmpty();
    }
}复杂度分析
- 时间复杂度:O(n),其中 n 是字符串 s 的长度。
- 空间复杂度:O(n + ∣Σ∣),其中 Σ 表示字符集,本题中字符串只包含 6 种括号,∣Σ∣=6。栈中的字符数量为 O(n),而哈希表使用的空间为 O(∣Σ∣),相加即可得到总空间复杂度。
LC 每日温度
给定一个整数数组 temperatures,表示每天的温度,返回一个数组 answer,其中 answer[i] 是指对于第 [i] 天,下一个更高温度出现在几天后。如果气温在这之后都不会升高,请在该位置用 0 来代替。
示例 1:
输入: temperatures = [73,74,75,71,69,72,76,73]
输出: [1,1,4,2,1,1,0,0]
示例 2:
输入: temperatures = [30,40,50,60]
输出: [1,1,1,0]
示例 3:
输入: temperatures = [30,60,90]
输出: [1,1,0]提示:
- 1 <= temperatures.length <= 105
30 <= temperatures[i] <= 100
题解
方法二:单调栈
查看解题思路
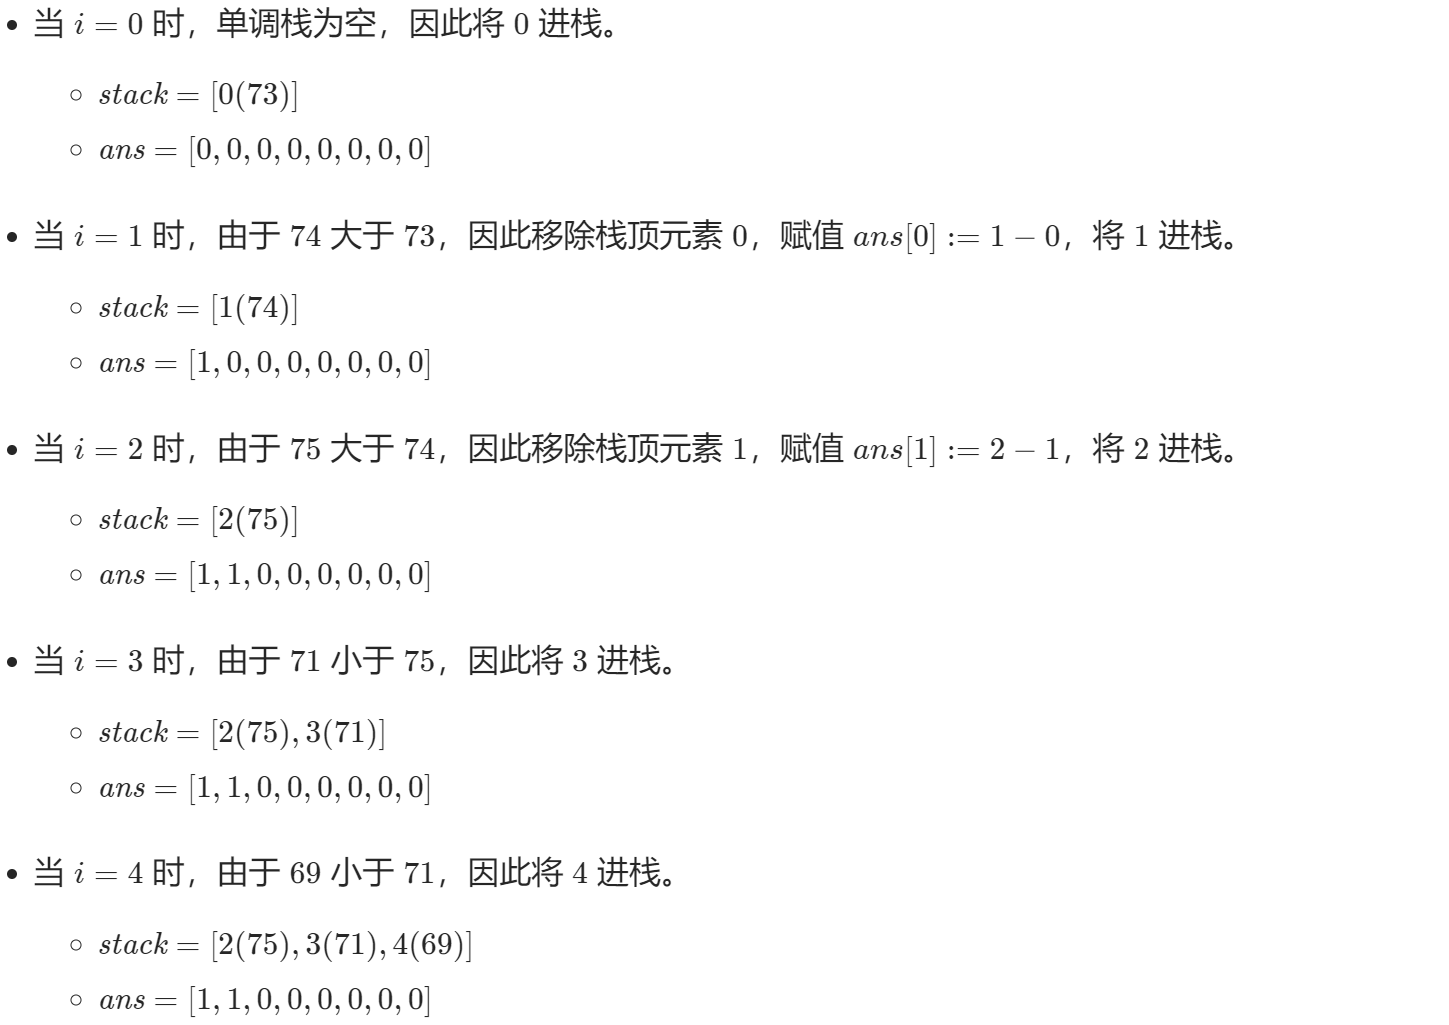
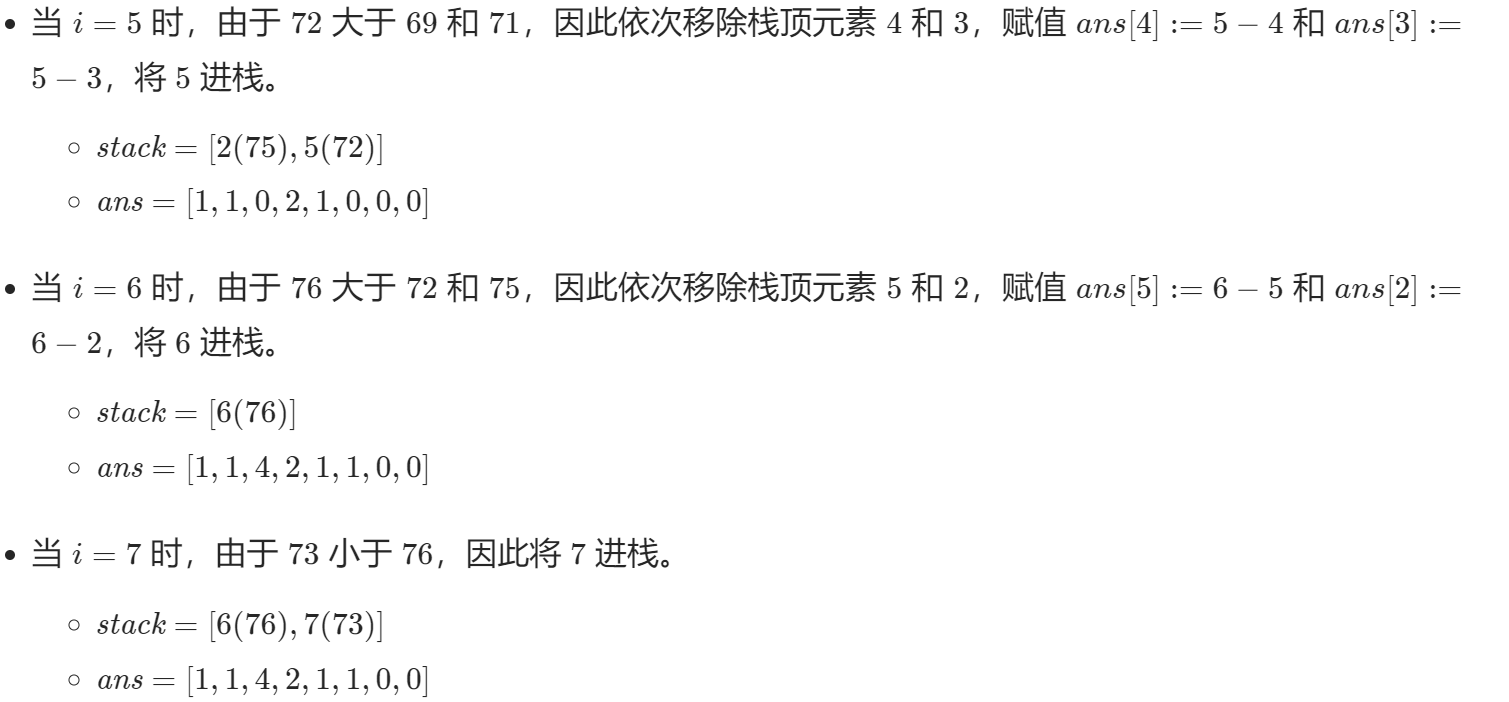
解决这个问题的思路总结起来就是用一个栈保存每天的温度在数组中的下标。每次从数组中读取一个温度,然后将其与栈中保存的温度比较。如果当前的温度比栈顶的温度高,那么就能知道位于栈顶的那一天需要等待几天才会出现更高的温度(通过 i – 栈顶下标得出)。然后出栈 1 次,将当前温度再次与下一个位于栈顶的温度进行比较。如果栈中没有更高的温度,则将当前温度在数组中的下标入栈。
以下用一个例子来帮助理解:温度列表 [73,74,75,71,69,72,76,73],单调栈 stack 的初始状态为空,答案 ans 的初始状态是 [0,0,0,0,0,0,0,0],按照以下步骤更新单调栈和答案,其中单调栈内的元素都是下标,括号内的数字表示下标在温度列表中对应的温度。
class Solution {
    public int[] dailyTemperatures(int[] temperatures) {
        int[] result = new int[temperatures.length];
        Stack<Integer> stack = new Stack<>();
        for (int i = 0; i < temperatures.length; i++) {
            while (!stack.empty() && temperatures[i] > temperatures[stack.peek()]) {
                int prev = stack.pop();
                result[prev] = i - prev;
            }
            stack.push(i);
        }
        return result;
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 是温度列表的长度。正向遍历温度列表一遍,对于温度列表中的每个下标,最多有一次进栈和出栈的操作。
- 空间复杂度:O(n),其中 n 是温度列表的长度。需要维护一个单调栈存储温度列表中的下标。
LC 逆波兰表达式求值
根据 逆波兰表示法,求表达式的值。
有效的算符包括 +、-、*、/ 。每个运算对象可以是整数,也可以是另一个逆波兰表达式。
注意 两个整数之间的除法只保留整数部分。
可以保证给定的逆波兰表达式总是有效的。换句话说,表达式总会得出有效数值且不存在除数为 0 的情况。
示例 1:
输入:tokens = ["2","1","+","3","*"]
输出:9
解释:该算式转化为常见的中缀算术表达式为:((2 + 1) * 3) = 9
示例 2:
输入:tokens = ["4","13","5","/","+"]
输出:6
解释:该算式转化为常见的中缀算术表达式为:(4 + (13 / 5)) = 6
示例 3:
输入:tokens = ["10","6","9","3","+","-11","*","/","*","17","+","5","+"]
输出:22
解释:该算式转化为常见的中缀算术表达式为:
  ((10 * (6 / ((9 + 3) * -11))) + 17) + 5
= ((10 * (6 / (12 * -11))) + 17) + 5
= ((10 * (6 / -132)) + 17) + 5
= ((10 * 0) + 17) + 5
= (0 + 17) + 5
= 17 + 5
= 22提示:
- 1 <= tokens.length <= 104
tokens[i]是一个算符("+"、"-"、"*"或"/"),或是在范围[-200, 200]内的一个整数
逆波兰表达式:
逆波兰表达式是一种后缀表达式,所谓后缀就是指算符写在后面。
- 平常使用的算式则是一种中缀表达式,如
( 1 + 2 ) * ( 3 + 4 )。 - 该算式的逆波兰表达式写法为
( ( 1 2 + ) ( 3 4 + ) * )。
逆波兰表达式主要有以下两个优点:
- 去掉括号后表达式无歧义,上式即便写成
1 2 + 3 4 + *也可以依据次序计算出正确结果。 - 适合用栈操作运算:遇到数字则入栈;遇到算符则取出栈顶两个数字进行计算,并将结果压入栈中
题解:
class Solution {
    public int evalRPN(String[] tokens) {
        Deque<Integer> stack = new LinkedList<Integer>();
        int n = tokens.length;
        for (int i = 0; i < n; i++) {
            String token = tokens[i];
            if (isNumber(token)) {
                stack.push(Integer.parseInt(token));
            } else {
                int num2 = stack.pop();
                int num1 = stack.pop();
                switch (token) {
                    case "+":
                        stack.push(num1 + num2);
                        break;
                    case "-":
                        stack.push(num1 - num2);
                        break;
                    case "*":
                        stack.push(num1 * num2);
                        break;
                    case "/":
                        stack.push(num1 / num2);
                        break;
                    default:
                }
            }
        }
        return stack.pop();
    }

    public boolean isNumber(String token) {
        return !("+".equals(token) || "-".equals(token) || "*".equals(token) || "/".equals(token));
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 是数组 tokens 的长度。需要遍历数组 \textit{tokens}tokens 一次,计算逆波兰表达式的值。
- 空间复杂度:O(n),其中 n 是数组 tokens 的长度。使用栈存储计算过程中的数,栈内元素个数不会超过逆波兰表达式的长度。
栈和深度优先搜索
先决条件:树的遍历
与 BFS 类似,深度优先搜索(DFS)是用于 在树/图中遍历/搜索 的另一种重要算法。也可以在更抽象的场景中使用。
正如树的遍历中所提到的,我们可以用 DFS 进行 前序遍历,中序遍历 和 后序遍历。在这三个遍历顺序中有一个共同的特性:除非我们到达最深的结点,否则我们永远不会回溯。
这也是 DFS 和 BFS 之间最大的区别,BFS 永远不会深入探索,除非它已经在当前层级访问了所有的结点。
通常,我们使用递归实现 DFS。栈在递归中起到了重要的作用。在本章中,我们将解释在执行递归时栈的作用。我们还将向你展示递归的缺点,并提供另一个 没有递归 的 DFS 实现。
本章重点介绍栈是如何在 DFS 中应用的,并帮助你更好的理解 DFS 的原理。
A 栈和 DFS
与 BFS 类似,深度优先搜索(DFS)也可用于查找从根节点到目标结点的路径。在本文中,我们提供了示例来解释 DFS 是如何工作的以及栈是如何逐步帮组 DFS 工作的。
示例
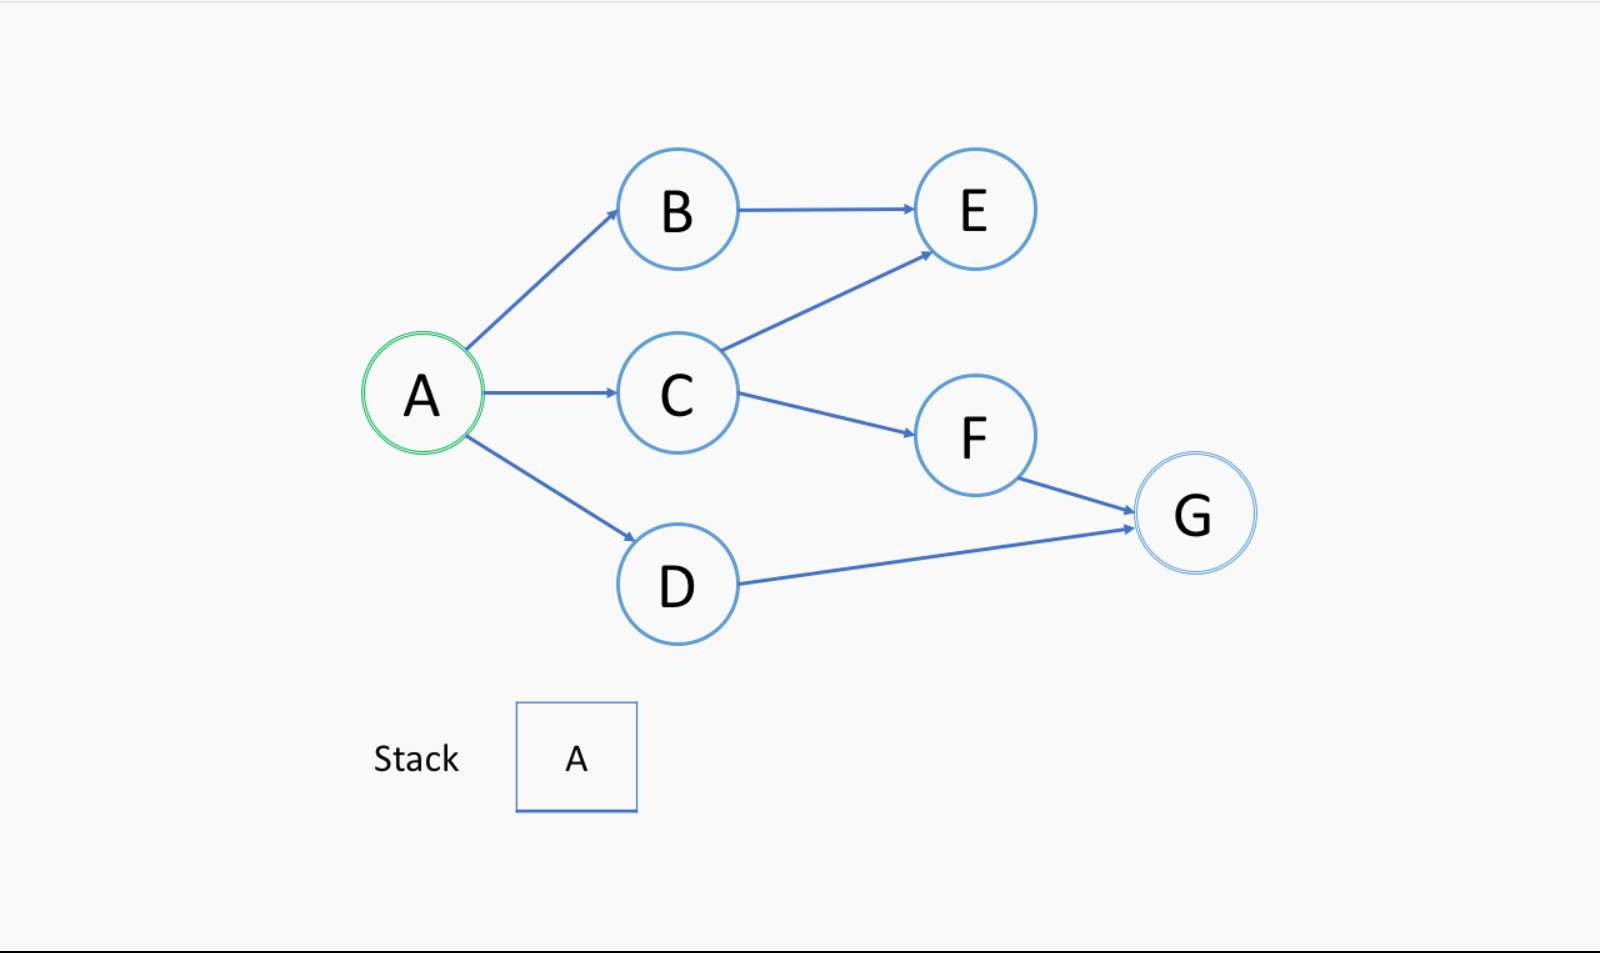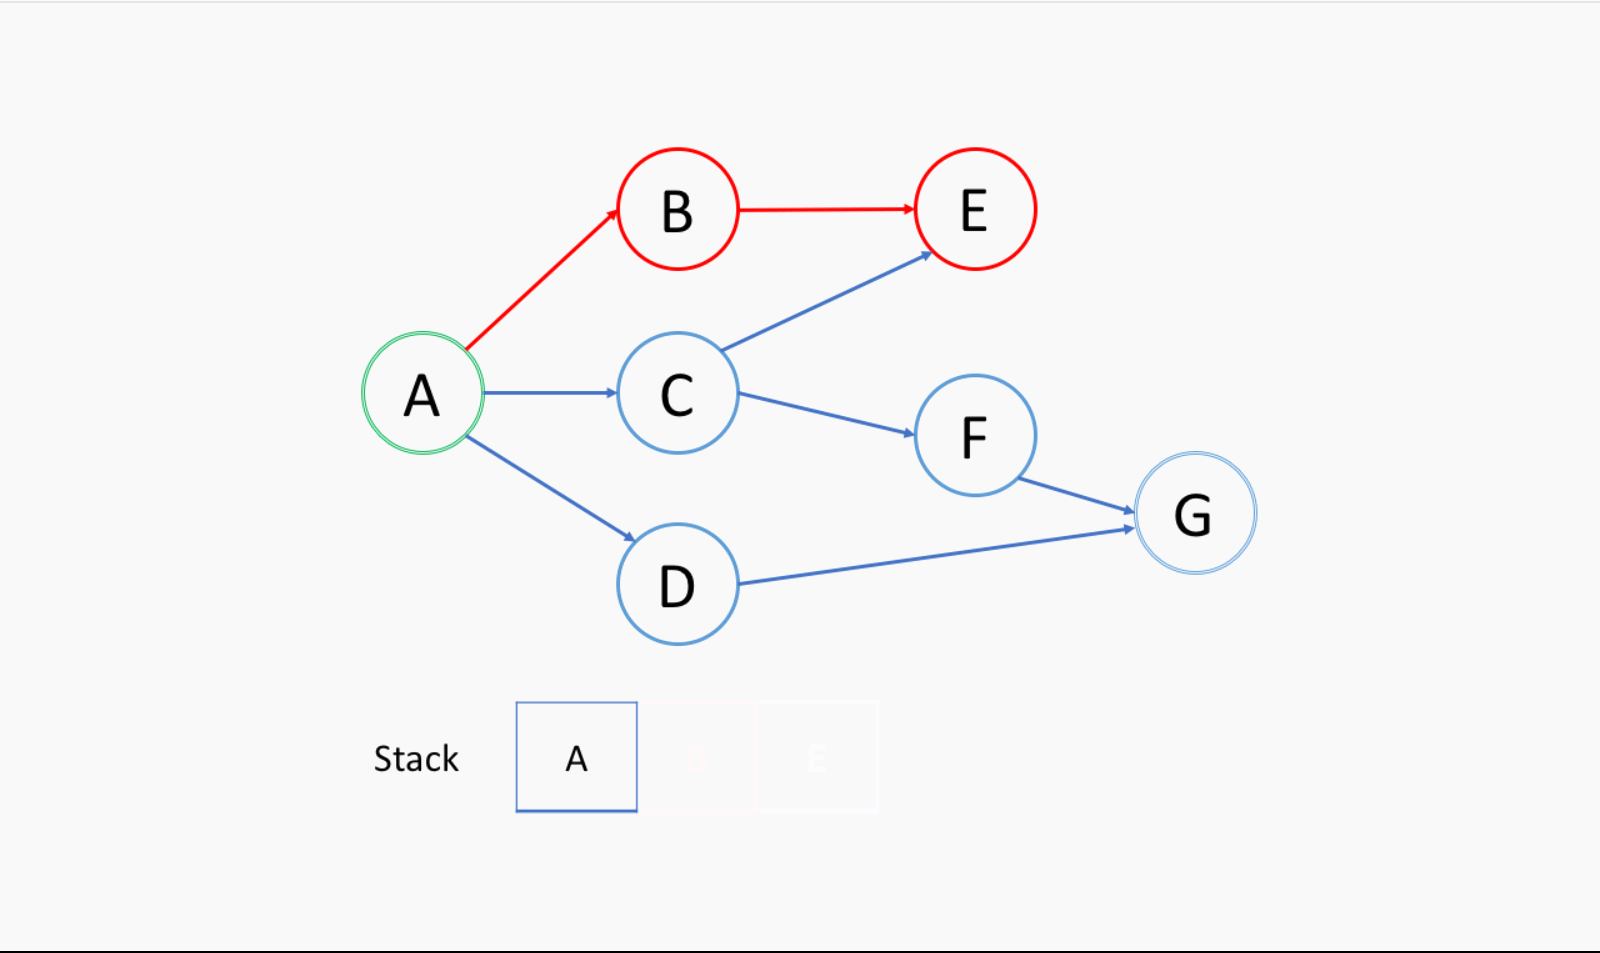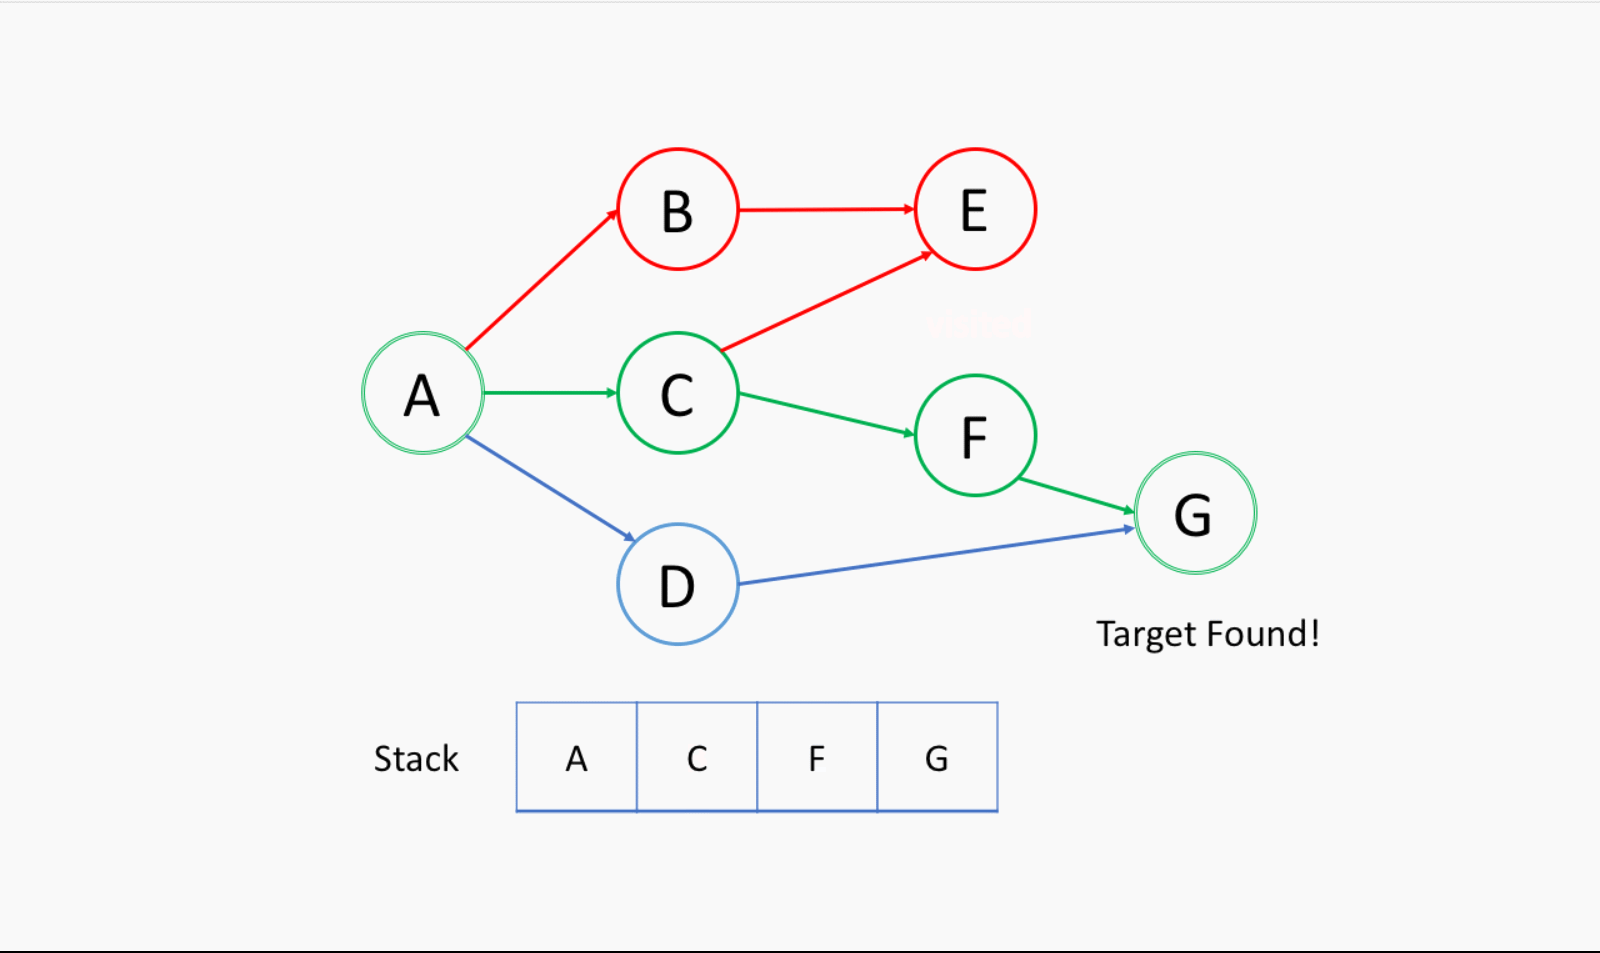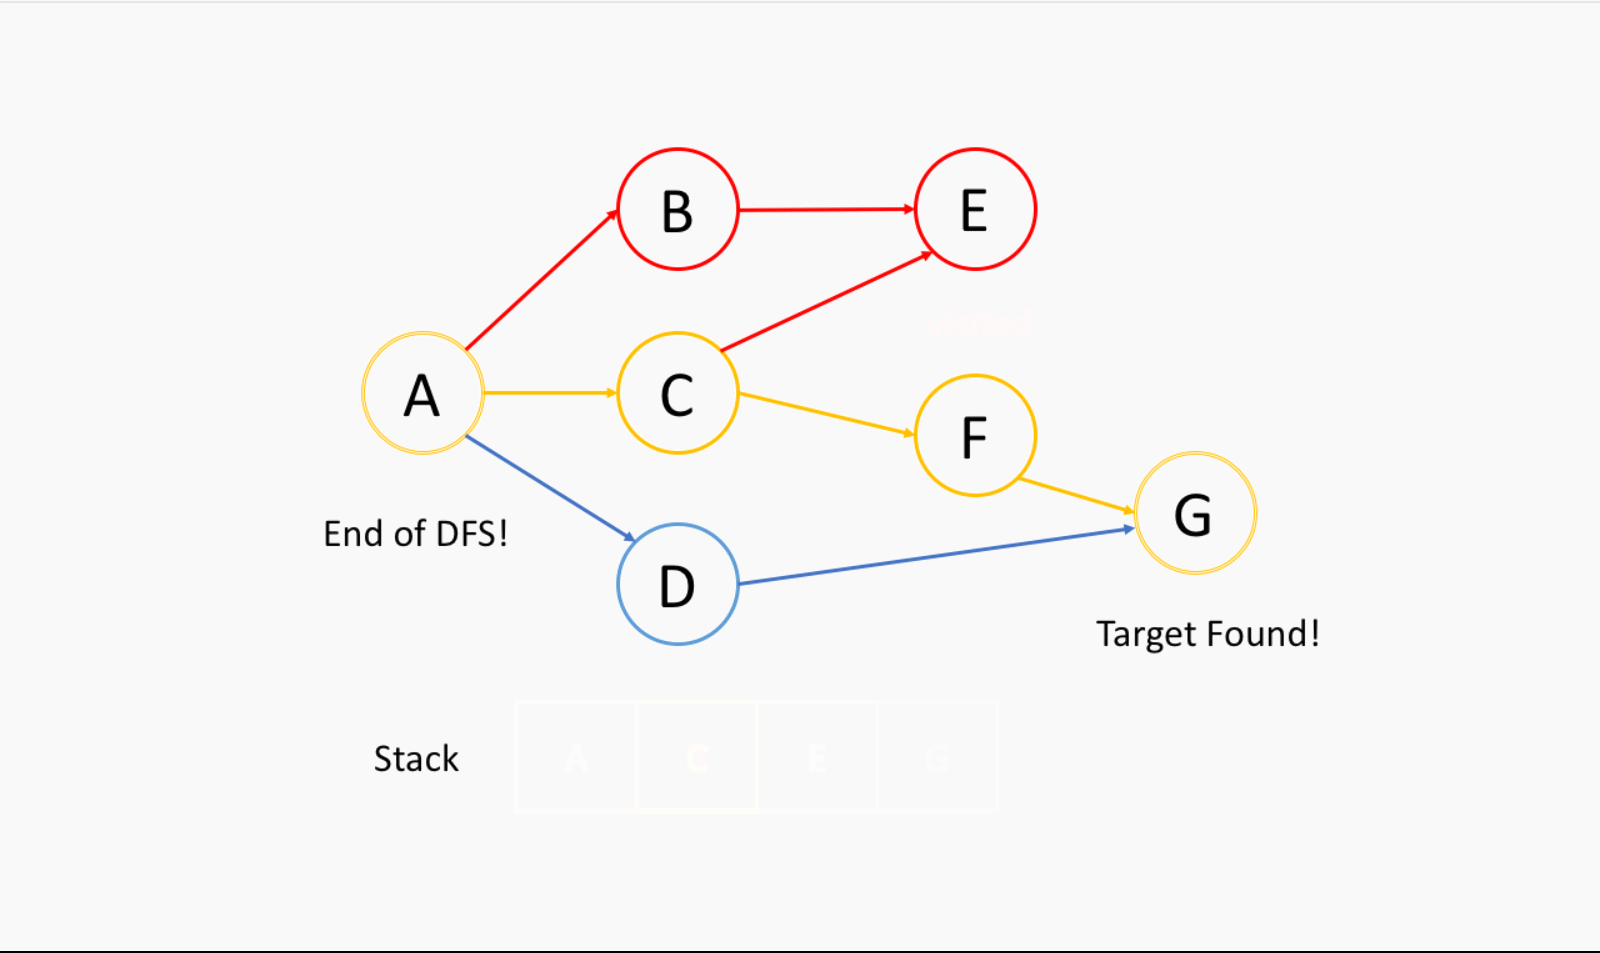
来看一个例子。我们希望通过 DFS 找出从根节点 ‘A’ 到目标结点 ‘G’ 的路径。
洞悉
看完上面的示例后,让我们回答以下问题:
- 结点的处理顺序是什么?
在上面的例子中,我们从根节点 A 开始。首先,我们选择节点 B 的路径,并进行回溯,知道我们到达结点 E,我们无法更进一步深入。然后我们回溯到 A 并选择第二条路径到结点 C。从 C 开始,我们尝试第一条路径到 E 但是 E 已被访问过。所以我们回到 C 并尝试从另一条路径到 F。最后,我们找到了 G。
总的来说,在我们到达 最深的 结点之后,我们 只 会回溯并尝试另一条路径。
因此,你在 DFS 中找到的第一条路径并不总是最短的路径。例如,在上面的例子中,我们成功找出了路径
A->C->F->G并停止了 DFS。但这并不是从A到G的最短路径。
- 栈的入栈和退栈顺序是什么?
如上面的演示所示,我们首先将根节点推入栈中;然后我们尝试第一个邻居 B 并将节点 B 推入到栈中;等等等等。当我们到达最深的结点 E 时,我们需要回溯。当我们回溯时,我们将从栈中 弹出最深的结点,这实际上是推入到栈中的 最后一个结点。
结点的处理顺序是 完全相反的顺序,就像它们被 添加 到栈中一样,它是后进先出(LIFO)。这就是我们在 DFS 中使用栈的原因。
A DFS – 模板Ⅰ
正如我们在本章的描述中提到的,在大多数情况下,我们在能使用 BFS 时也可以使用 DFS。但是有一个重要的区别:遍历顺序。
与 BFS 不同,更早访问的结点可能不是更靠近根节点的结点。因此,你在 DFS 中找到的第一条路径 可能不是最短路径。
在本文中,我们将为你提供一个 DFS 的递归模板,并向你展示栈是如何帮助这个过程的。
模板 – 递归
/*
 * Return true if there is a path from cur to target.
 */
boolean DFS(Node cur, Node target, Set<Node> visited) {
    return true if cur is target;
    for (next : each neighbor of cur) {
        if (next is not in visited) {
            add next to visted;
            return true if DFS(next, target, visited) == true;
        }
    }
    return false;
}
当我们递归地实现 DFS 时,似乎不需要使用任何栈。但实际上,我们使用的是由系统提供的 隐式栈,也称为调用栈(Call Stack)。
示例
让我们看一个例子。我们希望在下图中找到结点 0 和结点 3 之间的路径。我们还会在每次调用期间显示栈的状态。
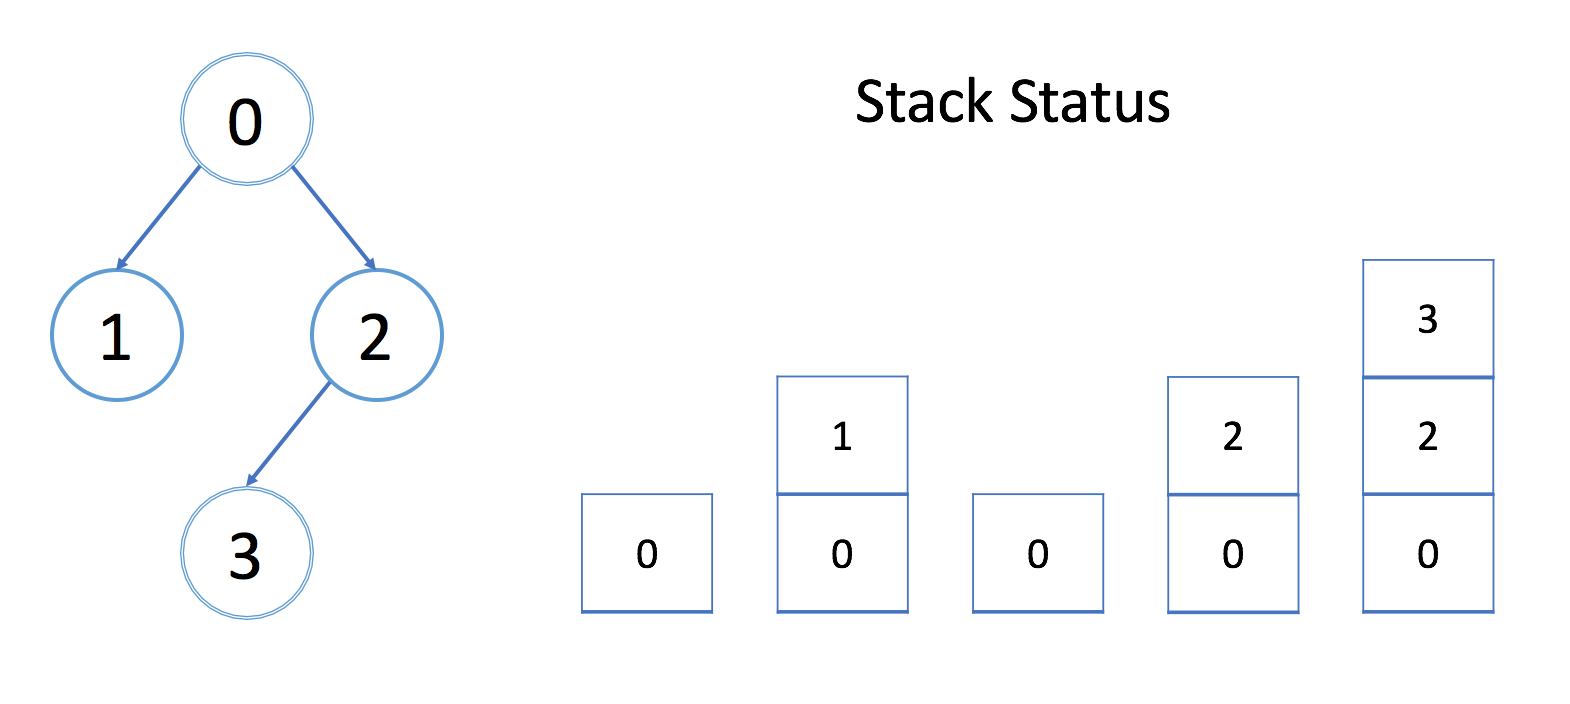
在每个堆栈元素中,都有一个整数 cur,一个整数 target,一个对 访问过的 数组的引用和一个对数组 边界 的引用,这些正是我们在 DFS 函数中的参数。我们只在上面的栈中显示 cur。
每个元素都需要固定的空间。栈的大小正好是 DFS 的深度。因此,在最坏的情况下,维护系统栈需要 O(h),其中 h 是 DFS 的最大深度。在计算空间复杂度时,永远不要忘记考虑系统栈。
在上面的模板中,我们在找到
第一条路径时停止。如果想找到最短路径呢?
提示:再添加一个参数来指示你已经找到的最短路径。
LC 岛屿数量
给你一个由 ‘1’(陆地)和 ‘0’(水)组成的二维网格,请你计算网格中岛屿的数量。
岛屿总是被水包围,并且每座岛屿只能由水平方向和 / 或竖直方向上相邻的陆地连接形成。
此外,你可以假设该网格的四条边均被水包围。
示例 1:
输入:grid = [
  ["1","1","1","1","0"],
  ["1","1","0","1","0"],
  ["1","1","0","0","0"],
  ["0","0","0","0","0"]
]
输出:1
示例 2:
输入:grid = [
  ["1","1","0","0","0"],
  ["1","1","0","0","0"],
  ["0","0","1","0","0"],
  ["0","0","0","1","1"]
]
输出:3提示:
m == grid.lengthn == grid[i].length1 <= m, n <= 300grid[i][j]的值为'0'或'1'
题解
方法一:深度优先搜索
我们可以将二维网格看成一个无向图,竖直或水平相邻的 1 之间有边相连。
为了求出岛屿的数量,我们可以扫描整个二维网格。如果一个位置为 1,则以其为起始节点开始进行深度优先搜索。在深度优先搜索的过程中,每个搜索到的 1 都会被重新标记为 0。
最终岛屿的数量就是我们进行深度优先搜索的次数。
class Solution {
    /**
    * grid 二维数组,可能是修改过的
    * r row 数组的行
    * c column 数组的列
    */
    void dfs(char[][] grid, int r, int c) {
        int nr = grid.length;
        int nc = grid[0].length;

        if (r < 0 || c < 0 || r >= nr || c >= nc || grid[r][c] == '0') {
            return;
        }

        // 将探索到的岛屿改为 '0' 避免造成重复
        grid[r][c] = '0';
        // 递归,向左侧递去,到边界后归来,以下操作类似(深度优先)
        dfs(grid, r - 1, c);
        dfs(grid, r + 1, c);
        dfs(grid, r, c - 1);
        dfs(grid, r, c + 1);
    }

    public int numIslands(char[][] grid) {
        if (grid == null || grid.length == 0) {
            return 0;
        }

        int nr = grid.length;
        int nc = grid[0].length;
        int num_islands = 0;
        for (int r = 0; r < nr; ++r) {
            for (int c = 0; c < nc; ++c) {
                if (grid[r][c] == '1') {
                    ++num_islands;
                    dfs(grid, r, c);
                }
            }
        }

        return num_islands;
    }
}
复杂度分析
- 时间复杂度:O(MN),其中 M 和 N 分别为行数和列数。
- 空间复杂度:O(MN),在最坏的情况下,整个网格均为陆地,深度优先搜索的深度达到 MN。
方法二:广度优先搜索
同样的,我们也可以使用广度优先搜索代替深度优先搜索。
为了求出岛屿的数量,我们可以扫描整个二维网格。如果一个位置为 1,则将其加入队列,开始进行广度优先搜索。在广度优先搜索的过程中,每个搜索到的 1 都会被重新标记为 0。直到队列为空,搜索结束。
最终岛屿的数量就是我们进行广度优先搜索的次数。
class Solution {
    public int numIslands(char[][] grid) {
        if (grid == null || grid.length == 0) {
            return 0;
        }

        int nr = grid.length;
        int nc = grid[0].length;
        int num_islands = 0;

        for (int r = 0; r < nr; ++r) {
            for (int c = 0; c < nc; ++c) {
                if (grid[r][c] == '1') {
                    ++num_islands;
                    grid[r][c] = '0';
                    Queue<Integer> neighbors = new LinkedList<>();
                    neighbors.add(r * nc + c); // 入队
                    while (!neighbors.isEmpty()) {
                        int id = neighbors.remove(); // 出队并赋值
                        int row = id / nc; // 计算对应行数
                        int col = id % nc; // 计算对应列数
                        if (row - 1 >= 0 && grid[row-1][col] == '1') {
                            neighbors.add((row-1) * nc + col);
                            grid[row-1][col] = '0';
                        }
                        if (row + 1 < nr && grid[row+1][col] == '1') {
                            neighbors.add((row+1) * nc + col);
                            grid[row+1][col] = '0';
                        }
                        if (col - 1 >= 0 && grid[row][col-1] == '1') {
                            neighbors.add(row * nc + col-1);
                            grid[row][col-1] = '0';
                        }
                        if (col + 1 < nc && grid[row][col+1] == '1') {
                            neighbors.add(row * nc + col+1);
                            grid[row][col+1] = '0';
                        }
                    }
                }
            }
        }

        return num_islands;
    }
}
复杂度分析
- 时间复杂度:O(MN),其中 M 和 N 分别为行数和列数。
- 空间复杂度:O(min(M, N)),在最坏情况下,整个网格均为陆地,队列的大小可以达到 min(M, N)。
LC 克隆图
给你无向 连通 图中一个节点的引用,请你返回该图的 深拷贝(克隆)。
图中的每个节点都包含它的值 val(int) 和其邻居的列表(list[Node])
class Node {
    public int val;
    public List<Node> neighbors;
}测试用例格式:
简单起见,每个节点的值都和它的索引相同。例如,第一个节点值为 1(val = 1),第二个节点值为 2(val = 2),以此类推。该图在测试用例中使用邻接列表表示。
邻接列表 是用于表示有限图的无序列表的集合。每个列表都描述了图中节点的邻居集。
给定节点将始终是图中的第一个节点(值为 1)。你必须将 给定节点的拷贝 作为对克隆图的引用返回。
示例 1:
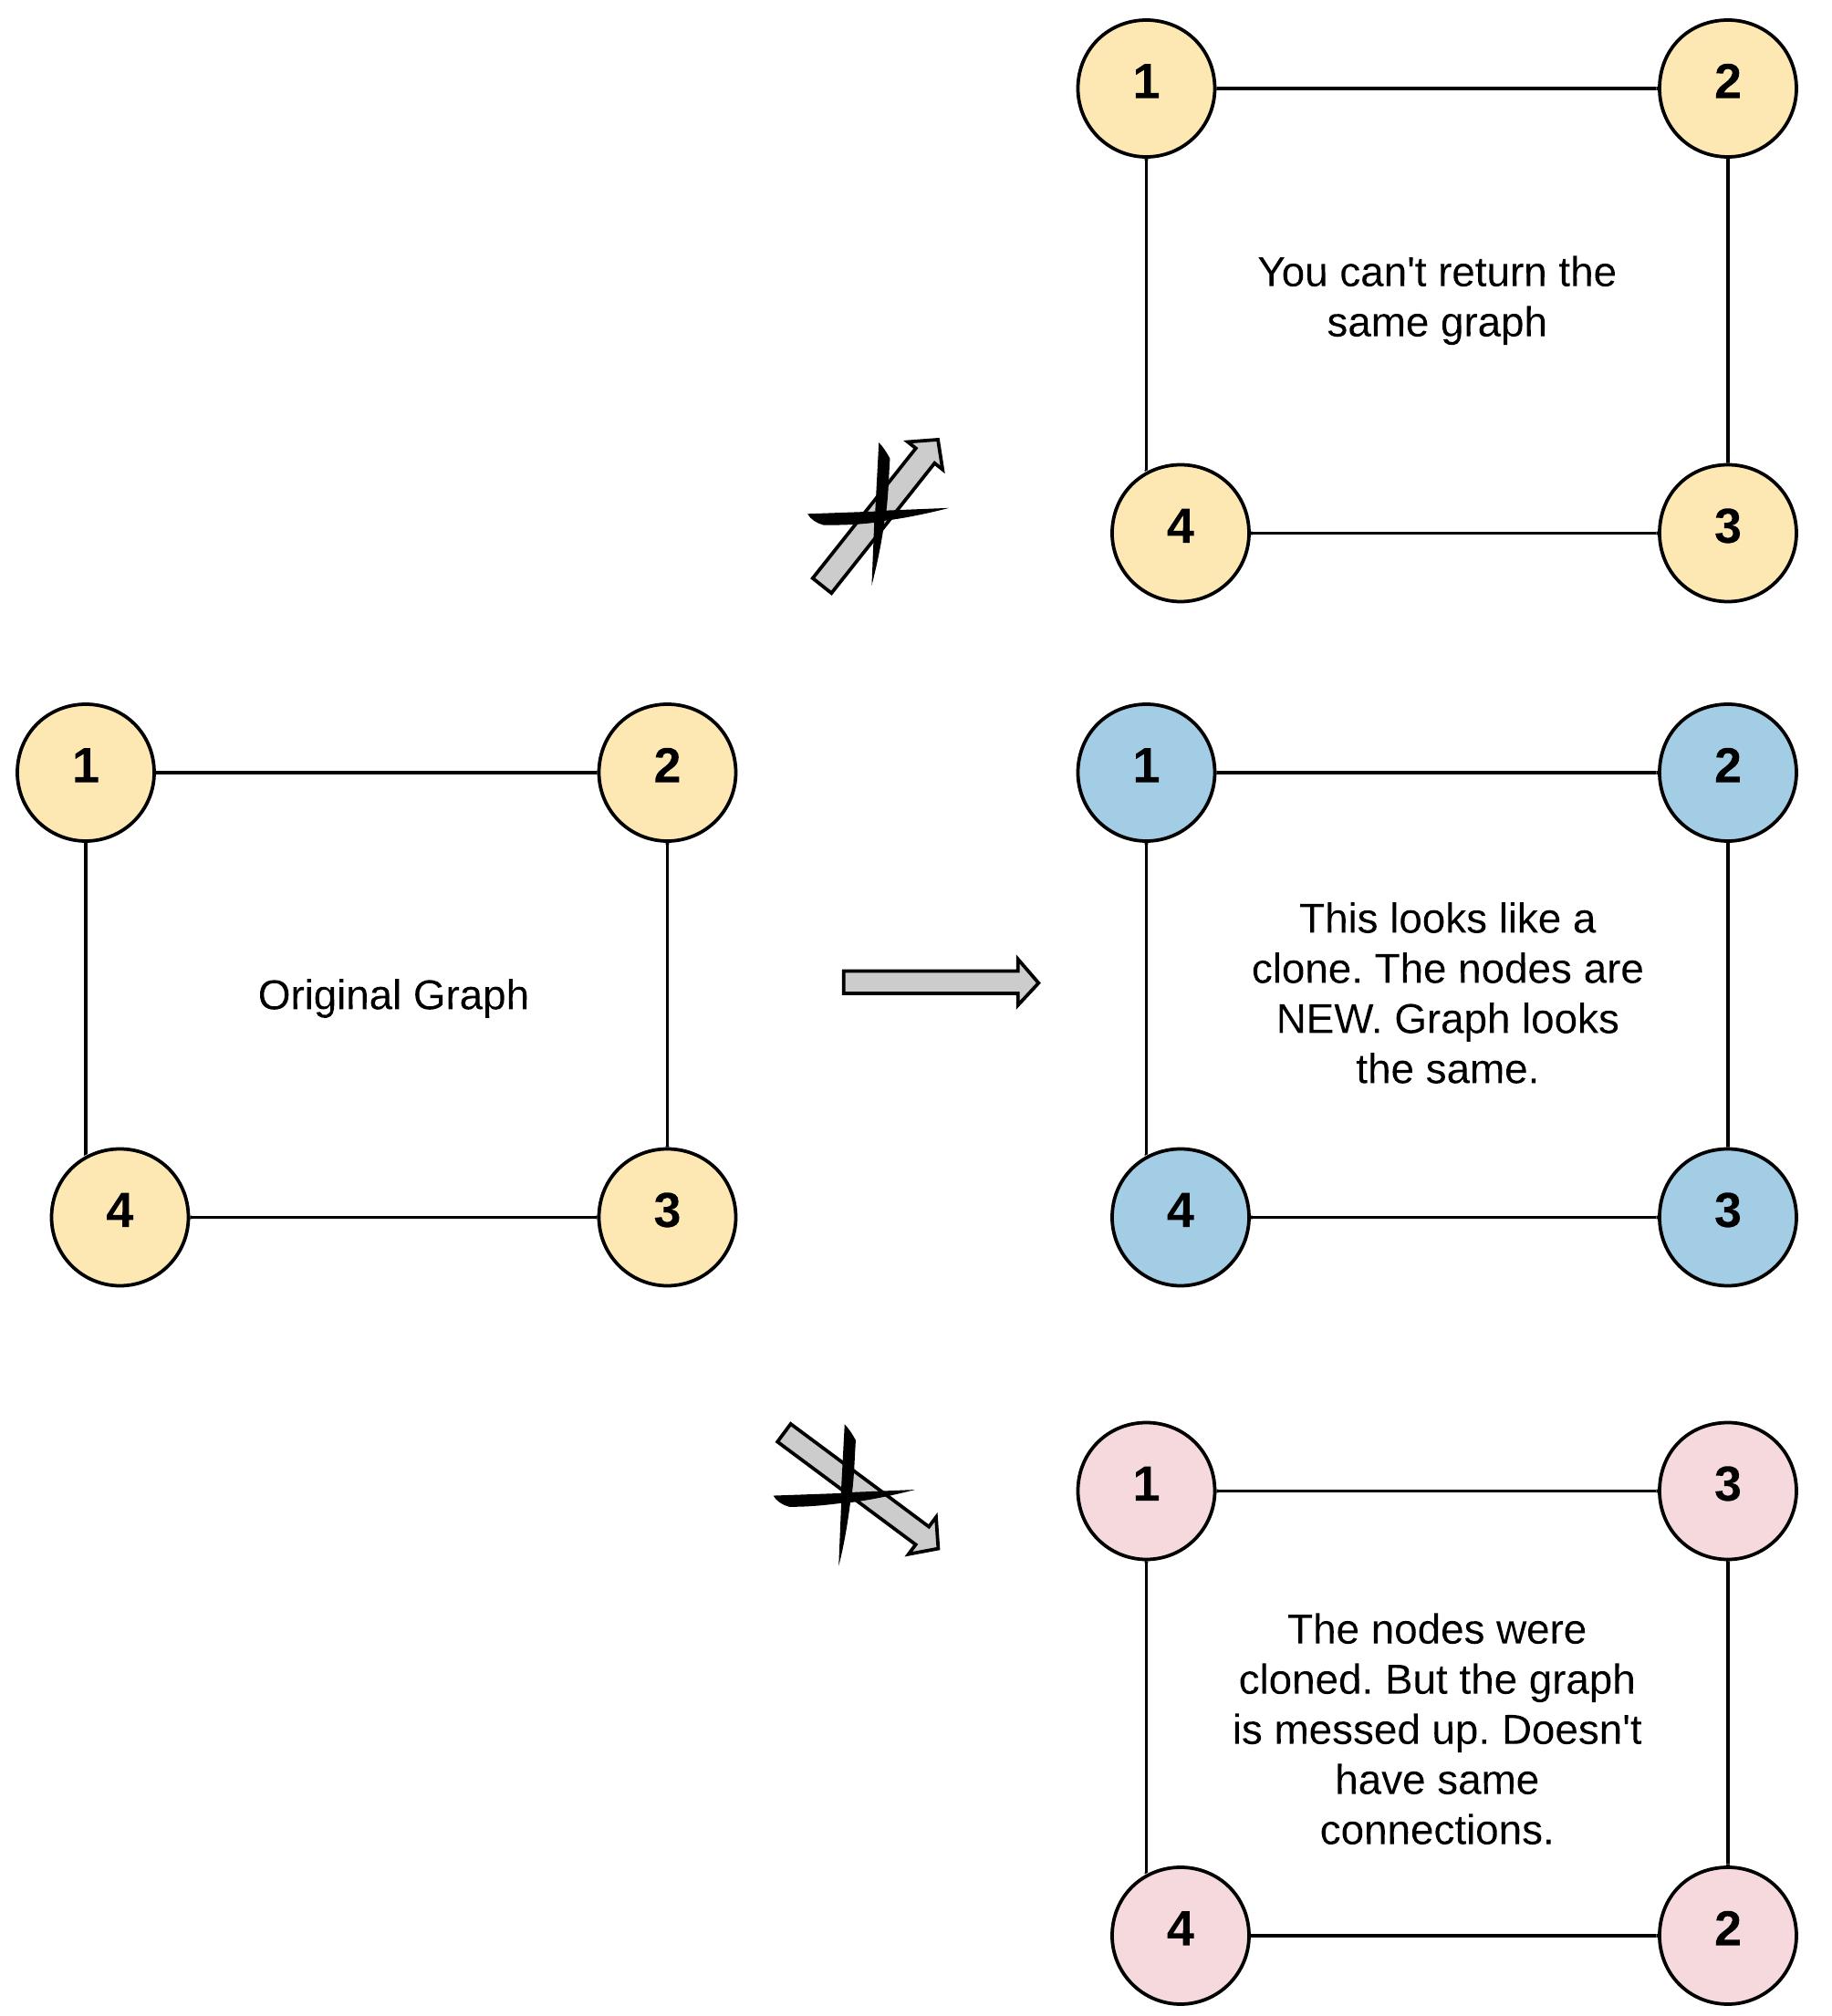
输入:adjList = [[2,4],[1,3],[2,4],[1,3]]
输出:[[2,4],[1,3],[2,4],[1,3]]
解释:
图中有 4 个节点。
节点 1 的值是 1,它有两个邻居:节点 2 和 4 。
节点 2 的值是 2,它有两个邻居:节点 1 和 3 。
节点 3 的值是 3,它有两个邻居:节点 2 和 4 。
节点 4 的值是 4,它有两个邻居:节点 1 和 3 。
示例 2:
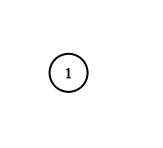
输入:adjList = [[]]
输出:[[]]
解释:输入包含一个空列表。该图仅仅只有一个值为 1 的节点,它没有任何邻居。
示例 3:
输入:adjList = []
输出:[]
解释:这个图是空的,它不含任何节点。
示例 4:
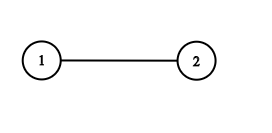
输入:adjList = [[2],[1]]
输出:[[2],[1]]提示:
- 节点数不超过 100 。
- 每个节点值
Node.val都是唯一的,1 <= Node.val <= 100。 - 无向图是一个简单图,这意味着图中没有重复的边,也没有自环。
- 由于图是无向的,如果节点 p 是节点 q 的邻居,那么节点 q 也必须是节点 p 的邻居。
- 图是连通图,你可以从给定节点访问到所有节点。
题解
方法一:深度优先搜索
/*
// Definition for a Node.
class Node {
    public int val;
    public List<Node> neighbors;
    public Node() {
        val = 0;
        neighbors = new ArrayList<Node>();
    }
    public Node(int _val) {
        val = _val;
        neighbors = new ArrayList<Node>();
    }
    public Node(int _val, ArrayList<Node> _neighbors) {
        val = _val;
        neighbors = _neighbors;
    }
}
*/
class Solution {
    private HashMap <Node, Node> visited = new HashMap <> ();
    public Node cloneGraph(Node node) {
        if (node == null) {
            return node;
        }

        // 如果该节点已经被访问过了,则直接从哈希表中取出对应的克隆节点返回
        if (visited.containsKey(node)) {
            return visited.get(node);
        }

        // 克隆节点,注意到为了深拷贝我们不会克隆它的邻居的列表
        Node cloneNode = new Node(node.val, new ArrayList());
        // 哈希表存储
        visited.put(node, cloneNode);

        // 遍历该节点的邻居并更新克隆节点的邻居列表
        for (Node neighbor: node.neighbors) {
            cloneNode.neighbors.add(cloneGraph(neighbor));
        }
        return cloneNode;
    }
}
复杂度分析
- 时间复杂度:O(N),其中 N 表示节点数量。深度优先搜索遍历图的过程中的每个节点只会被访问一次。
- 空间复杂度:O(N)。存储克隆节点和原节点的哈希表需要 O(N) 的空间,递归调用栈需要 O(H) 的空间,其中 H 是图的深度,经过放缩可以得到 O(H) = O(N),因此总体空间复杂度为 O(N)。
方法二:广度优先遍历
class Solution {
    public Node cloneGraph(Node node) {
        if (node == null) {
            return node;
        }

        HashMap<Node, Node> visited = new HashMap();

        // 将题目给定的节点添加到队列
        LinkedList<Node> queue = new LinkedList<Node> ();
        queue.add(node);
        // 克隆第一个节点并存储到哈希表中
        visited.put(node, new Node(node.val, new ArrayList()));

        // 广度优先搜索
        while (!queue.isEmpty()) {
            // 取出队列的头节点
            Node n = queue.remove();
            // 遍历该节点的邻居
            for (Node neighbor: n.neighbors) {
                if (!visited.containsKey(neighbor)) {
                    // 如果没有被访问过,就克隆并存储在哈希表中
                    visited.put(neighbor, new Node(neighbor.val, new ArrayList()));
                    // 将邻居节点加入队列中
                    queue.add(neighbor);
                }
                // 更新当前节点的邻居列表
                visited.get(n).neighbors.add(visited.get(neighbor));
            }
        }

        return visited.get(node);
    }
}
复杂度分析
- 时间复杂度:O(N),其中 N 表示节点数量。广度优先搜索遍历图的过程中每个节点只会被访问一次。
- 空间复杂度:O(N)。哈希表使用 O(N) 的空间。广度优先搜索中的队列在最坏情况下会达到 O(N) 的空间复杂度,因此总体空间复杂度为 O(N)。
LC 目标和
给你一个整数数组 nums 和一个整数 target。
向数组中的每个整数前添加 ‘+’ 或 ‘-’,然后串联起所有整数,可以构造一个 表达式:
- 例如,
num = [2, 1],可以在2之前添加‘+’,在1之前添加‘-’,然后串联起来得到表达式‘+2-1’。
返回可以通过上述方法构造的、运算结果等于 target 的不同 表达式 的数目。
示例 1:
输入:nums = [1,1,1,1,1], target = 3
输出:5
解释:一共有 5 种方法让最终目标和为 3 。
-1 + 1 + 1 + 1 + 1 = 3
+1 - 1 + 1 + 1 + 1 = 3
+1 + 1 - 1 + 1 + 1 = 3
+1 + 1 + 1 - 1 + 1 = 3
+1 + 1 + 1 + 1 - 1 = 3
示例 2:
输入:nums = [1], target = 1
输出:1提示:
1 <= nums.length <= 200 <= nums[i] <= 10000 <= sum(nums[i]) <= 1000-1000 <= target <= 1000
题解
方法一:回溯
class Solution {
    int count = 0;

    public int findTargetSumWays(int[] nums, int target) {
        backtrack(nums, target, 0, 0);
        return count;
    }

    public void backtrack(int[] nums, int target, int index, int sum) {
        if (index == nums.length) {
            if (sum == target) {
                count++;
            }
        } else {
            backtrack(nums, target, index + 1, sum + nums[index]);
            backtrack(nums, target, index + 1, sum - nums[index]);
        }
    }
}
复杂度分析
- 时间复杂度:O(2n),其中 n 是数组 nums 的长度。回溯需要遍历所有不同的表达式,共有 2n 中不同的表达式,每种表达式计算结果需要 O(1) 的时间,因此总时间复杂度是 O(2n)。
- 空间复杂度:O(n),其中 n 是数组 nums 的长度。空间复杂度主要取决于递归调用的栈空间,栈的深度不超过 n。
A DFS – 模板Ⅱ
递归解决方案的优点是它更容易实现。 但是,存在一个很大的缺点:如果递归的深度太高,你将遭受堆栈溢出。 在这种情况下,您可能会希望使用 BFS,或使用显式栈实现 DFS。
这里我们提供了一个使用显式栈的模板:
/*
 * Return true if there is a path from cur to target.
 */
boolean DFS(int root, int target) {
    Set<Node> visited;
    Stack<Node> s;
    add root to s;
    while (s is not empty) {
        Node cur = the top element in s;
        return true if cur is target;
        for (Node next : the neighbors of cur) {
            if (next is not in visited) {
                add next to s;
                add next to visited;
            }
        }
        remove cur from s;
    }
    return false;
}
该逻辑与递归解决方案完全相同。但我们使用 while 循环和栈来模拟递归期间的系统调用栈。 手动运行几个示例肯定会帮助你更好地理解它。
LC 二叉树中的中序遍历
给定一个二叉树的根节点 root,返回它的 中序 遍历。
示例 1:
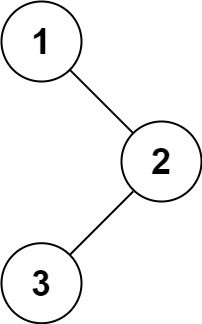
输入:root = [1,null,2,3]
输出:[1,3,2]
示例 2:
输入:root = []
输出:[]
示例 3:
输入:root = [1]
输出:[1]提示:
- 树中节点数目在范围
[0, 100]内 -100 <= Node.val <= 100
进阶:递归算法很简单,你可以通过迭代算法完成吗?
题解
方法一:递归
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    public List<Integer> inorderTraversal(TreeNode root) {
        List<Integer> res = new LinkedList<Integer>();
        inorder(root, res);
        return res;
    }
    public void inorder(TreeNode root, List<Integer> res) {
        if (root == null) {
            return;
        }
        inorder(root.left, res);
        res.add(root.val);
        inorder(root.right, res);
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 为二叉树节点的个数。二叉树的遍历中每个节点会被访问一次且只会被访问一次。
- 空间复杂度:O(n)。空间复杂度取决于递归的栈深度,而栈深度在二叉树为一条链的情况下会达到 O(n) 的级别。
方法二:迭代
class Solution {
    public List<Integer> inorderTraversal(TreeNode root) {
        List<Integer> res = new ArrayList<Integer>();
        Deque<TreeNode> stk = new LinkedList<TreeNode>();
        while (root != null || !stk.isEmpty()) {
            while (root != null) {
                stk.push(root);
                root = root.left;
            }
            root = stk.pop();
            res.add(root.val);
            root = root.right;
        }
        return res;
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 为二叉树节点的个数。二叉树的遍历中每个节点会被访问一次且只会被访问一次。
- 空间复杂度:O(n)。空间复杂度取决于栈深度,而栈深度在二叉树为一条链的情况下会达到 O(n) 的级别。
小结
在前面的章节中,我们介绍了两个数据结构:队列和栈
1. 队列
队列 是一种 FIFO 式的数据结构:第一个元素将被首先处理。有两个重要操作:入队和出队。我们可以使用带有两个指针的动态数组来实现队列。
我们可以使用 广度优先搜索(BFS)。
队列还有一些重要的扩展,例如:
- 双端队列
- 优先队列
2. 栈
栈 是一种 LIFO 式的数据结构:最后一个元素将被首先处理。有两个重要操作:push 和 pop。栈的实现非常简单,使用动态数组就足以实现栈。
当满足 LIFO 原则时,我们使用栈。深度优先搜索(DFS)是栈的一个重要应用。
3. 总结
总之,你应该能够理解和比较一下几组概念:
- FIFO 和 LIFO;
- 队列 和 栈;
- BFS 和 DFS。
LC 用栈实现队列
请你仅使用两个栈实现先入先出队列。队列应当支持一般队列支持的所有操作(push、pop、peek、empty)
实现 MyQueue 类:
void push(int x)将元素 x 推到队列的末尾int pop()从队列的开头移除并返回元素int peek()返回队列开头的元素boolean empty()如果队列为空,返回true;否则,返回false
说明:
- 只能 使用标准的栈操作 — 也就是只有
push to top, peek/pop from top, size和is empty操作时合法的。 - 你所使用的语言也许不支持栈。你可以使用 list 或者 deque(双端队列)来模拟一个栈,只要是标准的栈操作即可。
示例 1:
输入:
["MyQueue", "push", "push", "peek", "pop", "empty"]
[[], [1], [2], [], [], []]
输出:
[null, null, null, 1, 1, false]
解释: MyQueue myQueue = new MyQueue(); myQueue.push(1); // queue is: [1] myQueue.push(2); // queue is: [1, 2] (leftmost is front of the queue) myQueue.peek(); // return 1 myQueue.pop(); // return 1, queue is [2] myQueue.empty(); // return false
提示:
1 <= x <= 9- 最多调用
100次push、pop、peek和empty - 假设所有操作都是有效的 (例如,一个空的队列不会调用
pop或者peek操作)
题解
class MyQueue {
    private Deque<Integer> inStack;
    private Deque<Integer> outStack;

    public MyQueue() {
        inStack = new ArrayDeque<Integer>();
        outStack = new ArrayDeque<Integer>();
    }

    public void push(int x) {
        inStack.push(x);
    }

    public int pop() {
        if (outStack.isEmpty()) {
            inToOut();
        }
        return outStack.pop();
    }

    public int peek() {
        if (outStack.isEmpty()) {
            inToOut();
        }
        return outStack.peek();
    }

    public boolean empty() {
        return inStack.isEmpty() && outStack.isEmpty();
    }
    public void inToOut() {
        while (!inStack.isEmpty()) {
            outStack.push(inStack.pop());
        }
    }
}

/**
 * Your MyQueue object will be instantiated and called as such:
 * MyQueue obj = new MyQueue();
 * obj.push(x);
 * int param_2 = obj.pop();
 * int param_3 = obj.peek();
 * boolean param_4 = obj.empty();
 */
复杂度分析
- 时间复杂度:push 和 empty 为 O(1),pop 和 peek 为均摊 O(1)。对于每个元素,至多入栈和出栈各两次,故均摊复杂度为 O(1)。
- 空间复杂度:O(n)。其中 n 是操作总数。对于有 n 次 push 操作的情况,队列中会有 n 个元素,故空间复杂度为 O(n)。
LC 用队列实现栈
请你仅使用两个队列实现一个后入先出(LIFO)的栈,并支持普通栈的全部四种操作(push、top、pop 和 empty)
实现 MyStack 类:
void push(int x)将元素 x 压入栈顶。int pop()移除并返回栈顶元素。int top()返回栈顶元素。boolean empty()如果栈是空的,返回true;否则,返回false。
注意:
- 你只能使用队列的基本操作 —— 也就是
push to back、peek/pop from front、size和is empty这些操作。 - 你所使用的语言也许不支持队列。 你可以使用 list (列表)或者 deque(双端队列)来模拟一个队列 , 只要是标准的队列操作即可。
示例:
输入:
["MyStack", "push", "push", "top", "pop", "empty"]
[[], [1], [2], [], [], []]
输出:
[null, null, null, 2, 2, false]
解释: MyStack myStack = new MyStack(); myStack.push(1); myStack.push(2); myStack.top(); // 返回 2 myStack.pop(); // 返回 2 myStack.empty(); // 返回 False
提示:
1 <= x <= 9- 最多调用
100次push、pop、top和empty - 每次调用
pop和top都保证栈不为空
进阶:能否仅使用一个队列来实现栈。
题解
方法二:一个队列
class MyStack {
    Queue<Integer> queue;
    public MyStack() {
        queue = new LinkedList<Integer>();
    }

    public void push(int x) {
        int n = queue.size();
        queue.offer(x);
        for (int i = 0; i < n; i++) {
            queue.offer(queue.poll());
        }
    }

    public int pop() {
        return queue.poll();
    }

    public int top() {
        return queue.peek();
    }

    public boolean empty() {
        return queue.isEmpty();
    }
}

/**
 * Your MyStack object will be instantiated and called as such:
 * MyStack obj = new MyStack();
 * obj.push(x);
 * int param_2 = obj.pop();
 * int param_3 = obj.top();
 * boolean param_4 = obj.empty();
 */
复杂度分析
- 时间复杂度:入栈操作 O(n),其余操作都是 O(1),其中 n 是栈内的元素个数。入栈操作需要将队列中的 n 个元素出队,并入队 n + 1 个元素到队列,共有 2n + 1 次操作,每次出队和入队操作的时间复杂度都是 O(1),因此入栈操作的时间复杂度是 O(n)。出栈操作对应将队列的前端元素出队,时间复杂度时 O(1)。获得栈顶元素操作对应获得队列的前端元素,时间复杂度是 O(1)。判断栈是否为空操作只需要判断队列是否为空,时间复杂度是 O(1)。
- 空间复杂度:O(n),其中 n 是栈内的元素个数。需要使用一个队列存储栈内的元素。
LC 字符串解码
给定一个经过编码的字符串,返回它解码后的字符串。
编码规则为:k[encoded_string],表示其中方括号内部的 encoded_string 正好重复 k 次。注意 k 保证为正整数。
你可以认为输入字符串总是有效的;输入字符串中没有额外的空格,且输入的方括号总是符合格式要求的。
此外,你可以认为原始数据不包含数字,所有的数字只表示重复的次数 k,例如不会出现像 3a 或 2[4] 的输入。
示例 1:
输入:s = "3[a]2[bc]"
输出:"aaabcbc"
示例 2:
输入:s = "3[a2[c]]"
输出:"accaccacc"
示例 3:
输入:s = "2[abc]3[cd]ef"
输出:"abcabccdcdcdef"
示例 4:
输入:s = "abc3[cd]xyz"
输出:"abccdcdcdxyz"提示:
1 <= s.length <= 30s由小写英文字母、数字和方括号'[]'组成s保证是一个 有效 的输入。s中所有整数的取值范围为[1, 300]
题解
查看解析
在本题中,可能会出现括号嵌套的情况,比如 2[a2[bc]],这种情况我们可以先转化成 2[abcbc],再转化成 abcbcabcbc。我们可以把字母、数字和括号看成独立的 TOKEN,并用栈来维护这些 TOKEN:
- 如果当前的字符为数位,解析出一个数字(连续的多个数位)并进栈
- 如果当前的字符为字母或左括号,直接进栈
- 如果当前的字符为右括号,开始出栈,一直到左括号出栈,出栈序列反转后拼接成一个字符串,此时取出栈顶的数字,就是这个字符应该出现的次数,根据这个次数和字符串构造出新的字符串并进栈
class Solution {
  int ptr;

  public String decodeString(String s) {
    LinkedList<String> stk = new LinkedList<String>();
    ptr = 0;

    while (ptr < s.length()) {
      char cur = s.charAt(ptr);
      // Character.isDigit() 判断是否为数字字符
      if (Character.isDigit(cur)) {
        // 获取一个数字并进栈
        String digits = getDigits(s);
        stk.addLast(digits);
      }
      // Character.isLetter() 判断是否为字母字符
      else if (Character.isLetter(cur) || cur == '[') {
        // 获取一个字母并进栈
        // String.valueOf() 将基本数据类型转换为 String 类型
        stk.addLast(String.valueOf(s.charAt(ptr++)));
      }
      else {
        ++ptr;
        LinkedList<String> sub = new LinkedList<String>();
        // 将括号中的字符加入栈中
        while (!"[".equals(stk.peekLast())) {
          sub.addLast(stk.removeLast());
        }
        // Collections.reverse() 将集合顺序反转
        Collections.reverse(sub);
        // 左括号出栈
        stk.removeLast();
        // 此时栈顶为当前 sub 对应的字符串应该出现的次数
        int repTime = Integer.parseInt(stk.removeLast());
        StringBuffer t = new StringBuffer();
        String o = getString(sub);
        // 构造字符串
        while (repTime-- > 0) {
          t.append(o);
        }
        // 将构造好的字符串入栈
        stk.addLast(t.toString());
      }
    }
   return getString(stk);
  }

  public String getDigits(String s) {
    StringBuffer ret = new StringBuffer();
    while (Character.isDigit(s.charAt(ptr))) {
      ret.append(s.charAt(ptr++));
    }
    return ret.toString();
  }

  public String getString(LinkedList<String> v) {
    StringBuffer ret = new StringBuffer();
    for (String s : v) {
      ret.append(s);
    }
    return ret.toString();
  }
}复杂度分析
- 时间复杂度:记解码后得出的字符串长度为 S,除了遍历一次原字符串 s,我们还需要将解码后的字符串中的每个字符都入栈,并最终拼接进答案中,故渐进时间复杂度为 O(S + |s|),即O(S)。
- 空间复杂度:记解码后得出的字符串长度为 S,这里用栈维护 TOKEN,栈的总大小最终与 S 相同,故渐进空间复杂度为 O(S)。
LC 图像渲染
有一幅以 m x n 的二维整数数组表示的图画 image,其中 image[i][j] 表示该图画的像素值大小。
你也被给予三个整数 sr,sc 和 newColor。你应该从像素 image[sr][sc] 开始对图像进行 上色填充。
为了完成 上色工作,从初始像素开始,记录初始坐标的 上下左右四个方向上 像素值与初始坐标相同的相连像素点,接着再记录这四个方向上符合条件的像素点与他们对应 四个方向上 像素值与初始坐标相同的相连像素点,……,重复该过程。将所有记录的像素点的颜色值改为 newColor。
最后返回 经过上色渲染后的图像。
示例 1:
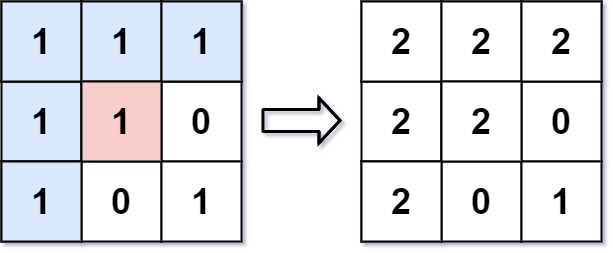
输入: image = [[1,1,1],[1,1,0],[1,0,1]],sr = 1, sc = 1, newColor = 2
输出: [[2,2,2],[2,2,0],[2,0,1]]
解析: 在图像的正中间,(坐标(sr,sc)=(1,1)),在路径上所有符合条件的像素点的颜色都被更改成2。
注意,右下角的像素没有更改为2,因为它不是在上下左右四个方向上与初始点相连的像素点。
示例 2:
输入: image = [[0,0,0],[0,0,0]], sr = 0, sc = 0, newColor = 2
输出: [[2,2,2],[2,2,2]]提示:
m == image.lengthn == image[i].lengthl <= m, n <= 50- 0 <= imagei, newColor < 216
0 <= sr < m0 <= sr < n
题解:
class Solution {
    int[] dx = {1, 0, 0, -1};
    int[] dy = {0, 1, -1, 0};

    public int[][] floodFill(int[][] image, int sr, int sc, int color) {
        int currColor = image[sr][sc];
        if (currColor != color) {
            dfs(image, sr, sc, currColor, color);
        }
        return image;
    }

    public void dfs(int[][] image, int x, int y, int currColor, int color) {
        if (image[x][y] == currColor) {
            image[x][y] = color;
            for (int i = 0; i < 4; i++) {
              	// 遍历四个方向
                int mx = x + dx[i], my = y + dy[i];
              	// 若不超过边界
                if (mx >= 0 && mx < image.length && my >= 0 && my < image[0].length) {
                    dfs(image, mx, my, currColor, color);
                }
            }
        }
    }
}
复杂度分析
- 时间复杂度:O(n × m),其中 n 和 m 分别是二维数组的行数和列数。最坏情况下需要遍历所有的方格一次。
- 空间复杂度:O(n × m),其中 n 和 m 分别是二维数组的行数和列数。主要为栈空间的开销。
LC 01矩阵
给定一个由 0 和 1 组成的矩阵 mat,请输出一个大小相同的矩阵,其中每一个格子是 mat 中对应位置到最近的 0 的距离。
示例 1:
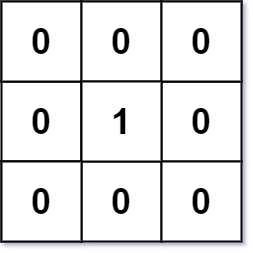
输入:mat = [[0,0,0],[0,1,0],[0,0,0]]
输出:[[0,0,0],[0,1,0],[0,0,0]]
示例 2:
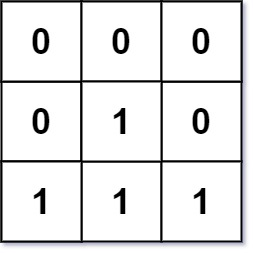
输入:mat = [[0,0,0],[0,1,0],[1,1,1]]
输出:[[0,0,0],[0,1,0],[1,2,1]]提示:
m == mat.lengthn == mat[i].length- 1 < =m, n <= 104
- 1 <= m*n <= 104
mat[i][j] is either 0 or 1mat中至少有一个0
题解
方法一:广度优先搜索
查看思路
我们需要对于每一个 1 找到离他最近的 0。如果只有一个 0 的话,我们从这个 0 开始广度优先搜索就可以完成了。
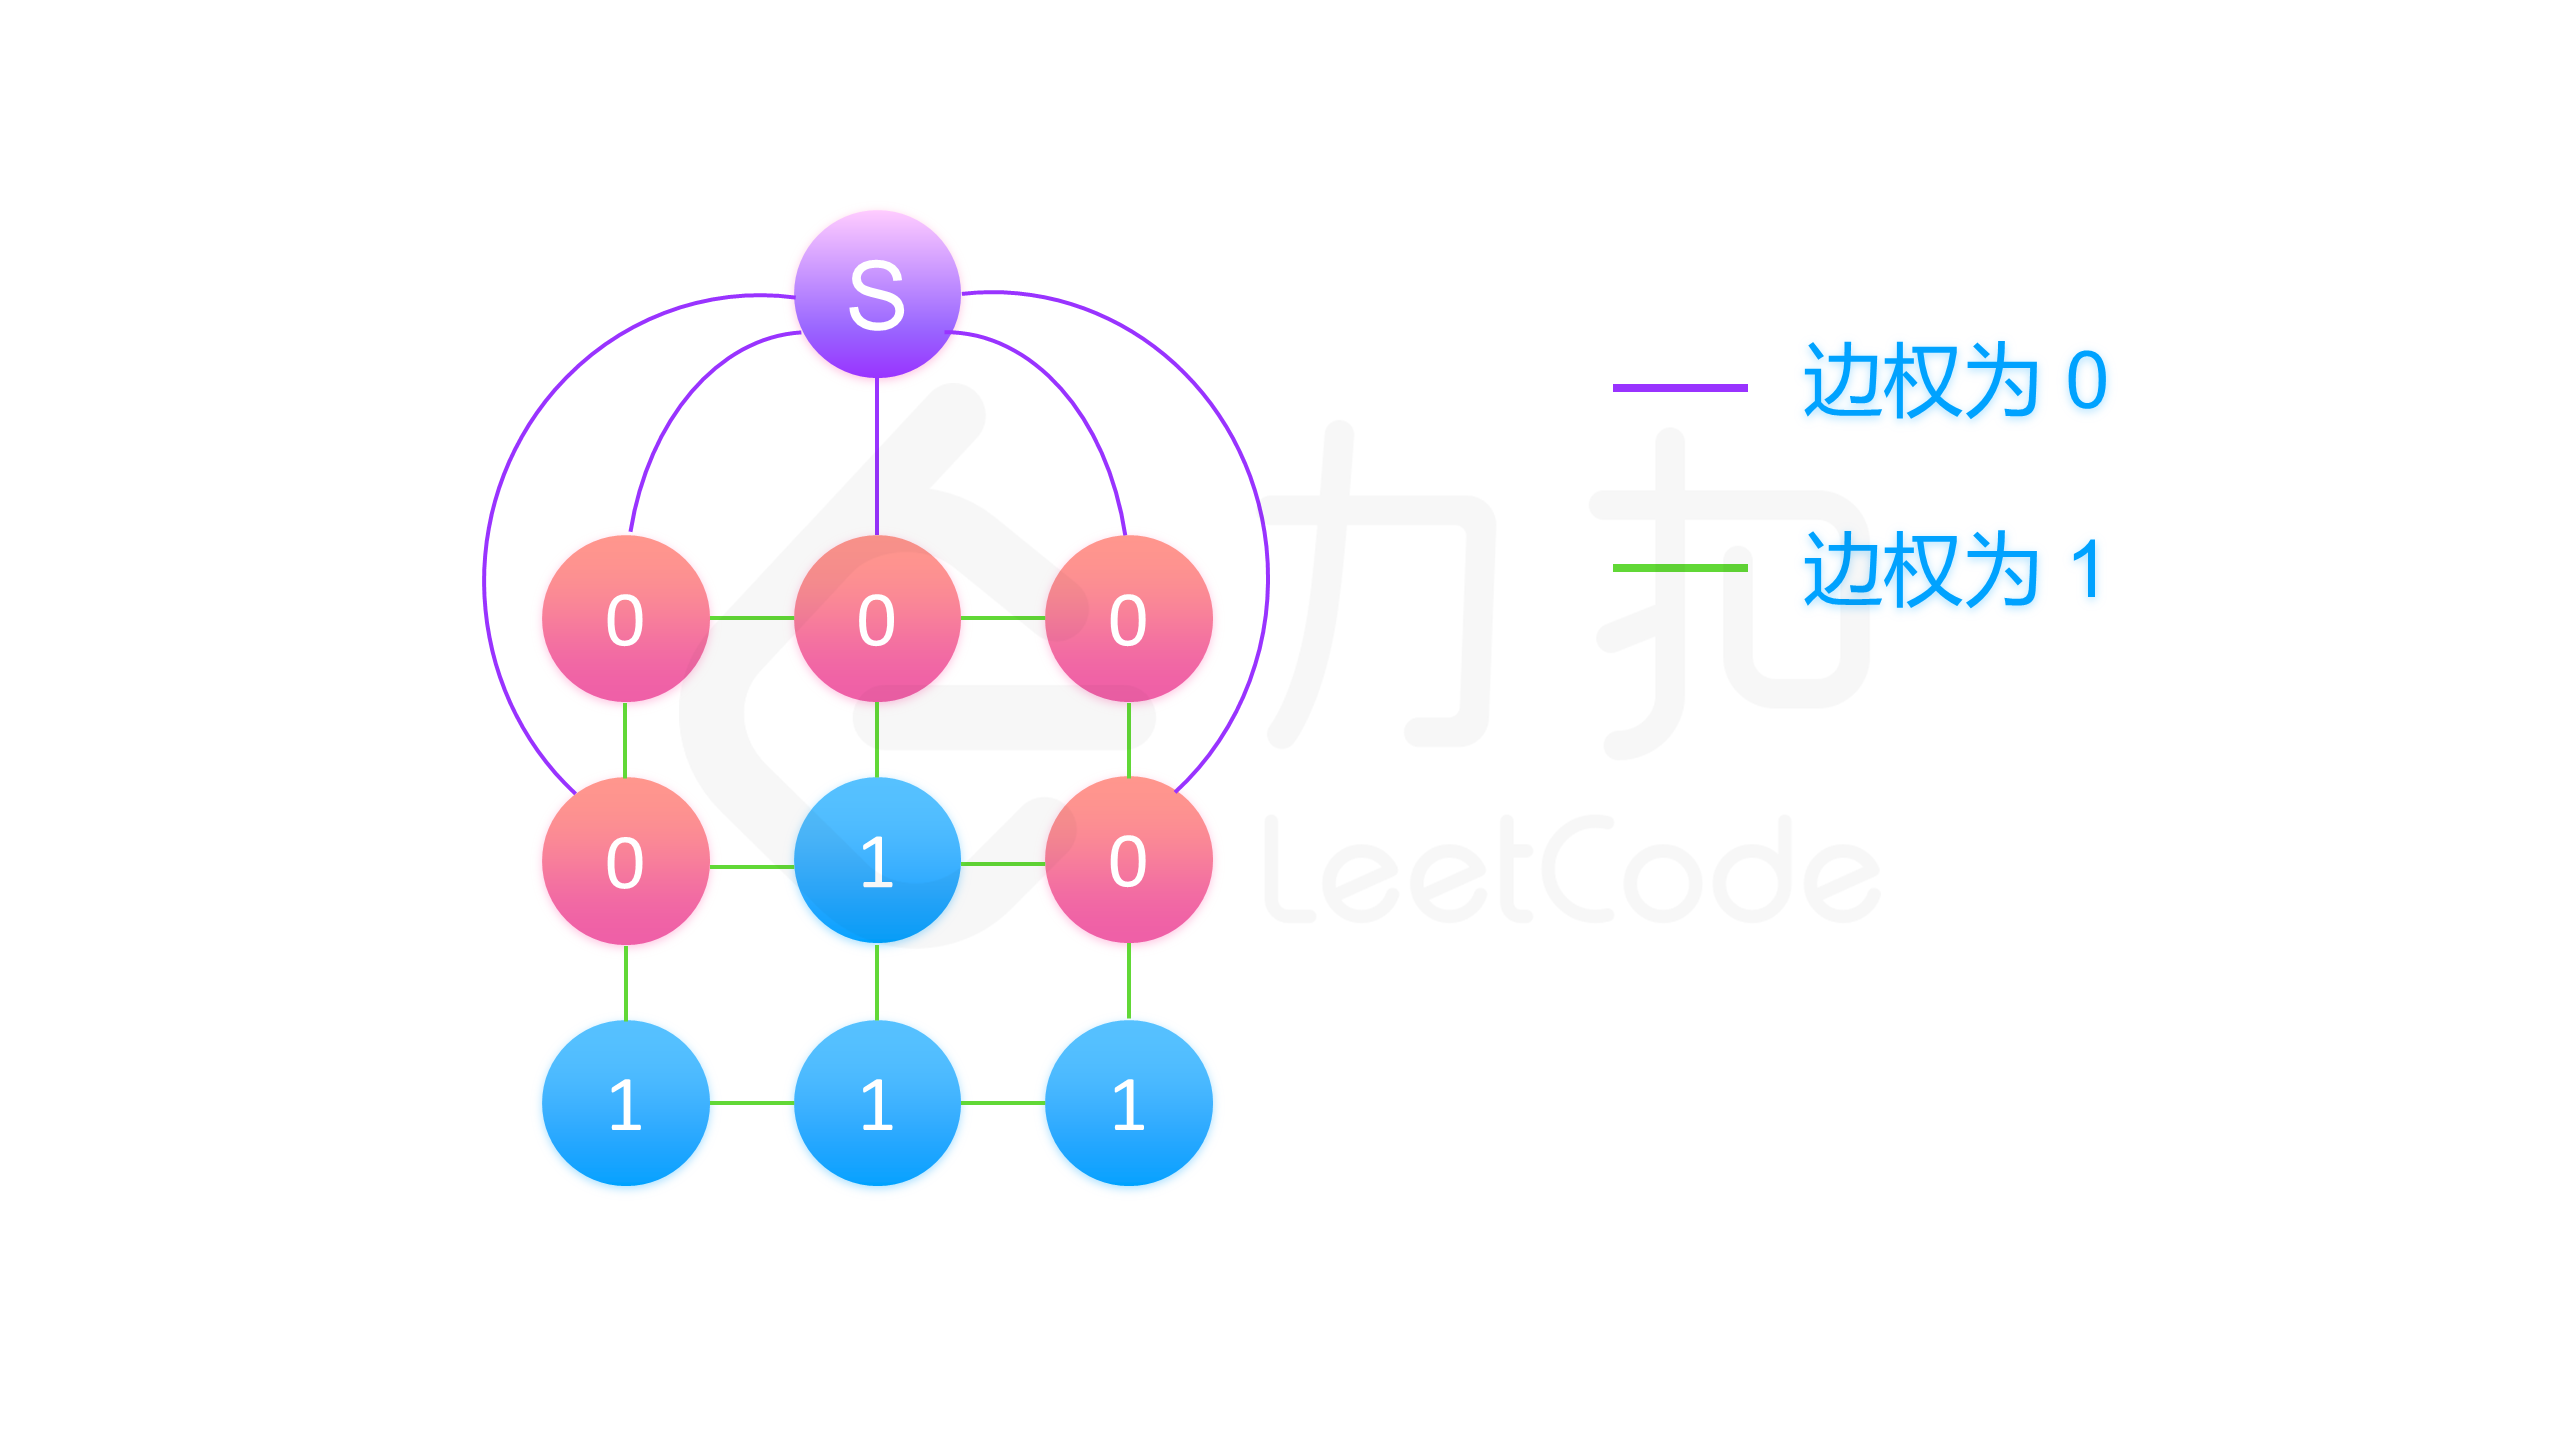
但在实际的题目中,我们会有不止一个 0。我们可以添加是一个 “超级零”,它与矩阵中的所有 0 相连,这样的话,任意一个 1 到它最近的 0 的距离,会等于这个 1 到 “超级零” 的距离减去一
由于我们只有一个 “超级零”,我们就以它为起点进行广度优先搜索。这个 “超级零” 只和矩阵中的 0 相连,所以在广度优先搜索的第一步中,“超级零” 会被弹出队列,而所有的 0 会被加入队列,他们到 “超级零” 的距离为 1.这就等价于:一开始我们就将所有的 0 加入队列,他们的初始距离为 0.这样一来,在广度优先搜索的过程中,我们每遇到一个 1,就得到了它到 “超级零” 的距离减一,也就是这个 1 到最近的 0 的距离。
class Solution {
  static int[][] dirs = {{-1, 0}, {1, 0}, {0, -1}, {0, 1}};

  public int[][] updateMatrix(int[][] matrix) {
    int m = matrix.length, n = matrix[0].length;
    int[][] dist = new int[m][n];
    boolean[][] seen = new boolean[m][n];
    Queue<int[]> queue = new LinkedList<int[]>();
    // 将所有的 0 添加进初始队列中
    for (int i = 0; i < m; ++i) {
      for (int j = 0; j < n; ++j) {
        if (matrix[i][j] == 0) {
          queue.offer(new int[]{i, j});
          seen[i][j] = true;
        }
      }
    }

    // 广度优先搜索
    while (!queue.isEmpty()) {
      int[] cell = queue.poll();
      int i = cell[0], j = cell[1];
      for (int d = 0; d < 4; ++d) {
        // 向四个方向搜索
        int ni = i + dirs[d][0];
        int nj = j + dirs[d][1];
        // 若不超过边界以及不为 0
        if (ni >= 0 && ni < m && nj >= 0 && nj < n && !seen[ni][nj]) {
          dist[ni][nj] = dist[i][j] + 1;
          queue.offer(new int[]{ni, nj});
          seen[ni][nj] = true;
        }
      }
    }

    return dist;
  }
}
复杂度分析
- 时间复杂度:O(mn),其中 m 为矩阵行数,n 为矩阵列数,即矩阵元素个数。广度优先搜索中每个位置最多只会被加入队列一次,因此只需要 O(mn) 的时间复杂度。
- 空间复杂度:O(mn),其中 m 为矩阵行数,n 为矩阵列数,即矩阵元素个数。除答案数组外,最坏情况下矩阵里所有元素都为 0,全部被加入队列中,此时需要 O(mn) 的空间复杂度。
LC 钥匙和房间
有 n 个房间,房间从 0 到 n-1 编号。最初,除 0 号房间外的其余所有房间都被锁住。你的目标是进入所有的房间。然而,你不能在没有获得钥匙的时候进入锁住的房间。
当你进入一个房间,你可能会在里面找到一套不同的钥匙,每把钥匙上都有对应的房间号,即表示钥匙可以打开的房间。你可以拿上所有的钥匙去解锁其他房间。
给你一个数组 rooms 其中 rooms[i] 是你进入 [i] 号房间可以获得的钥匙集合。如果能进入 所有 房间返回 true,否则返回 false。
示例 1:
输入:rooms = [[1],[2],[3],[]]
输出:true
解释:
我们从 0 号房间开始,拿到钥匙 1。
之后我们去 1 号房间,拿到钥匙 2。
然后我们去 2 号房间,拿到钥匙 3。
最后我们去了 3 号房间。
由于我们能够进入每个房间,我们返回 true。
示例 2:
输入:rooms = [[1,3],[3,0,1],[2],[0]]
输出:false
解释:我们不能进入 2 号房间。提示:
n == rooms.length2 <= n <= 10000 <= rooms[i].length <= 10001 <= sum(rooms[i].length) <= 30000 <=rooms[i][j] < n- 所有
rooms[i]的值 互不相同
题解
class Solution {
    boolean[] vis;
    int num;

    public boolean canVisitAllRooms(List<List<Integer>> rooms) {
        int n = rooms.size();
        num = 0;
        vis = new boolean[n];
        dfs(rooms, 0);
        return num == n;
    }

    public void dfs(List<List<Integer>> rooms, int x) {
        vis[x] = true;
        num++;
        for (int it : rooms.get(x)) {
            if (!vis[it]) {
                dfs(rooms,it);
            }
        }
    }
}
复杂度分析
- 时间复杂度:O(m+n),其中 n 是房间的数量,m 是所有房间中钥匙数量的总数。
- 空间复杂度:O(n),其中 n 是房间的数量。主要为栈空间的开销
