共计 20933 个字符,预计需要花费 53 分钟才能阅读完成。
概述
树 是一种经常用到的数据结构,用来模拟具有树状结构性质的数据集合。
数里的每一个节点有一个值和一个包含所有子节点的列表。从图的观点来看,树也可视为一个拥有 N 个节点 和 N - 1 条边 的一个有向无环图。
二叉树 是一种更为典型的树状结构。如它名字所描述的那样,二叉树是每个节点最多有 两个子树 的树结构,通常子树被称作 “左子树” 和 “右子树”。
完成后,你将:
- 掌握
树和二叉树的概念。 - 熟悉不同的
遍历方法。 - 运用
递归解决二叉树相关题目。
树的遍历
在上节的介绍中,相信大家已经熟知了树和二叉树的基本概念。
本章节,我们把重点放在介绍二叉树中几种常见的遍历方法。掌握这几种遍历方法,会加深你对树这个数据结构的理解,并为以后的学习打下扎实的基础。
本章目标:
- 理解和区分树的遍历方法
- 能够运用
递归方法解决树的前序遍历、中序遍历和后序遍历问题 - 能够运用
迭代方法解决树的前序遍历、中序遍历和后序遍历问题 - 能够运用
广度优先搜索解决树的层序遍历问题
A 树的遍历 – 介绍
前序遍历
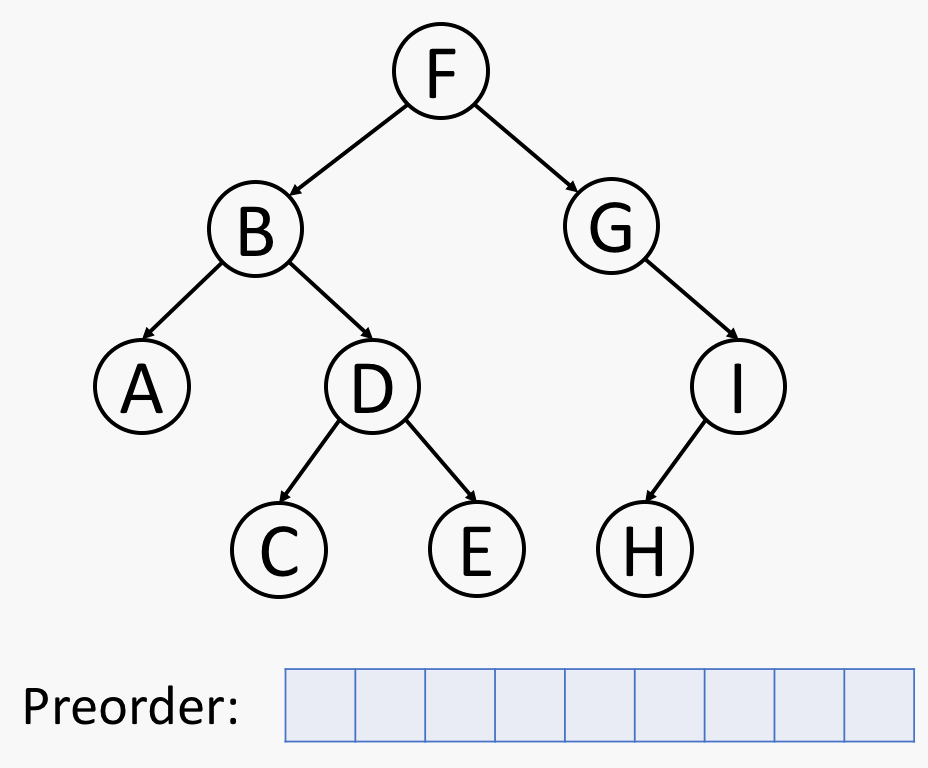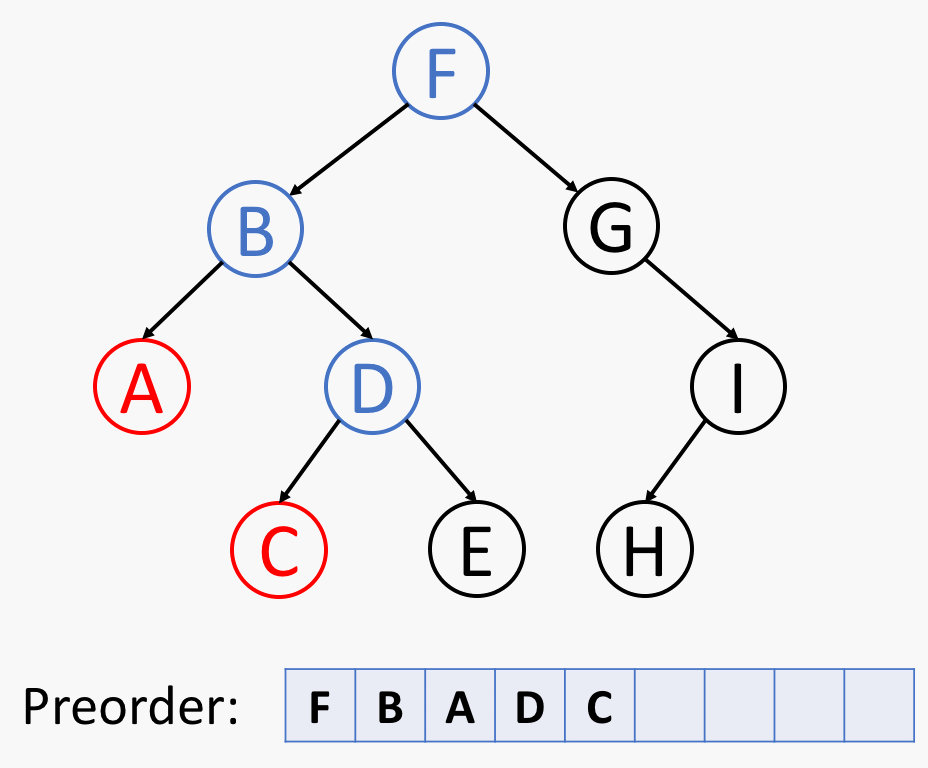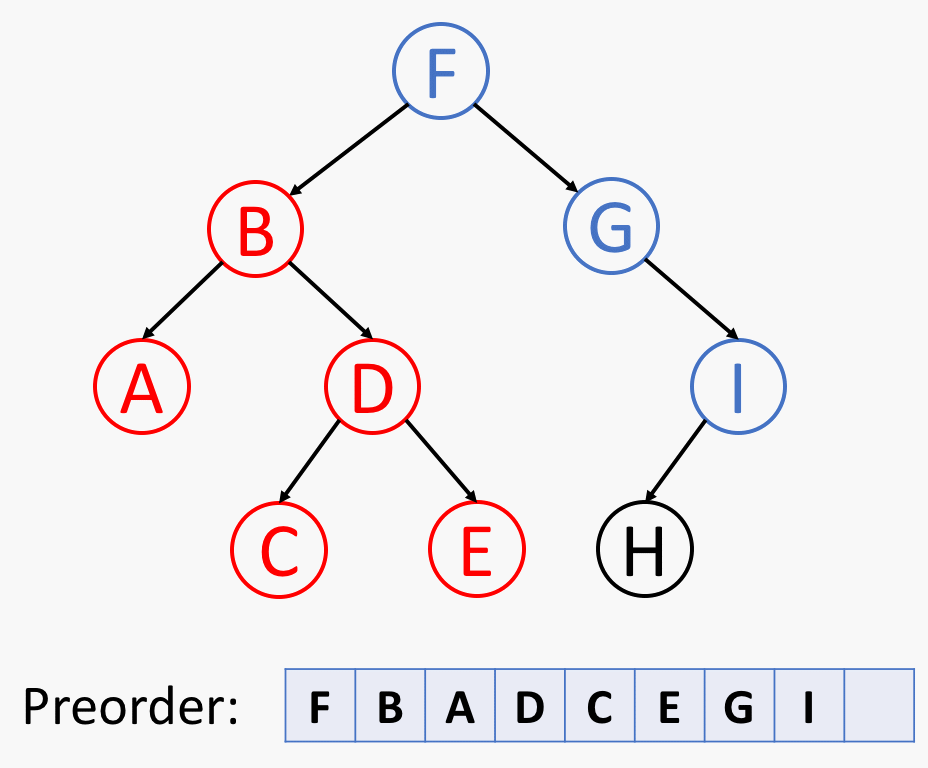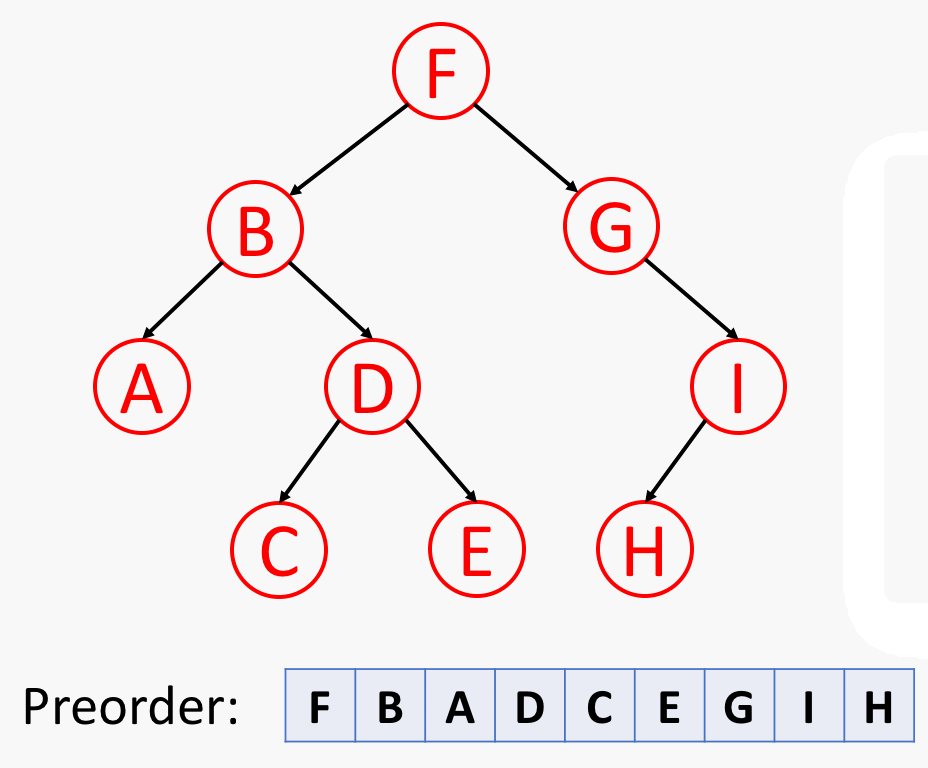
前序遍历首先访问根节点,然后遍历左子树,最后遍历右子树。
请看下面的例子:
中序遍历
中序遍历是先遍历左子树,然后访问根节点,然后遍历右子树。
请看下面的例子:
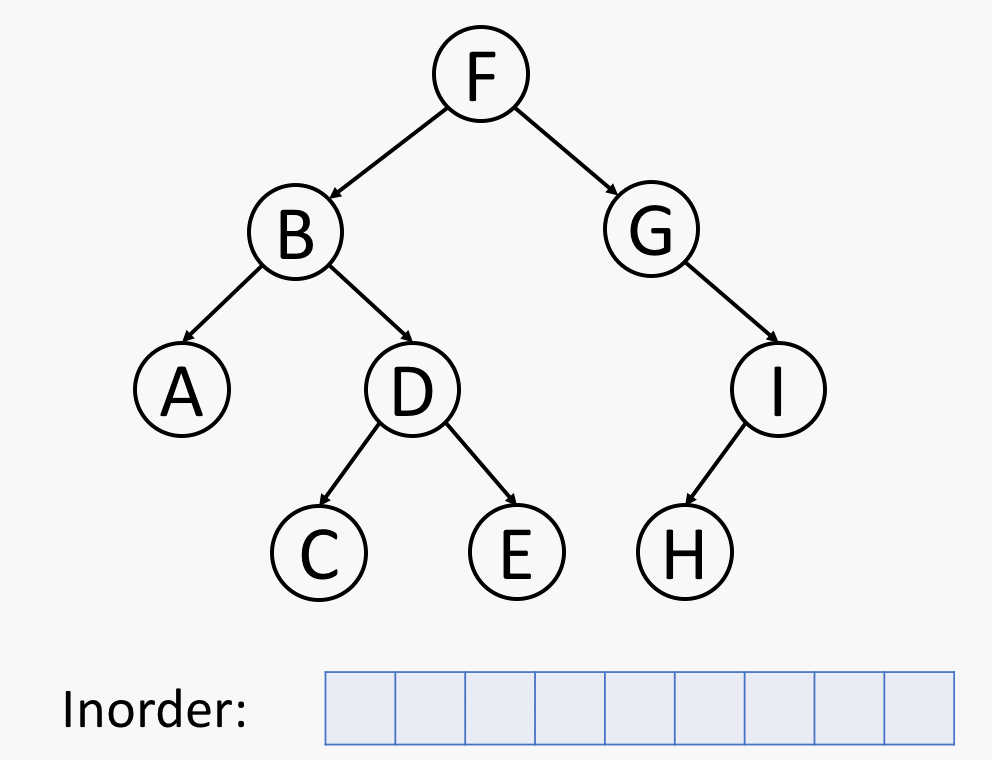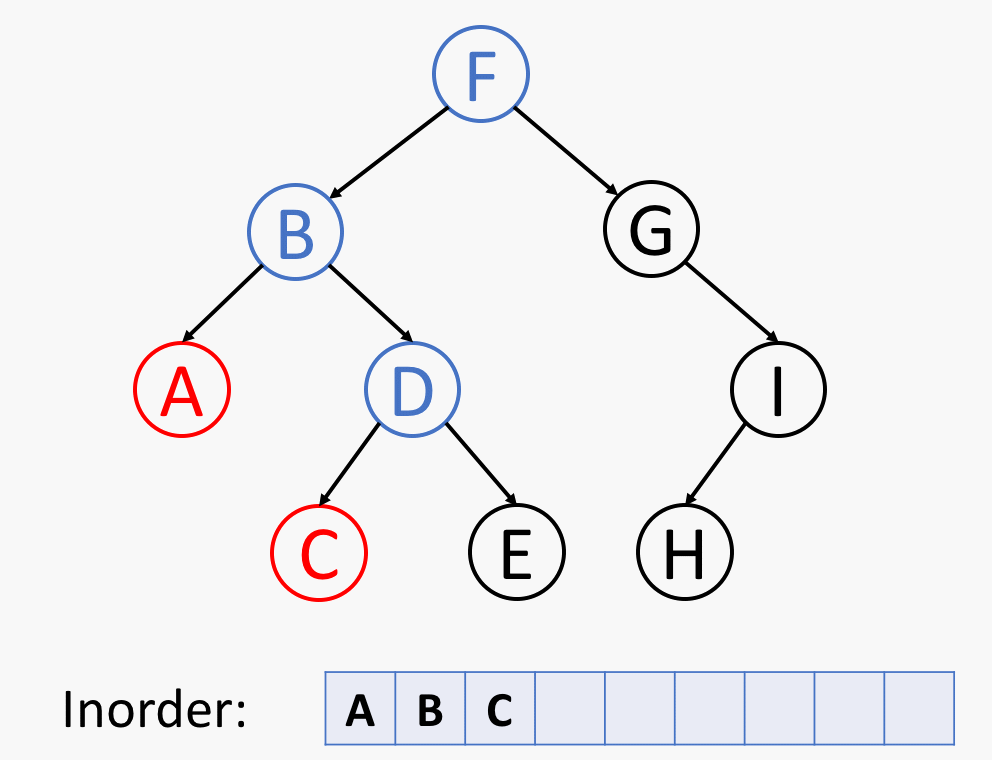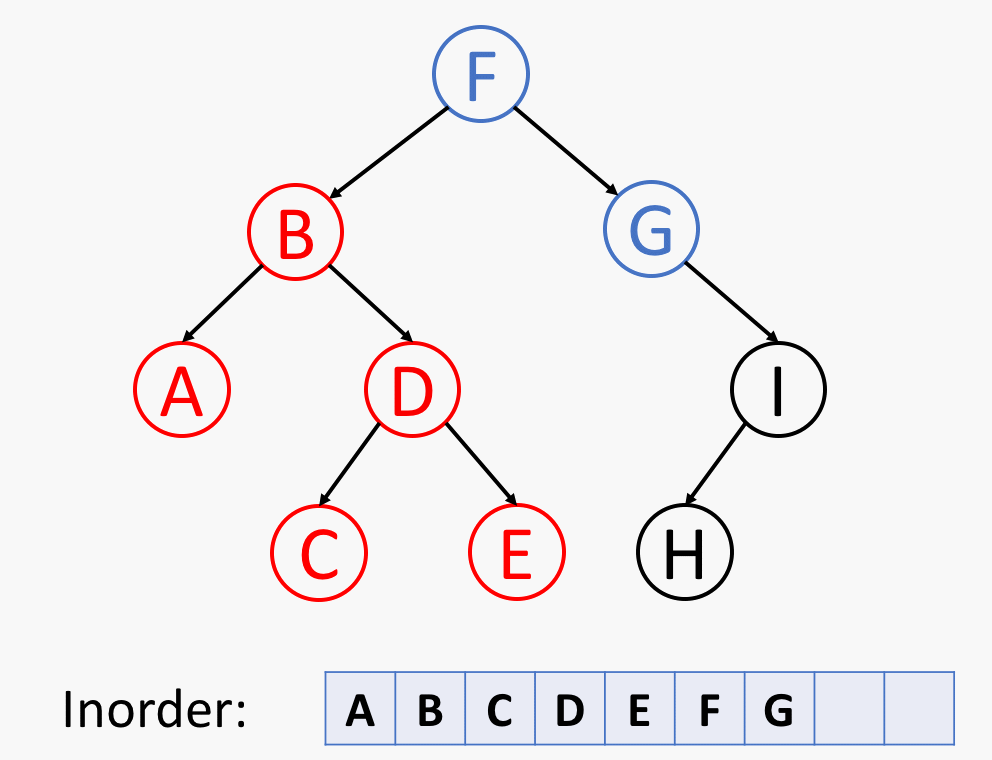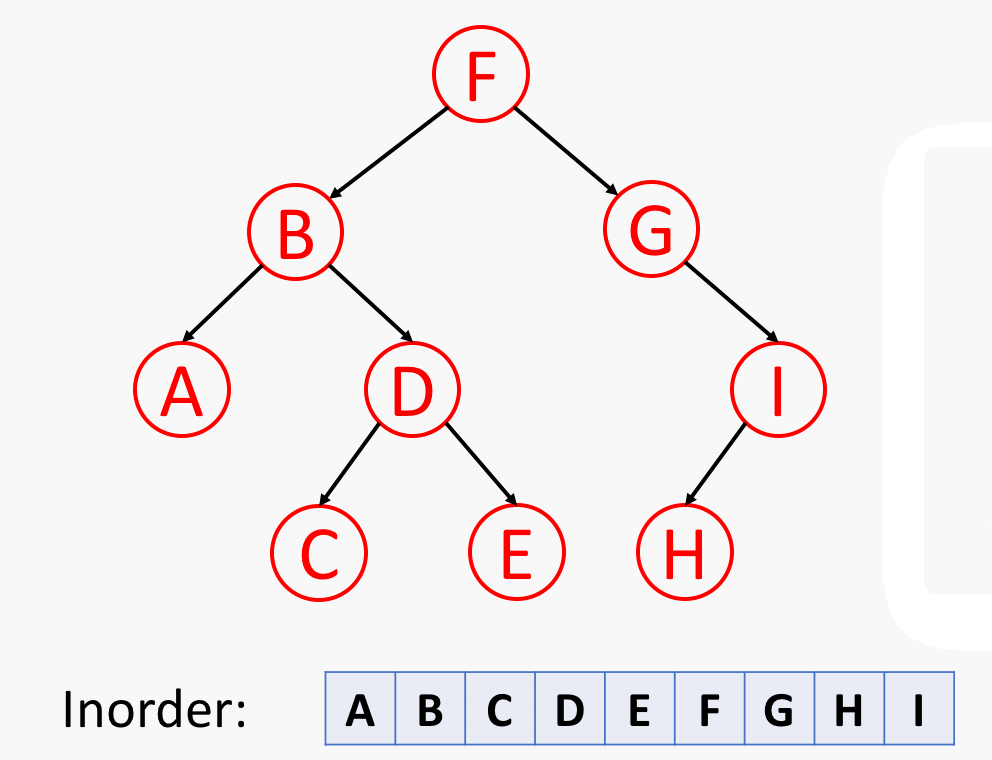
通常来说,对于二叉搜索树,我们可以通过中序遍历得到一个递增的有序序列。我们将在另一张卡片(数据结构介绍 – 二叉搜素数)中再次提及。
后序遍历
后序遍历是先遍历左子树,然后遍历右子树,最后访问树的根节点。
请看下面的例子:
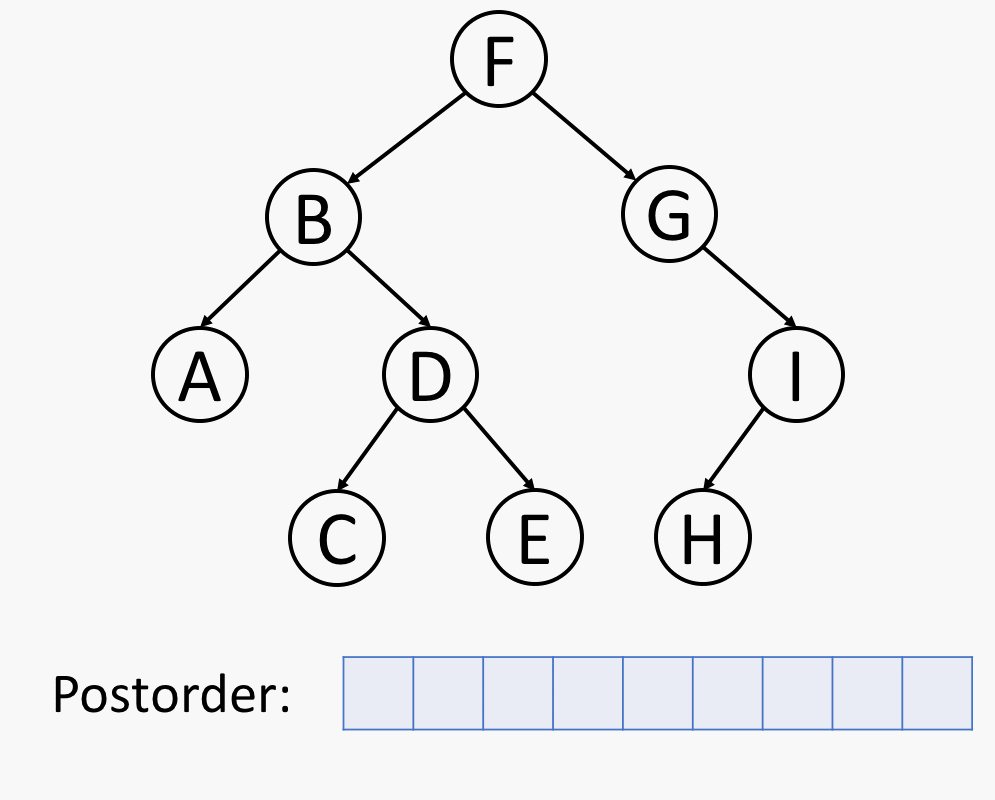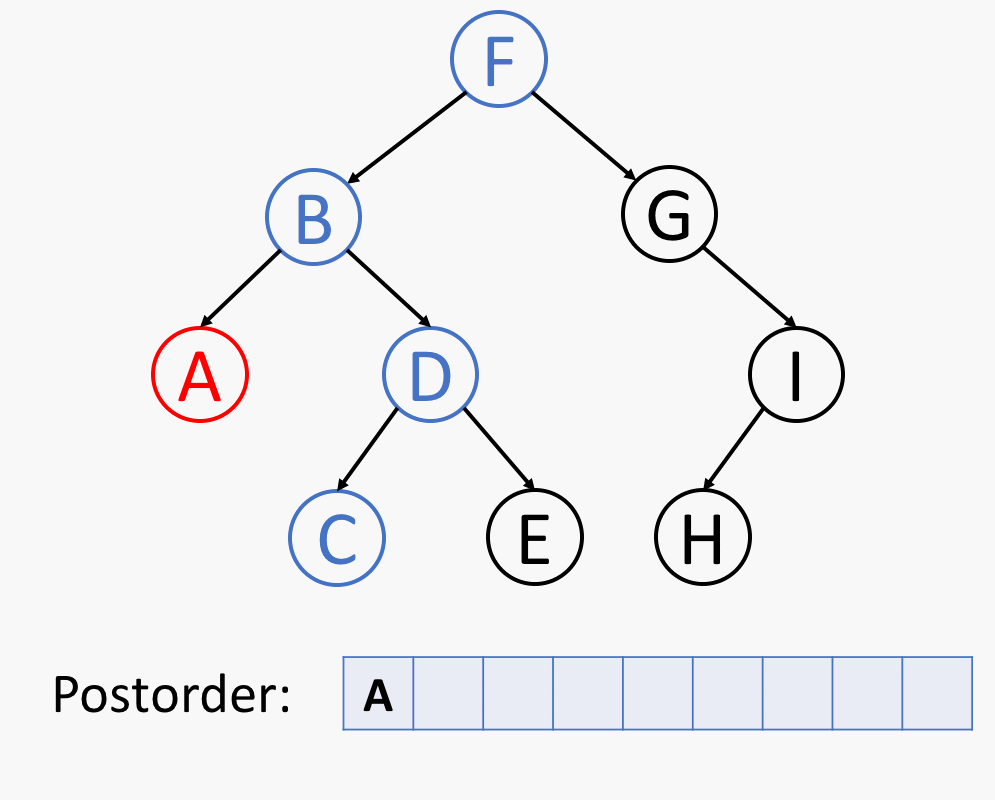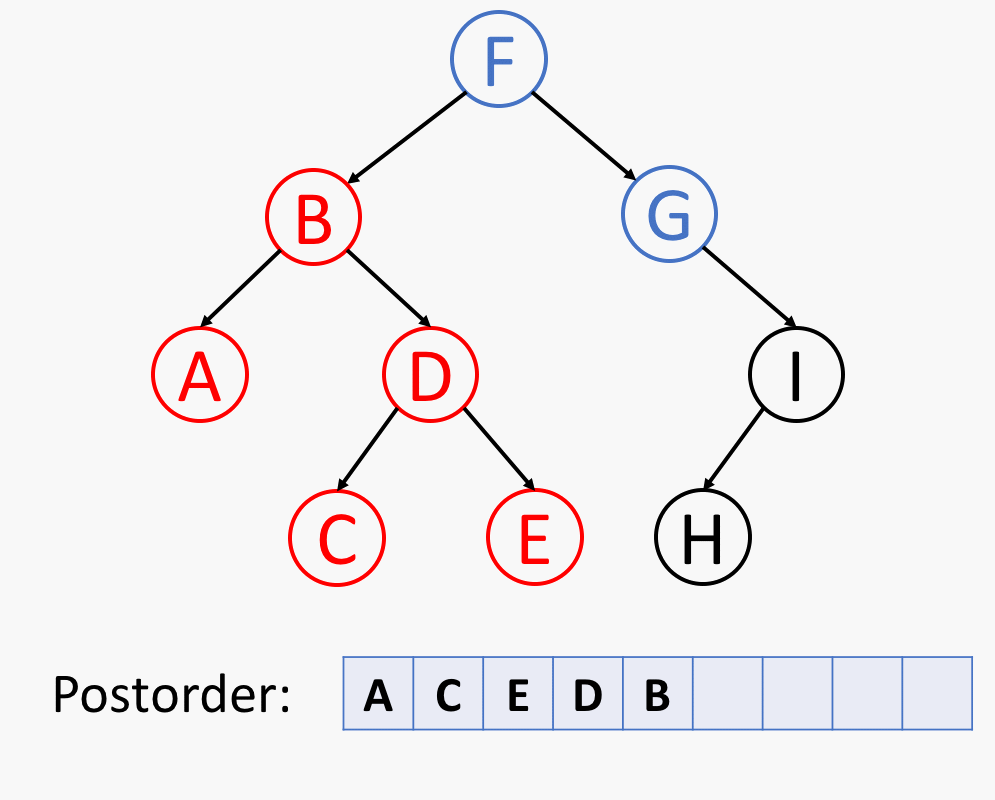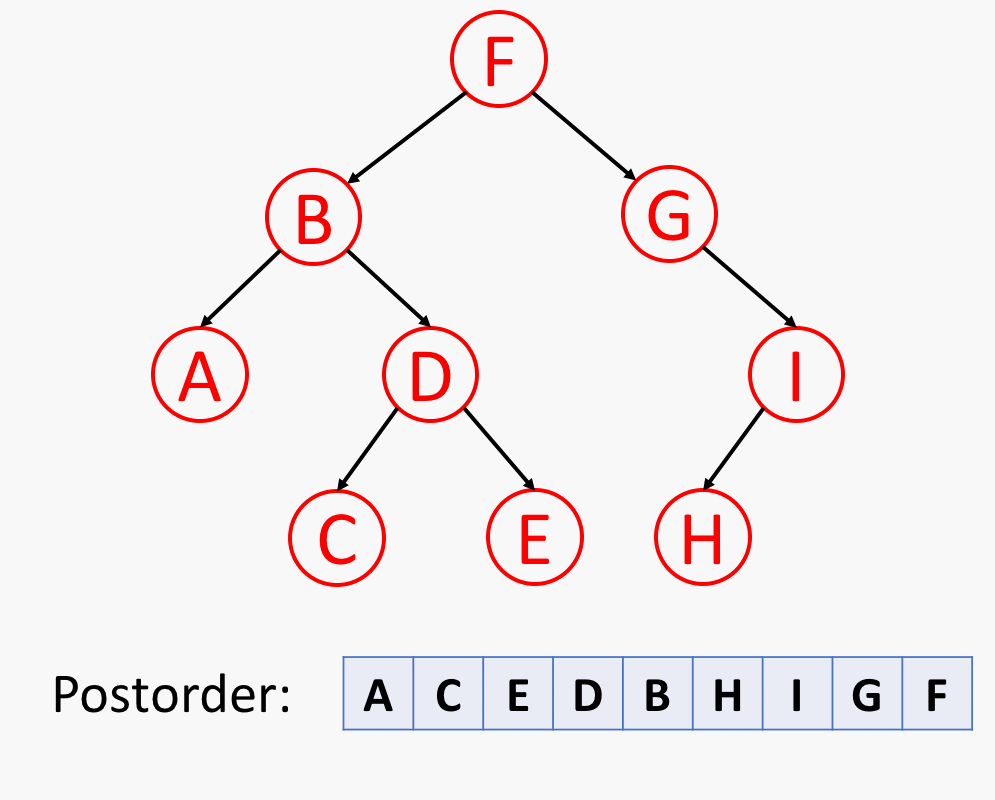
值得注意的是,当你删除树中的节点时,删除过程将按照后序遍历的顺序进行。也就是说,当你删除一个节点时,你将首先删除它的左节点和它的右边的节点,然后再删除节点本身。
另外,后序在数学表达中被广泛使用。编写程序来解析后缀表示法更为容易。这里是一个例子:
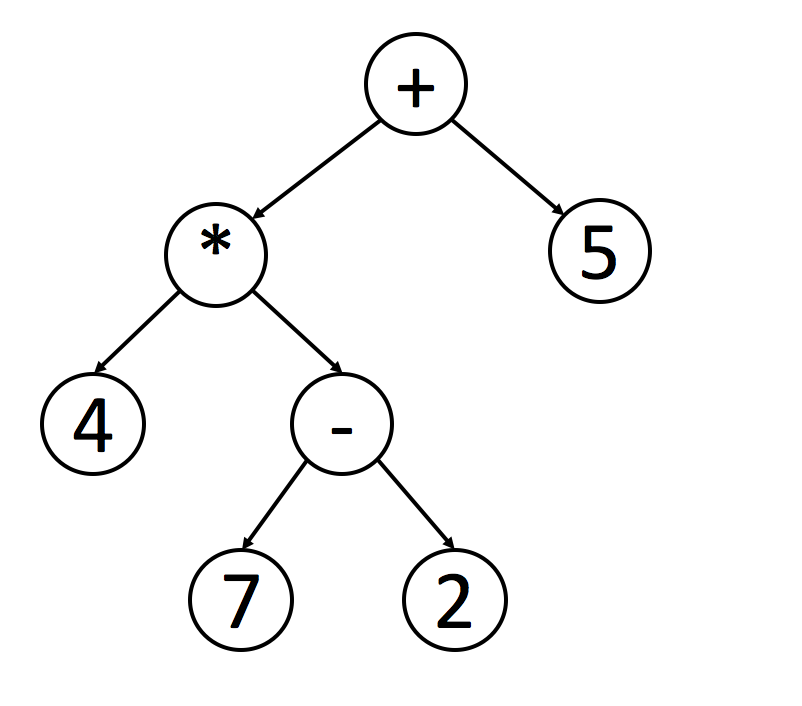
您可以使用中序遍历轻松找出原始表达式。但是程序处理这个表达式时并不容易,因为你必须检查操作的优先级。
如果你想对这棵树进行后序遍历,使用栈来处理表达式会变得更加容易。每遇到一个操作符,就可以从栈中弹出栈頂的两个元素,计算并将结果返回到栈中。
递归和迭代
练习文章后面习题中的三种遍历方法。你可以通过递归或迭代方法实现算法,并比较它们之间的差异。
LC 二叉树的前序遍历
给你二叉树的根节点 root,返回它节点值的 前序 遍历。
示例 1:
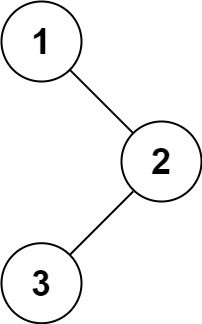
 输入:root = [1,null,2,3]
 输出:[1,2,3]
示例 2:
 输入:root = []
 输出:[]
示例 3:
 输入:root = [1]
 输出:[1]
示例 4:
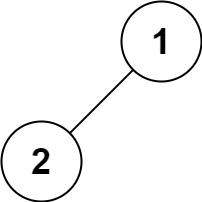
 输入:root = [1,2]
 输出:[1,2]
示例 5:
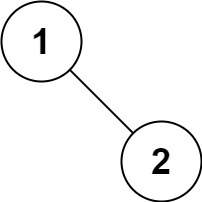
 输入:root = [1,null,2]
输出:[1,2]提示:
- 树中节点数目在范围
[0, 100]内 -100 <= Node.val <= 100
进阶:你可以通过迭代算法完成吗?
题解
方法一:递归
class Solution {
public List<Integer> preorderTraversal(TreeNode root) {
List<Integer> res = new ArrayList<Integer>();
preorder(root, res);
return res;
}
public void preorder(TreeNode root, List<Integer> res) {
if (root == null) {
return;
}
res.add(root.val);
preorder(root.left, res);
preorder(root.right, res);
}
}复杂度分析
- 时间复杂度:O(n) ,其中 n 是二叉树的节点数。每一个节点恰好被遍历一次。
- 空间复杂度:O(n),为递归过程中栈的开销,平均情况下为 O(logn),最坏情况下树呈现链状,为 O(n)。
方法二:迭代
查看题解
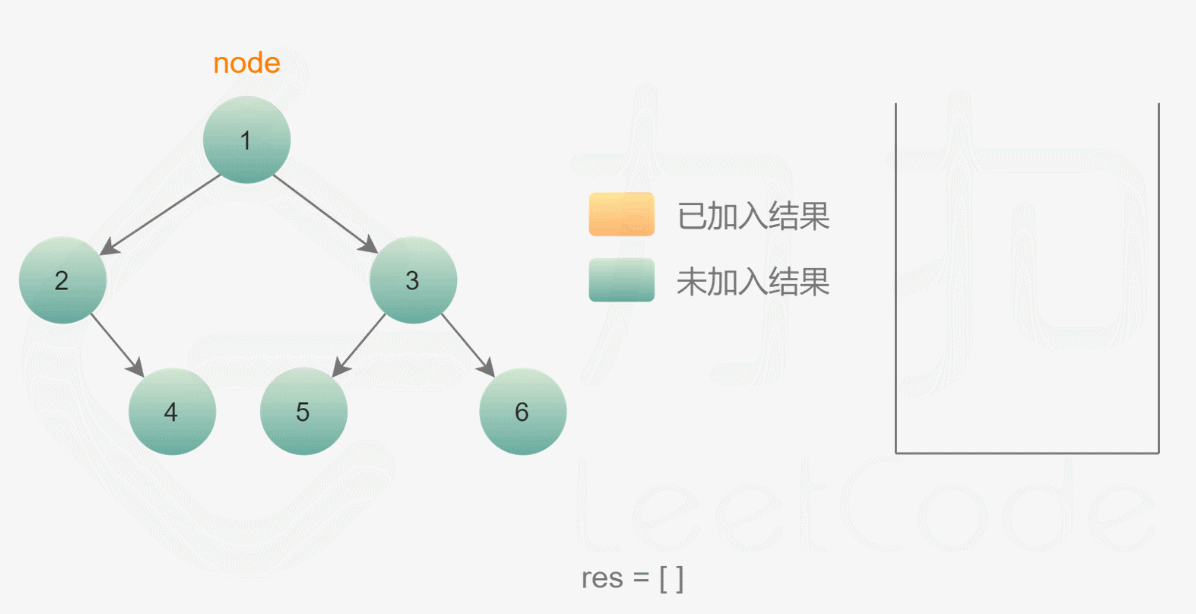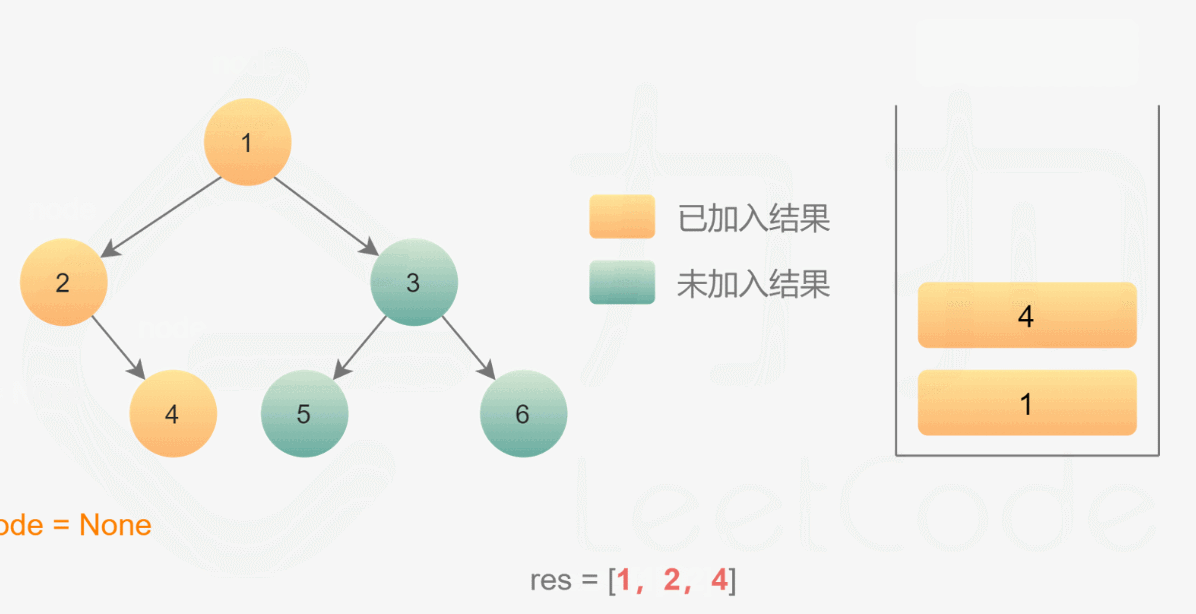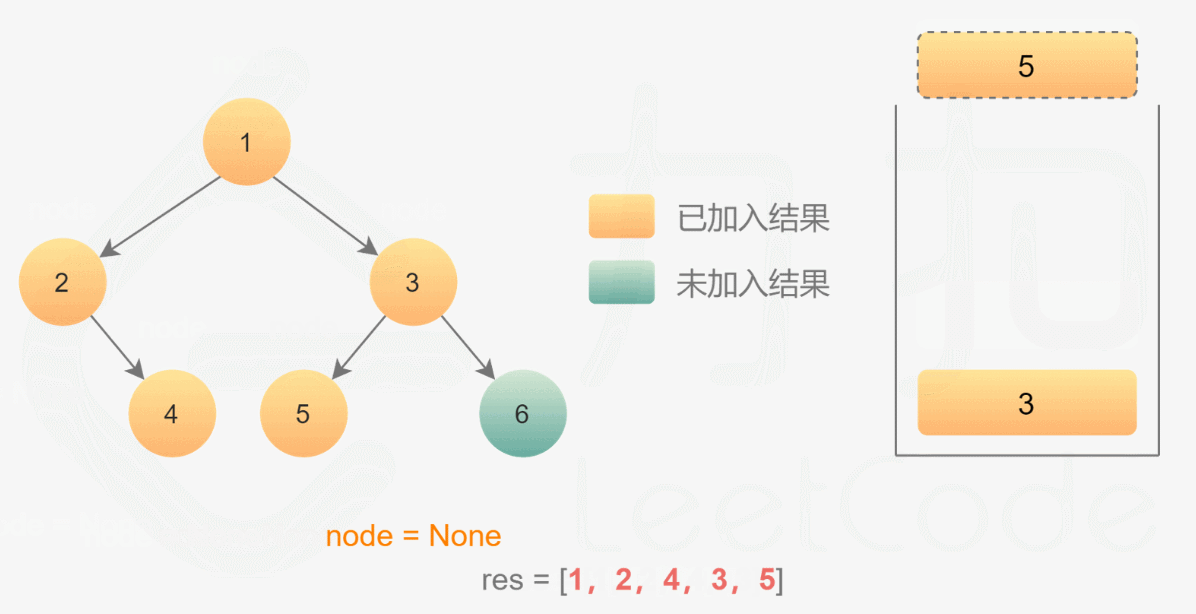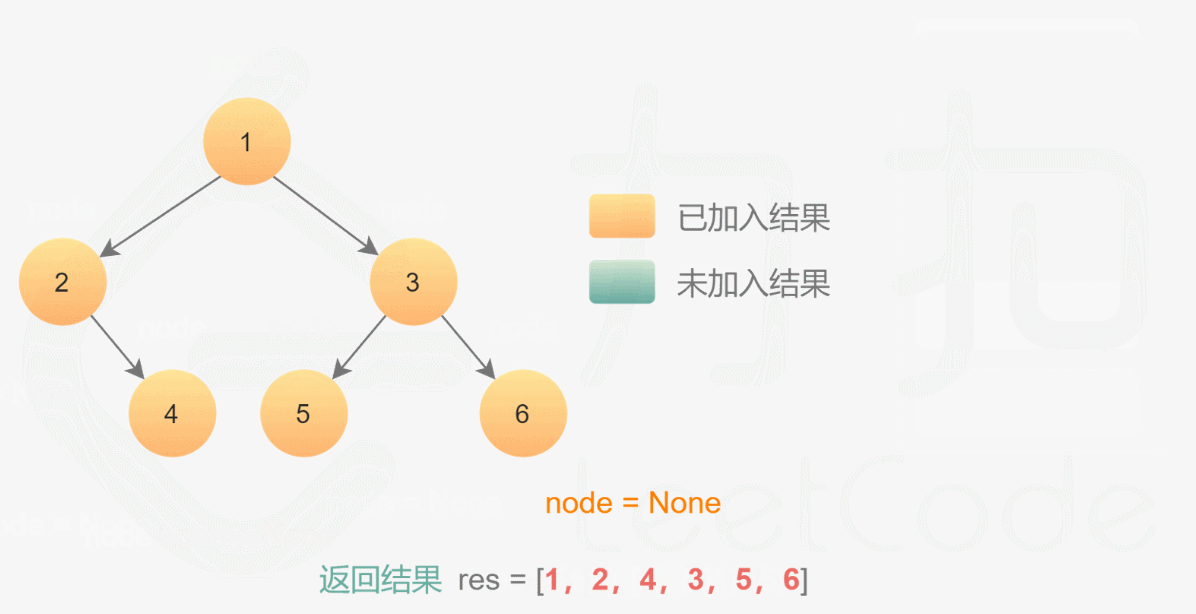
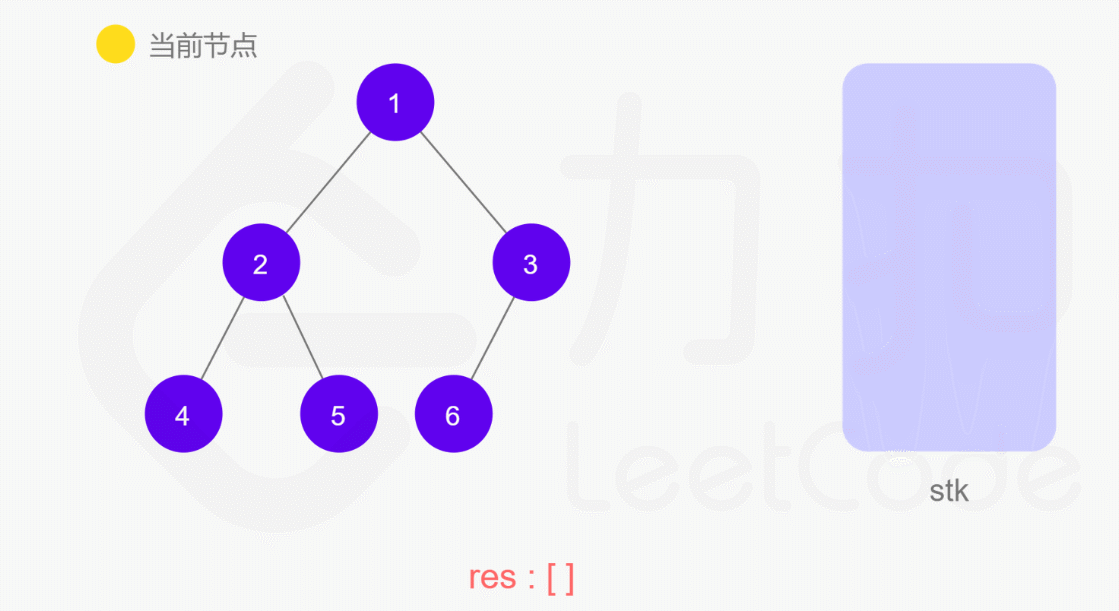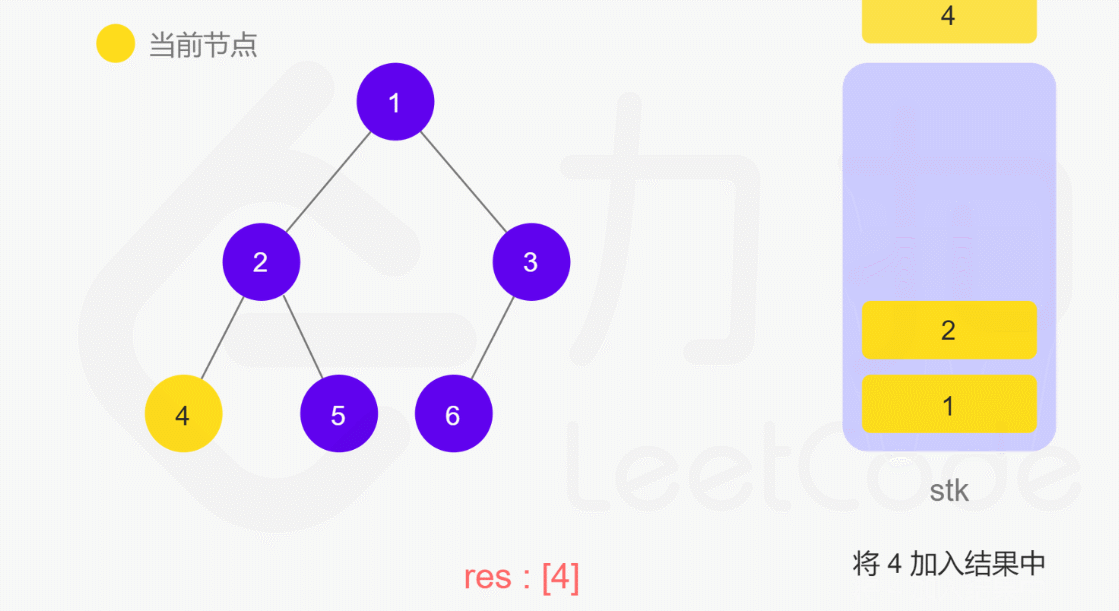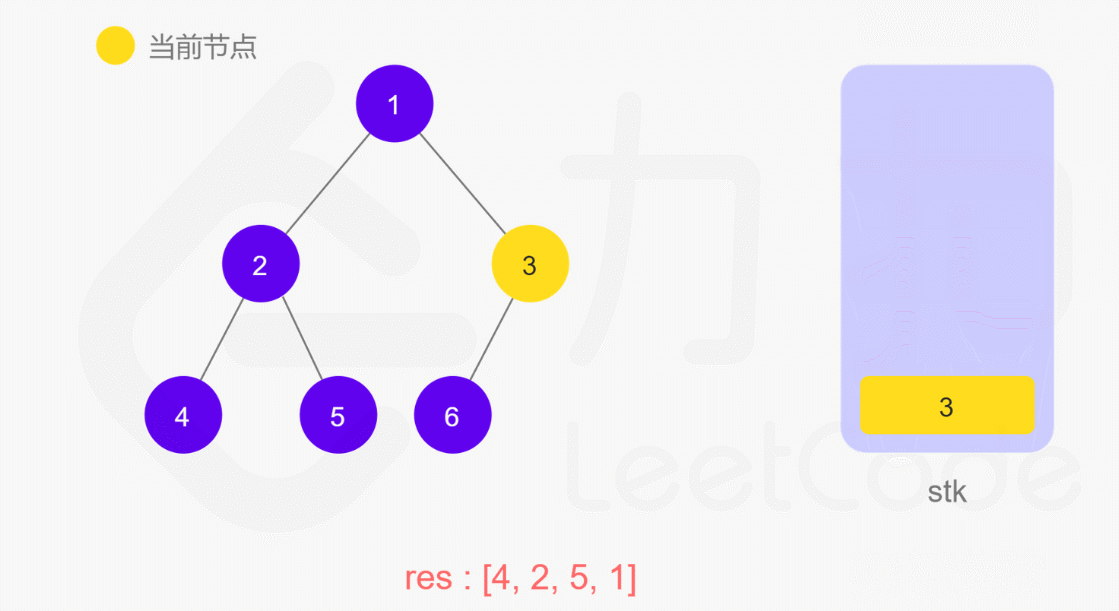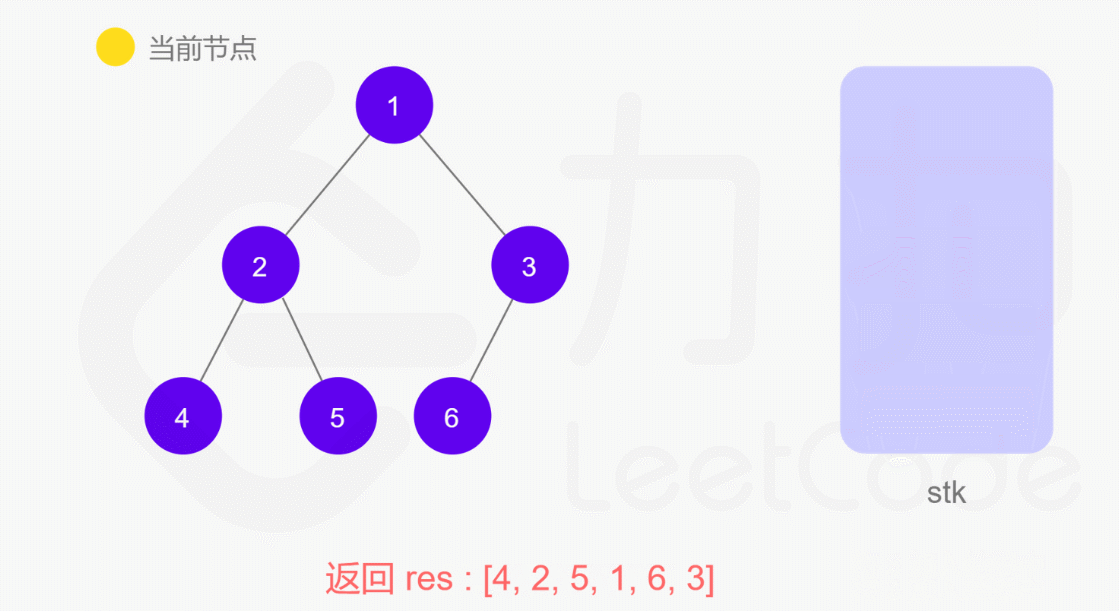
我们也可以用迭代的方式实现方法一的递归函数,两种方式是等价的,区别在于递归的时候隐式的维护了一个栈,而我们在迭代的时候需要显示的将这个栈模拟出来,其余的实现与细节都相同,具体可以参考下面。
 /**
  * Definition for a binary tree node.
  * public class TreeNode {
  *     int val;
  *     TreeNode left;
  *     TreeNode right;
  *     TreeNode() {}
  *     TreeNode(int val) { this.val = val; }
  *     TreeNode(int val, TreeNode left, TreeNode right) {
  *         this.val = val;
  *         this.left = left;
  *         this.right = right;
  *     }
  * }
  */
 class Solution {
     public List<Integer> preorderTraversal(TreeNode root) {
       List<Integer> res = new ArrayList<Integer>();
       if (root == null) {
         return res;
       }
       Deque<TreeNode> stack = new LinkedList<TreeNode>();
       TreeNode node = root;
       while (!stack.isEmpty() || node != null) {
         while (node != null) {
           res.add(node.val);
           stack.push(node);
           node = node.left;
         }
         node = stack.pop();
         node = node.right;
       }
       return res;
     }
 }
复杂度分析
- 时间复杂度:O(n),其中 n 是二叉树的节点数。每一个节点恰好被遍历一次。
- 空间复杂度:O(n),为迭代过程中显示栈的开销,平均情况下为 O(logn),最坏情况下树呈现链状,为 O(n)。
LC 二叉树的中序遍历
给定一个二叉树的根节点 root,返回它的 中序 遍历。
示例 1:
 输入:root = [1,null,2,3]
 输出:[1,3,2]
示例 2:
输入:root = []
输出:[]
示例 3:
输入:root = [1]
输出:[1]提示:
- 树中节点数目在范围
[0, 100]内。 -100 <= Node.val <= 100
进阶:你可以通过迭代算法完成吗?
题解
方法一:递归
class Solution {
    public List<Integer> inorderTraversal(TreeNode root) {
        List<Integer> res = new ArrayList<Integer>();
        inorder(root, res);
        return res;
    }

    public void inorder(TreeNode root, List<Integer> res) {
        if (root == null) {
            return;
        }
        inorder(root.left, res);
        res.add(root.val);
        inorder(root.right, res);
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 为二叉树节点的个数。二叉树的遍历中每个节点会被访问一次且只会被访问一次。
- 空间复杂度:O(n)。空间复杂度取决于递归的栈深度,而栈深度在二叉树为一条链的情况下会达到 O(n) 的级别。
方法二:迭代
查看题解
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    public List<Integer> inorderTraversal(TreeNode root) {
      List<Integer> res = new LinkedList<Integer>();
      if (root == null) {
        return res;
      }
      Deque<TreeNode> stack = new LinkedList<TreeNode>();
      while (root != null || !stack.isEmpty()) {
        while (root != null) {
          stack.push(root);
          root = root.left;
        }
        root = stack.pop();
        res.add(root.val);
        root = root.right;
      }
      return res;
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 为二叉树节点的个数。二叉树的遍历中每个节点会被访问一次且只会被访问一次。
- 空间复杂度:O(n)。空间复杂度取决于栈深度,而栈深度在二叉树为一条链的情况下会达到 O(n) 的级别。
LC 二叉树的后序遍历
给你一颗二叉树的根节点 root,返回其节点值的 后序遍历。
示例 1:
输入:root = [1,null,2,3]
输出:[3,2,1]
示例 2:
输入:root = []
输出:[]
示例 3:
输入:root = [1]
输出:[1]提示:
- 树中节点的数目在范围
[0, 100]内 -100 <= Node.val <= 100
题解
方法一:递归
class Solution {
    public List<Integer> postorderTraversal(TreeNode root) {
        List<Integer> res = new ArrayList<Integer>();
        postorder(root, res);
        return res;
    }

    public void postorder(TreeNode root, List<Integer> res) {
        if (root == null) {
            return;
        }
        postorder(root.left, res);
        postorder(root.right, res);
        res.add(root.val);
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 是二叉搜索树的节点数。每一个节点恰好被遍历一次。
- 空间复杂度:O(n),为递归过程中栈的开销,平均情况下为 O(logn),最坏情况下树呈链状,为 O(n)。
方法二:迭代
查看题解
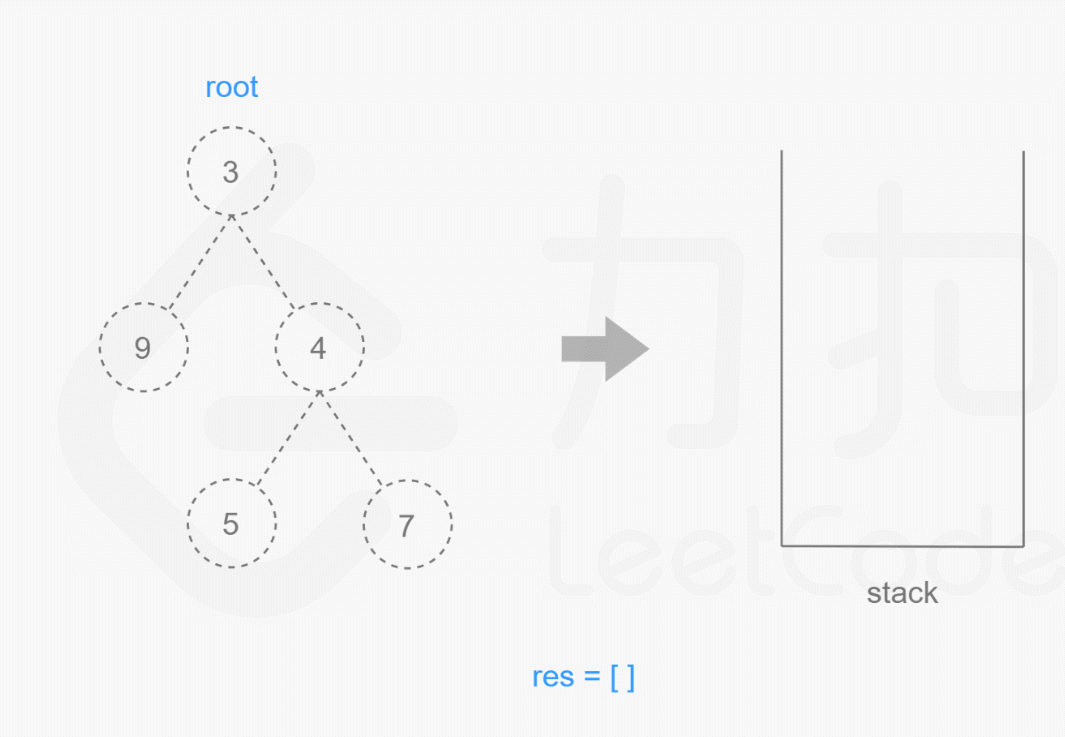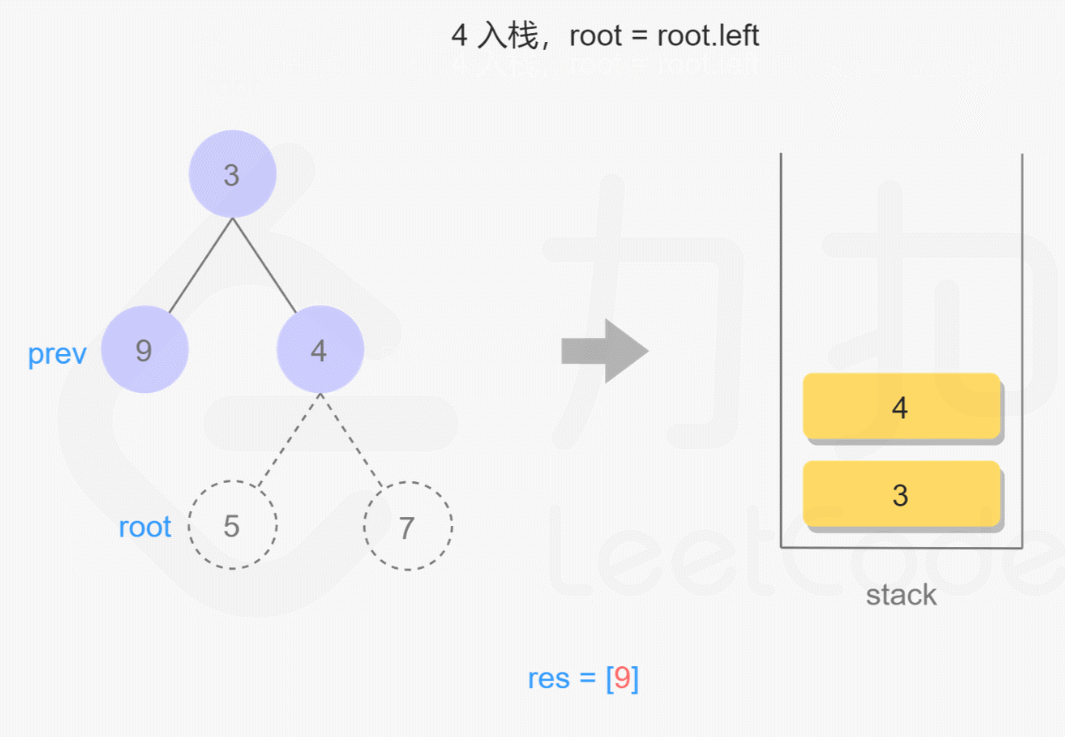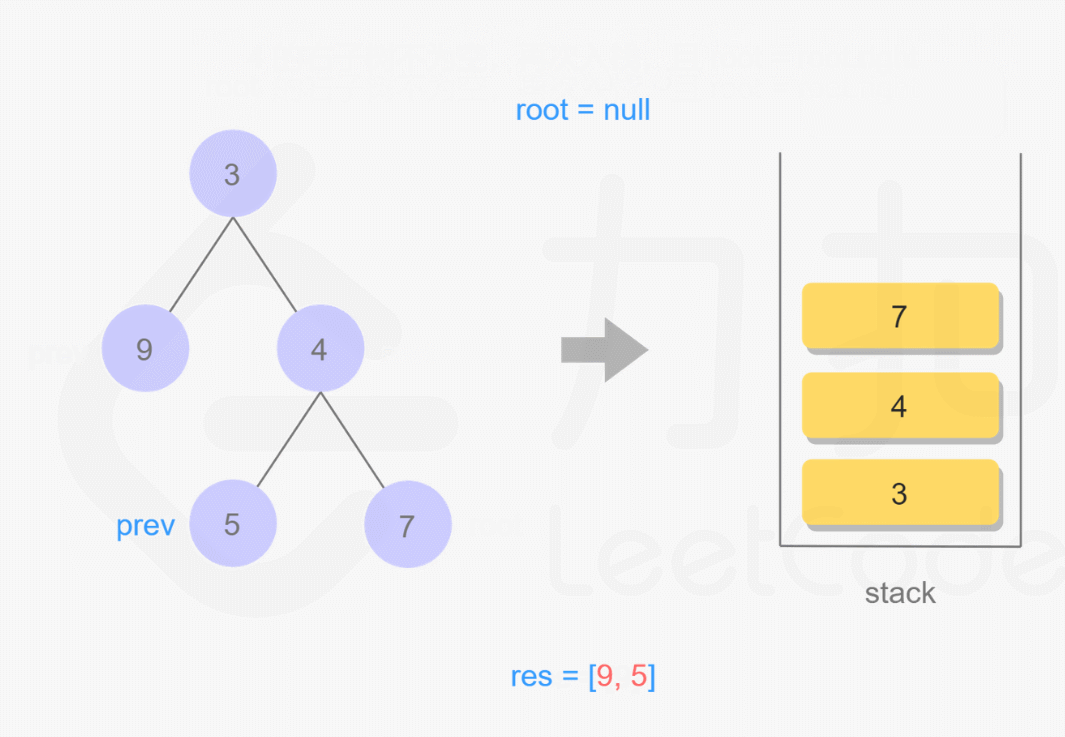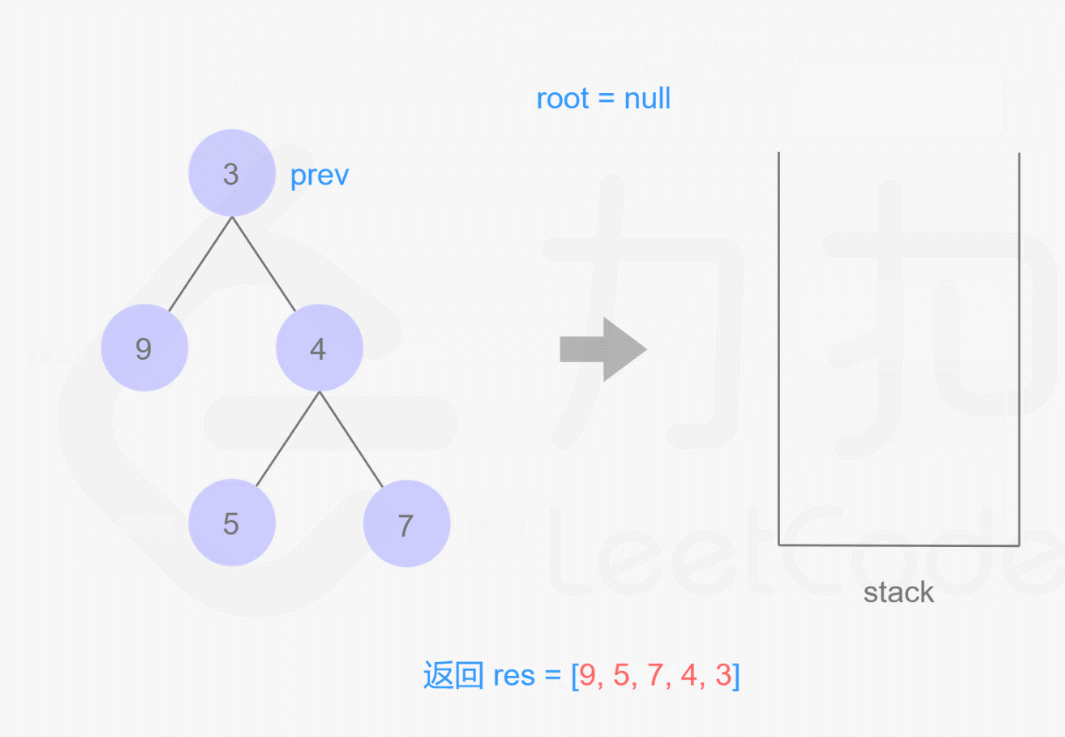
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    public List<Integer> postorderTraversal(TreeNode root) {
      List<Integer> res = new LinkedList<Integer>();
      if (root == null) {
        return res;
      }
      Deque<TreeNode> stack = new LinkedList<TreeNode>();
      TreeNode prev = null;
      while (root != null || !stack.isEmpty()) {
        while (root != null) {
          stack.push(root);
          root = root.left;
        }
        root = stack.peek();
        if (root.right != null && root.right != prev) {
          root = root.right;
        } else {
          stack.pop();
          res.add(root.val);
          prev = root;
          root = null;
        }
      }
      return res;
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 是二叉搜索树的节点数。每一个节点恰好被遍历一次。
- 空间复杂度:O(n),为迭代过程中的显式栈的开销,平均情况下为 O(logn),最坏情况下树呈现链状,为 O(n)。
A 层序遍历 – 介绍
层序遍历就是逐层遍历树结构。
广度优先搜索 是一种广泛运用在树或图这类数据结构中,遍历或搜索的算法。该算法从一个根节点,首先访问节点本身。然后遍历它的相邻节点,其次遍历它的二级邻节点、三级邻节点,以此类推。
当我们在树中进行广度优先搜索时,我们访问的节点顺序是按照层序遍历顺序的。
这是一个层序遍历的例子:
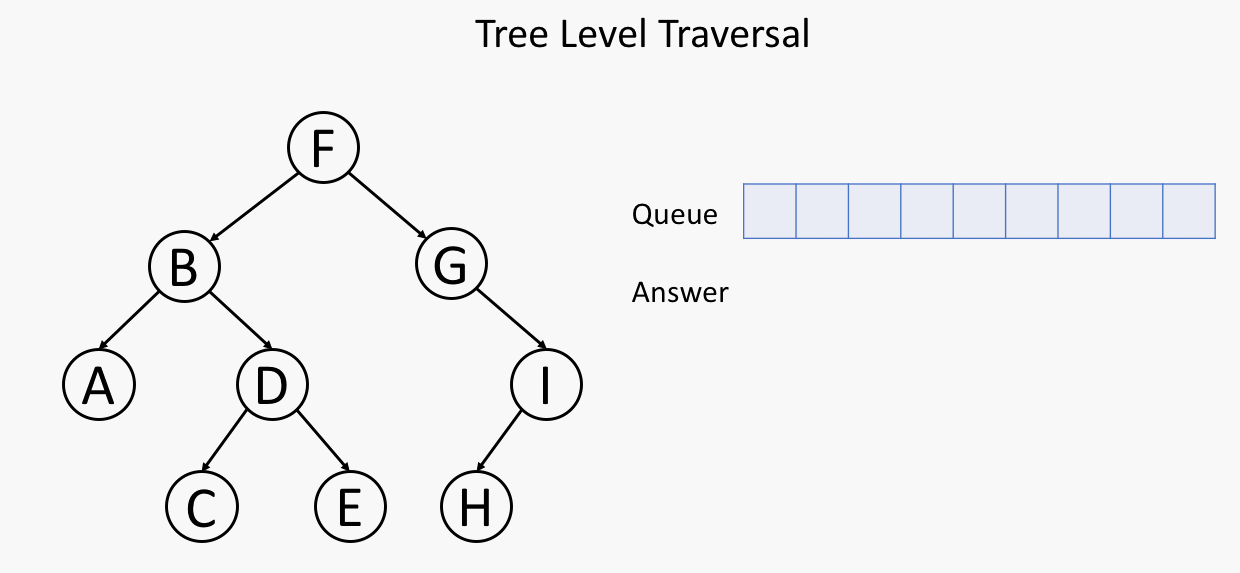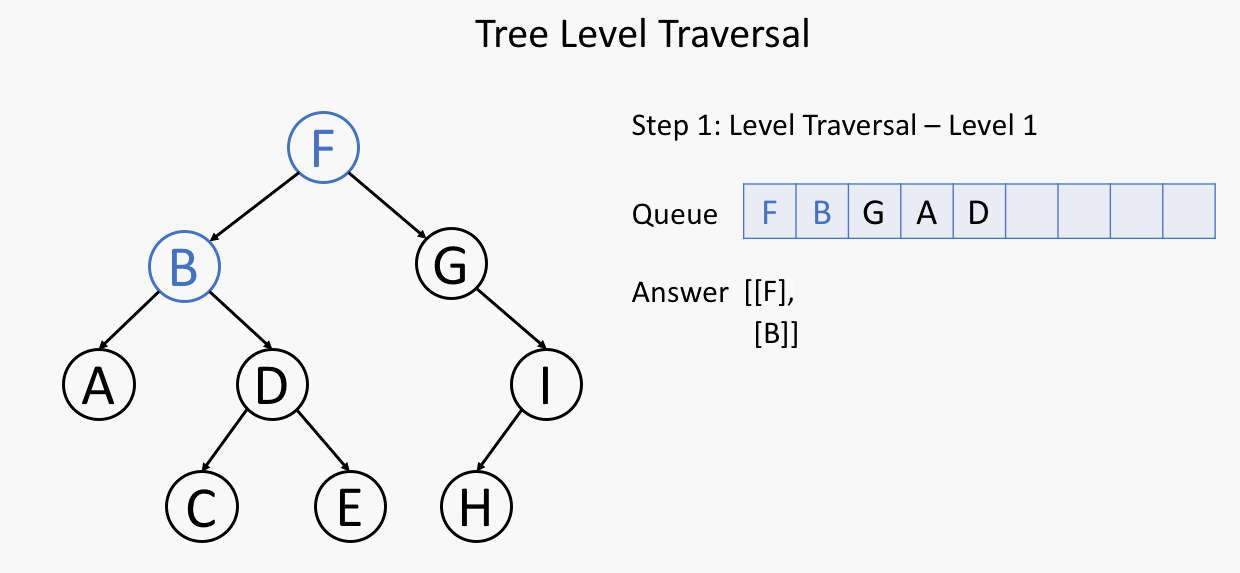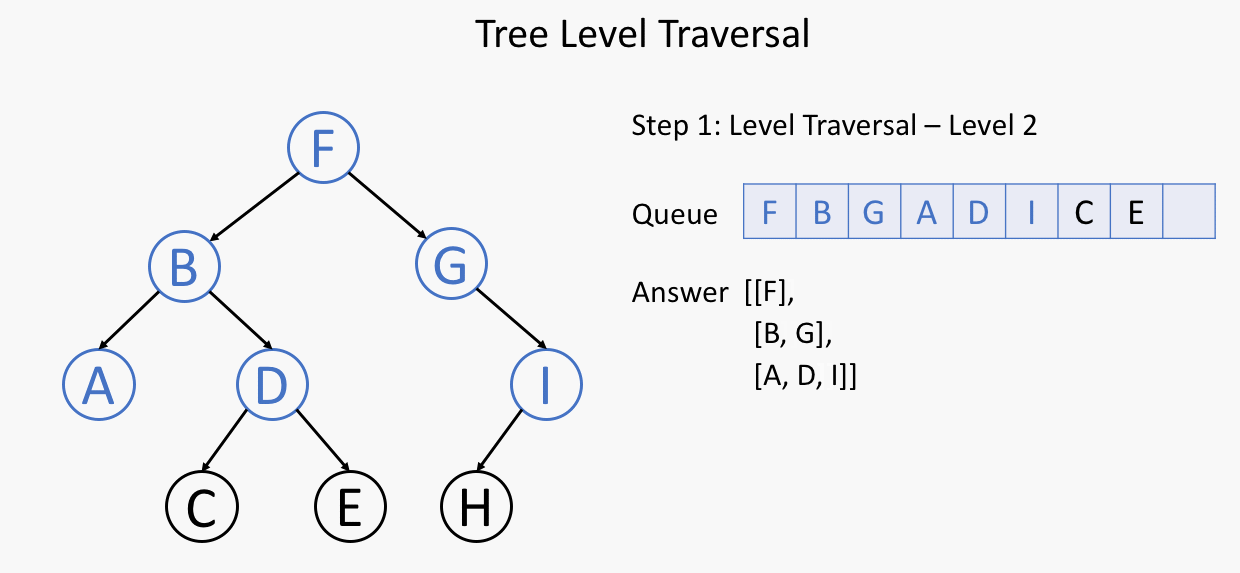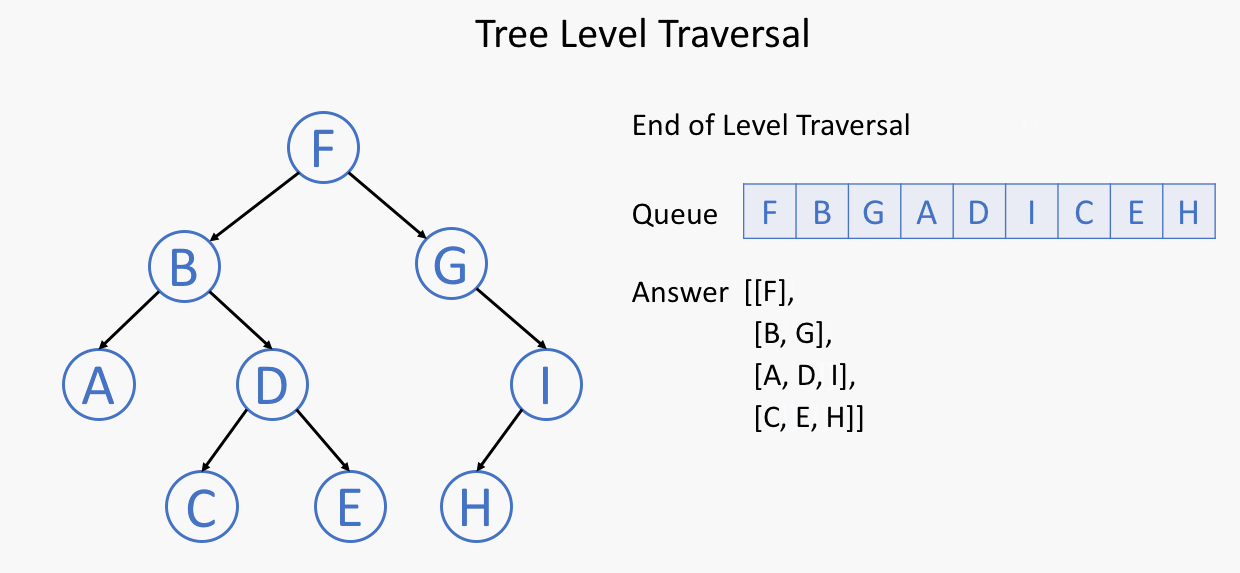
通常,我们使用一个叫做队列的数据结构来帮助我们做广度优先搜索。
LC 二叉树的层序遍历
给你二叉树的根节点 root,返回其节点值的 层序遍历。(即逐层地,从左到右访问所有节点)。
示例 1:
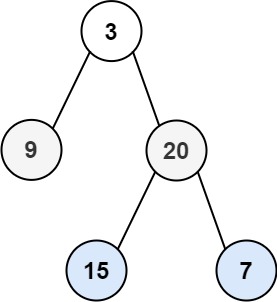
输入:root = [3,9,20,null,null,15,7]
输出:[[3],[9,20],[15,7]]
示例 2:
输入:root = [1]
输出:[[1]]
示例 3:
输入:root = []
输出:[]提示:
- 树中节点数目在范围
[0, 2000]内 - 1000 <= Node.val <= 1000
题解
public List<List<Integer>> levelOrder(TreeNode root) {
    //边界条件判断
    if (root == null)
        return new ArrayList<>();
    //队列
    Queue<TreeNode> queue = new LinkedList<>();
    List<List<Integer>> res = new ArrayList<>();
    //根节点入队
    queue.add(root);
    //如果队列不为空就继续循环
    while (!queue.isEmpty()) {
        //BFS打印,levelNum表示的是每层的结点数
        int levelNum = queue.size();
        //subList存储的是每层的结点值
        List<Integer> subList = new ArrayList<>();
        for (int i = 0; i < levelNum; i++) {
            //出队
            TreeNode node = queue.poll();
            subList.add(node.val);
            //左右子节点如果不为空就加入到队列中
            if (node.left != null)
                queue.add(node.left);
            if (node.right != null)
                queue.add(node.right);
        }
        //把每层的结点值存储在res中,
        res.add(subList);
    }
    return res;
}
运用递归解决问题
在之前的章节中,我们已经介绍了如何解决树的遍历问题。我们也已经尝试过使用递归解决树的前序、中序和后序遍历的问题。
事实上,递归 是解决树相关问题的最有效和最常用的方法之一。本节中,我们将会介绍两种典型的递归方法。完成本章节后,你将能够运用基础的递归方法,自主解决二叉树相关问题。
A 运用递归解决树的问题
在前面的章节中,我们已经介绍了如何利用递归求解树的遍历。递归是解决树的相关问题最有效和最常用的方法之一。
我们知道,树可以以递归的方式定义为一个节点(根节点),它包括一个值和一个指向其他节点指针的列表。递归是树的特性之一。因此,许多树问题可以通过递归的方式来解决。对于每个递归层级,我们只能关注单个节点内的问题,并通过递归调用函数来解决其子节点问题。
通常,我们可以通过 “自顶向下” 或 “自底向上” 的递归来解决树问题。
“自顶向下” 的解决方案
“自顶向下” 意味着在每个递归层级,我们将首先访问节点来计算一些值,并在递归调用函数时将这些值传递到子节点。所以 “自顶向下” 的解决方案可以被认为是一种 前序遍历。具体来说,递归函数 top_down(root, params) 的原理是这样的:
1. return specific value for null node
2. update the answer if needed                      // answer <-- params
3. left_ans = top_down(root.left, left_params)		// left_params <-- root.val, params
4. right_ans = top_down(root.right, right_params)	// right_params <-- root.val, params
5. return the answer if needed                      // answer <-- left_ans, right_ans
例如,思考这样一个问题:给定一个二叉树,请寻找它的最大深度。
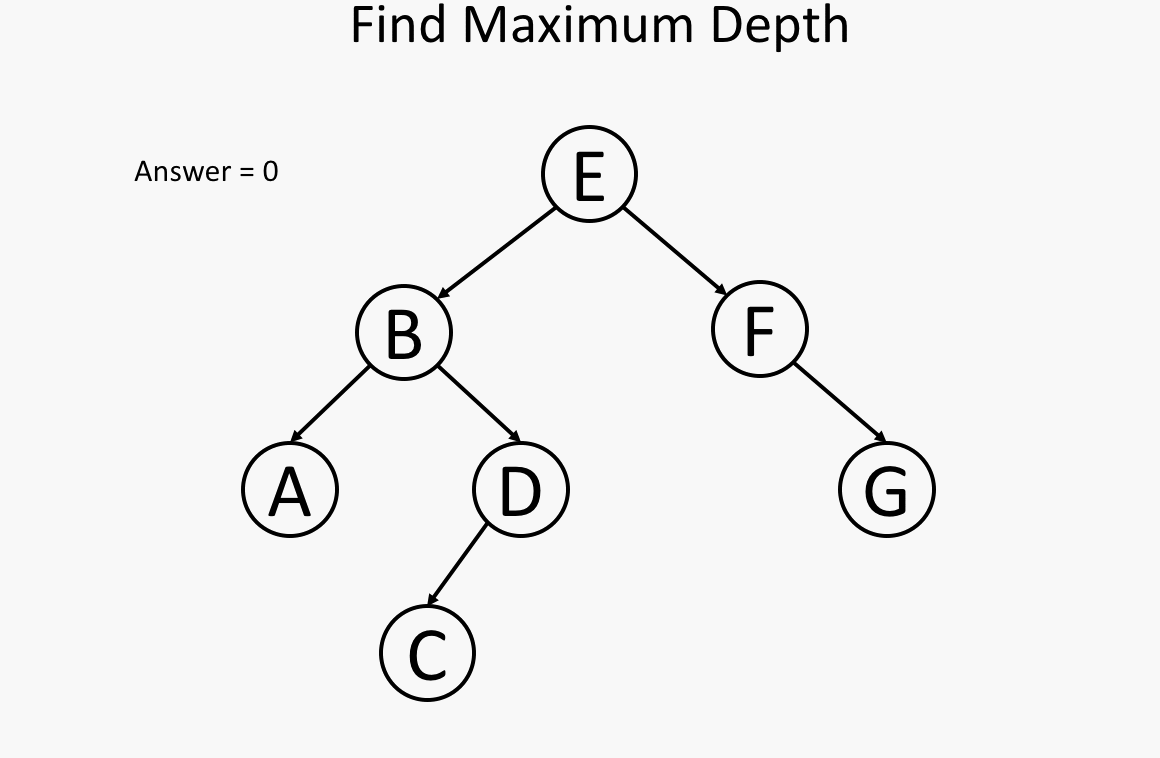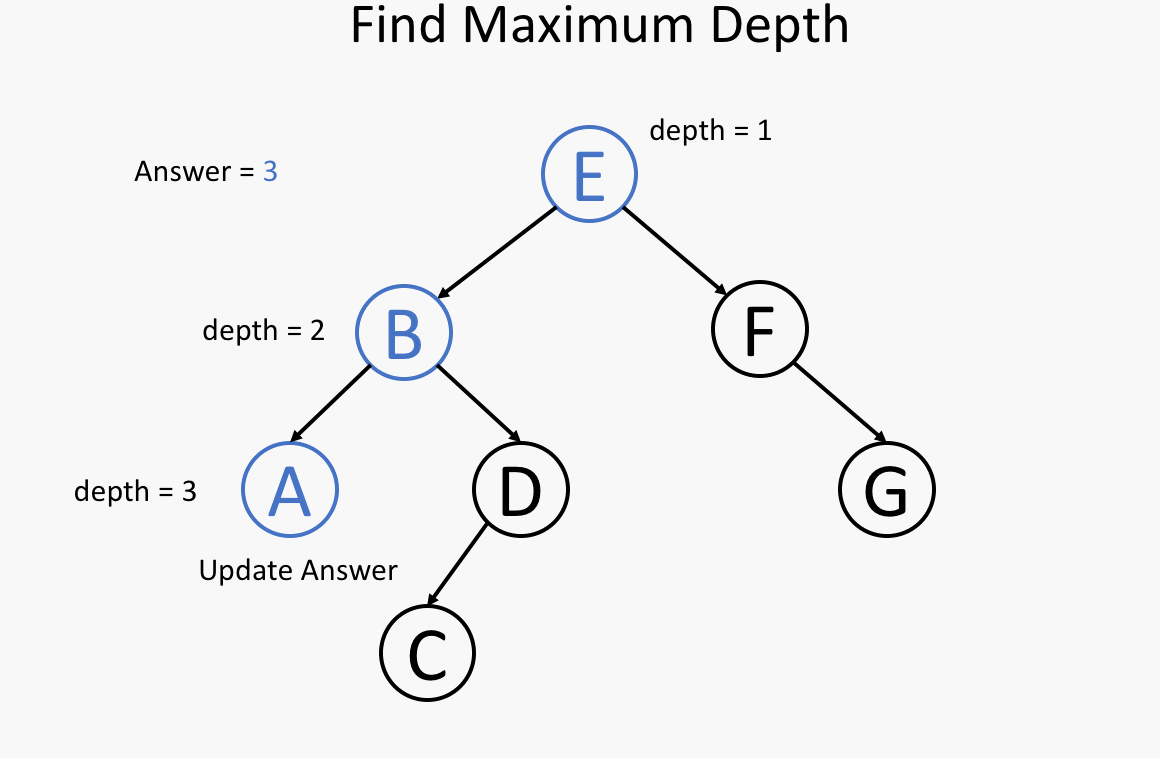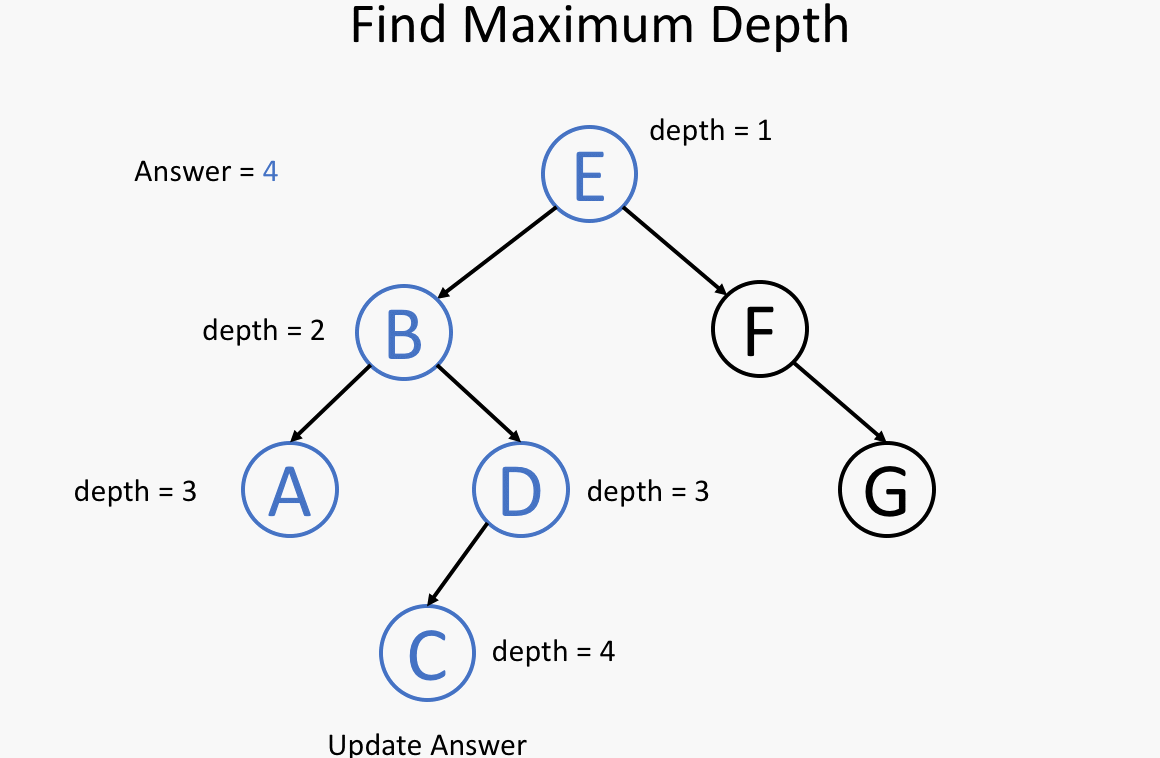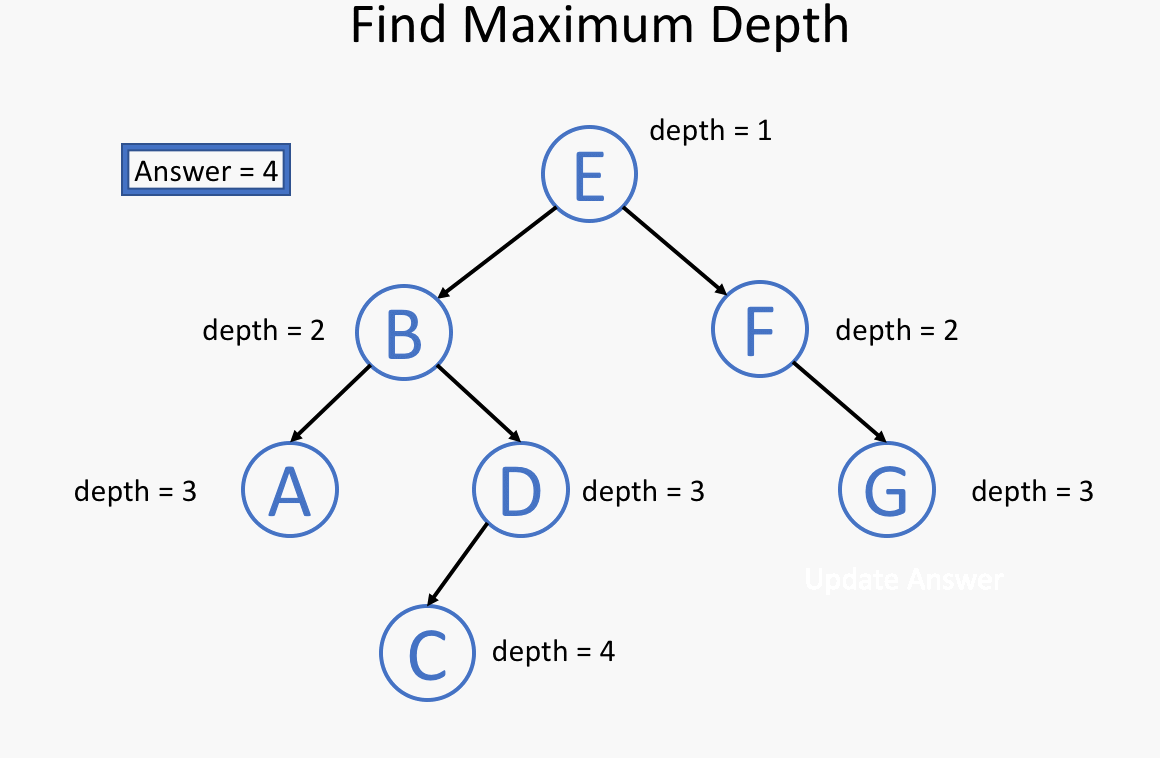
我们知道根节点的深度是 1。对于每个节点,如果我们知道某节点的深度,那我们将知道它子节点的深度。因此,在调用递归函数的时候,将节点的深度传递为一个参数,那么所有的节点都知道他们自身的深度。而对于叶节点,我们可以通过更新深度从而获取最终答案。这里是递归函数 maximum_depth(root, depth) 的伪代码:
1. return if root is null
2. if root is a leaf node:
3. 		answer = max(answer, depth)         // update the answer if needed
4. maximum_depth(root.left, depth + 1)      // call the function recursively for left child
5. maximum_depth(root.right, depth + 1)		// call the function recursively for right child
以下的例子可以帮助你理解它是如何工作的:
我们也提供了代码以供参考:
private int answer;		// don't forget to initialize answer before call maximum_depth
private void maximum_depth(TreeNode root, int depth) {
    if (root == null) {
        return;
    }
    if (root.left == null && root.right == null) {
        answer = Math.max(answer, depth);
    }
    maximum_depth(root.left, depth + 1);
    maximum_depth(root.right, depth + 1);
}
“自底向上” 的解决方案
“自底向上” 是另一种递归方法。在每个递归层次上,我们首先对所有子节点递归的调用函数,然后根据返回值和根节点本身的值得到答案。这个过程可以看做是 后序遍历 的一种。通常,“自底向上” 的递归函数 bottom_up(root) 为如下所示:
1. return specific value for null node
2. left_ans = bottom_up(root.left)			// call function recursively for left child
3. right_ans = bottom_up(root.right)		// call function recursively for right child
4. return answers                           // answer <-- left_ans, right_ans, root.val
让我们继续讨论前面关于树的最大深度的问题,但是使用不同的思维方式:对于树的单个节点,以节点自身为根的子树的最大深度 x 是多少?
如果我们知道一个根节点,以其 左 子节点为根的最大深度为 l 和以其 右 子节点为根的最大深度为 r,我们是否可以回答前面的问题?当然可以,我们可以选择他们之间的最大值,再加上 1 来获得根节点所在的子树的最大深度。那就是 x = max(l, r) + 1。
这意味着对于每一个节点来说,我们都可以在解决它子节点的问题之后得到答案。因此,我们可以使用 “自底向上” 的方法。下面是递归函数 maximum_depth(root) 的伪代码:
1. return 0 if root is null                 // return 0 for null node
2. left_depth = maximum_depth(root.left)
3. right_depth = maximum_depth(root.right)
4. return max(left_depth, right_depth) + 1	// return depth of the subtree rooted at root
以下的例子可以帮助你理解它是如何工作的:
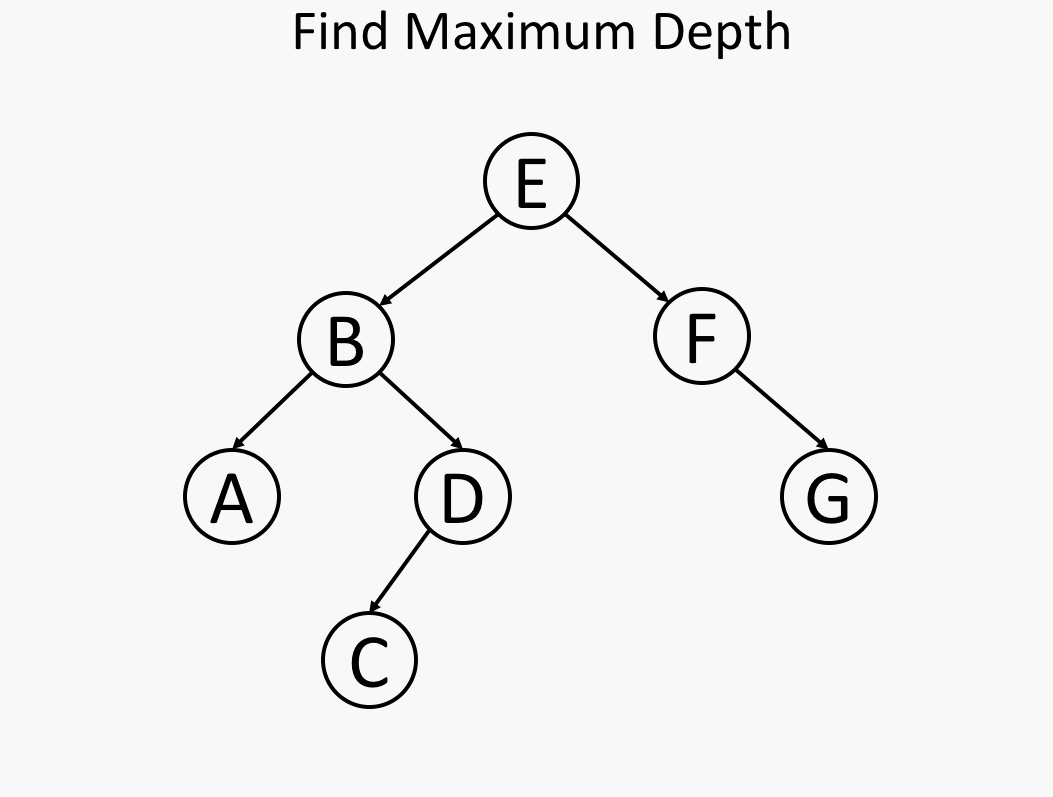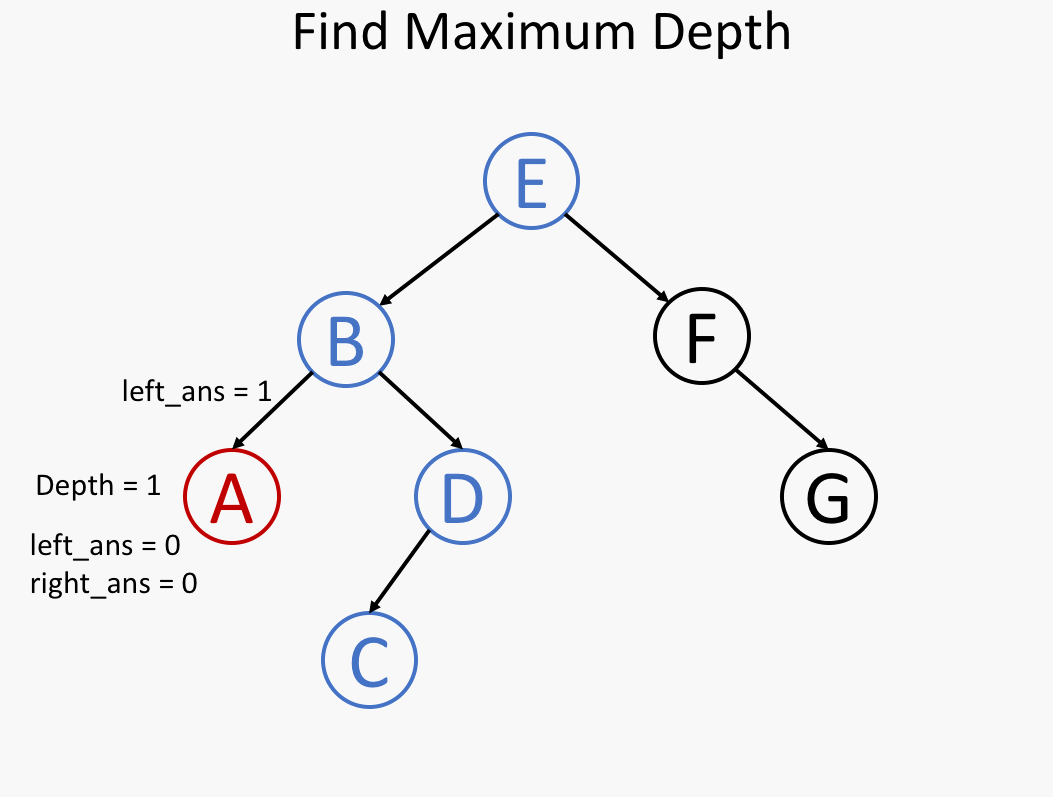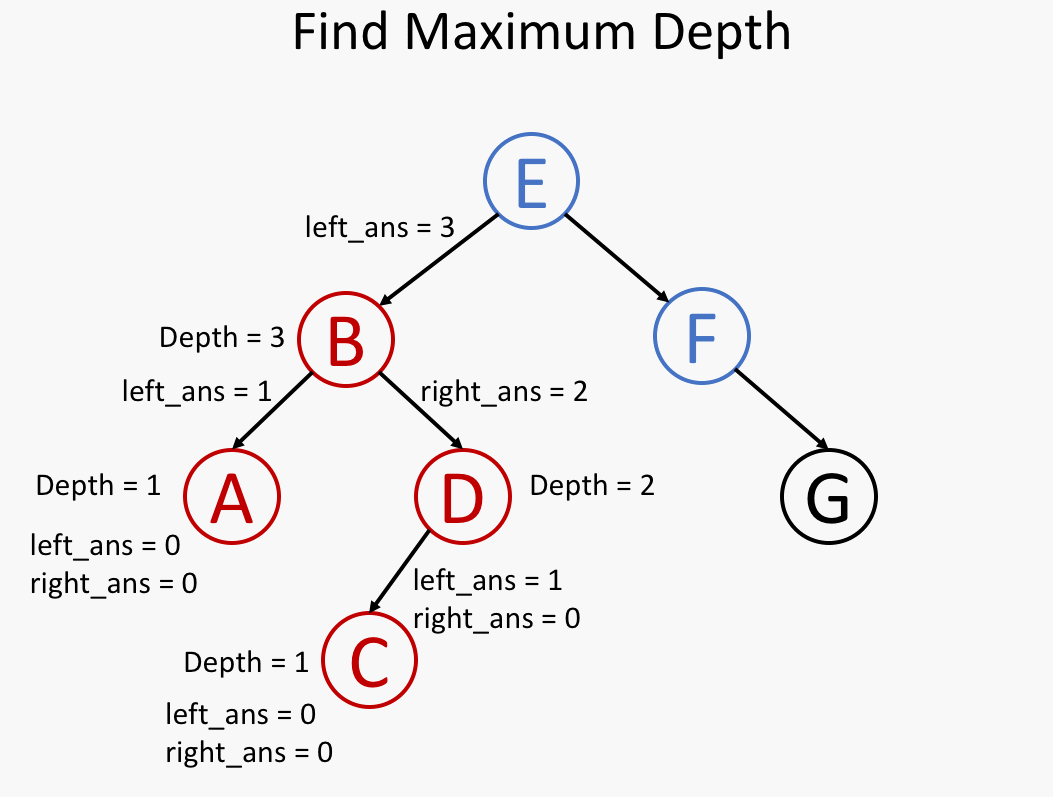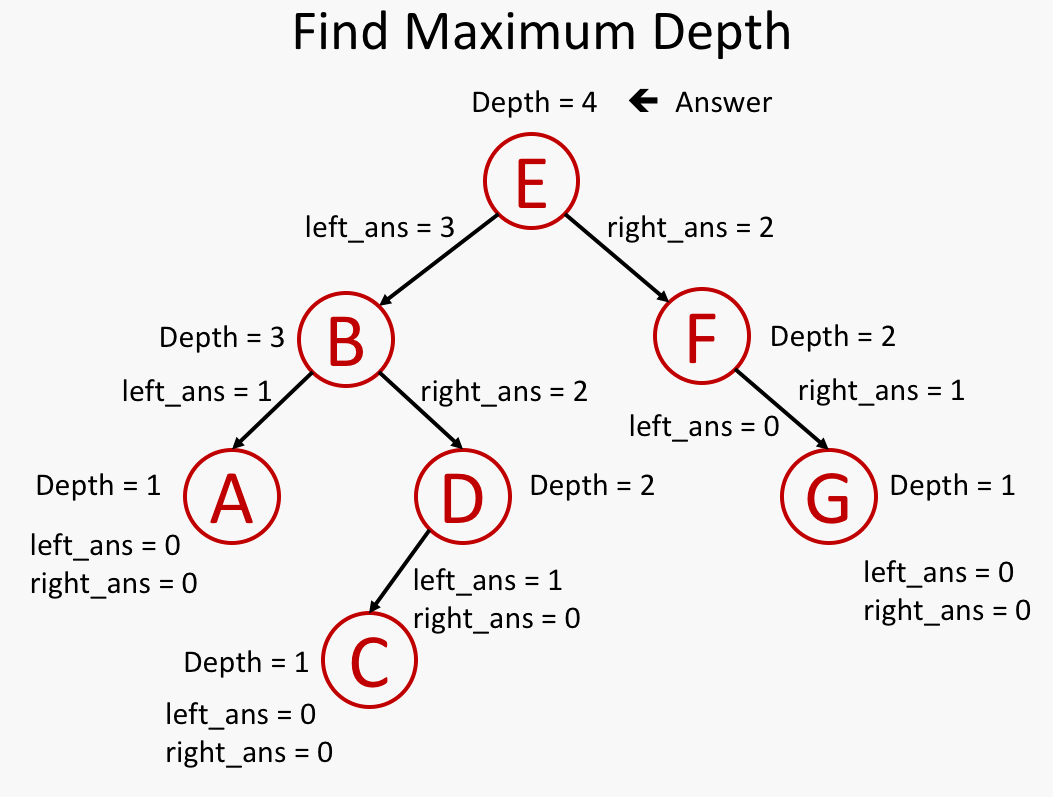
我们也提供了 java 代码以供参考:
public int maximum_depth(TreeNode root) {
	if (root == null) {
		return 0;                                   // return 0 for null node
	}
	int left_depth = maximum_depth(root.left);
	int right_depth = maximum_depth(root.right);
	return Math.max(left_depth, right_depth) + 1;	// return depth of the subtree rooted at root
}
总结
了解递归并利用递归解决问题并不容易。
当遇到树问题时,请先思考一下两个问题:
- 你能确定一些参数,从该节点自身解决出发寻找答案吗?
- 你可以使用这些参数和节点本身的值来决定什么应该是传递给它子节点的参数吗?
如果答案都是肯定的,那么请尝试使用 “自頂向下” 的递归来解决此问题。
或者你可以这样思考:对于树中的任意一个节点,如果你知道它子节点的答案,你能计算出该节点的答案吗?如果答案是肯定的,那么 “自底向上” 的递归可能是一个不错的解决方法。
在接下来的章节中,我们将提供几个经典例题,以帮助你更好的理解树的结构和递归。
LC 二叉树的最大深度
给定一个二叉树,找出其最大深度。
二叉树的深度为根节点到最远叶子节点的最长路径上的节点数。
说明:叶子节点是指没有子节点的节点。
示例:给定二叉树 [3, 9, 20, null, 15, 7]。
    3
   / \
  9  20
    /  \
   15   7
返回它的最大深度 3。
题解
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    public int maxDepth(TreeNode root) {
      if (root == null) {
        return 0;
      }

      int leftDepth = maxDepth(root.left);
      int rightDepth = maxDepth(root.right);
      return Math.max(leftDepth, rightDepth) + 1;
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 为二叉树节点的个数。每个节点在递归中只被遍历一次。
- 空间复杂度:O(height),其中 height 表示二叉树的高度。递归函数需要栈空间,而栈空间取决于递归的深度,因此空间复杂度等价于二叉树的高度。
LC 对称二叉树
给你一个二叉树的根节点 root,检查它是否轴对称。
示例 1:
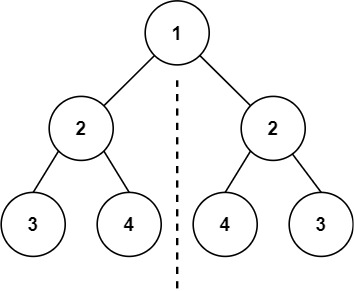
输入:root = [1,2,2,3,4,4,3]
输出:true
示例 2:
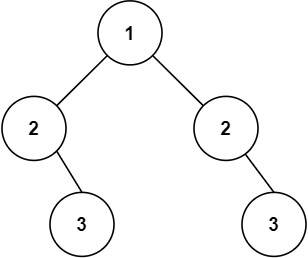
输入:root = [1,2,2,null,3,null,3]
输出:false提示:
- 树中节点数目在范围
[1, 1000]内 -100 <= Node.val <= 100
进阶:你可以运用递归和迭代两种方法解决吗?
题解
方法一:递归
查看解析
如果一个树的左子树与右子树镜像对称,那么这个树是对称的。
因此,该问题可以转化为:两个树在什么情况下互为镜像?
- 它们的两个根节点具有相同的值
- 每个树的右子树都与另一个树的左子树镜像对称
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    public boolean isSymmetric(TreeNode root) {
      return isMirror(root, root);
    }
    public boolean isMirror(TreeNode t1, TreeNode t2) {
      if (t1 == null && t2 == null) {
        return true;
      }
      if (t1 == null || t2 == null) {
        return false;
      }
      return (t1.val == t2.val)
      && isMirror(t1.right, t2.left)
      && isMirror(t1.left, t2.right);
    }
}
复杂度分析
- 时间复杂度:这里遍历了这棵树,渐进时间复杂度为 O(n)。
- 空间复杂度:这里的空间复杂度和递归使用的栈空间有关,这里递归层数不超过 n,故渐进空间复杂度为 O(n)。
方法二:迭代
查看解析
如何使用迭代方法实现呢?首先我们引入一个队列,这是把递归程序改写成迭代程序的常用方法。初始化时,我们把根节点入队两次。每次提取两个节点并比较他们的值,(队列中每两个连续的节点应该是相等的,而且他们的子树互为镜像),然后将两个节点的左右子节点按相反的顺序插入队列中。当队列为空时,或者我们检测到树不对称(即从队列中取出两个不相等的连续节点)时,该算法结束。
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    public boolean isSymmetric(TreeNode root) {
      return check(root, root);
    }
    public boolean check(TreeNode u, TreeNode v) {
      Queue<TreeNode> q = new LinkedList<TreeNode>();
      q.offer(u);
      q.offer(v);
      while (!q.isEmpty()) {
        u = q.poll();
        v = q.poll();
        if (u == null && v == null) {
          continue;
        }
        if (u == null || v == null || (u.val != v.val)) {
          return false;
        }

        q.offer(u.left);
        q.offer(v.right);

        q.offer(u.right);
        q.offer(v.left);
      }
      return true;
    }
}
复杂度分析
- 时间复杂度:O(n)。
- 空间复杂度:这里需要用一个队列来维护节点,每个节点最多进队一次,出队一次,队列中最多不会超过 n 个点,故渐进空间复杂度为 O(n)。
LC 路径总和
给你二叉树的根节点 root 和一个表示目标和的整数 targetSum。判断该树中是否存在 根节点到叶子节点 的路径,这条路径上所有节点值相加等于目标和 targetSum。如果存在,返回 true;否则,返回 false。
示例 1:
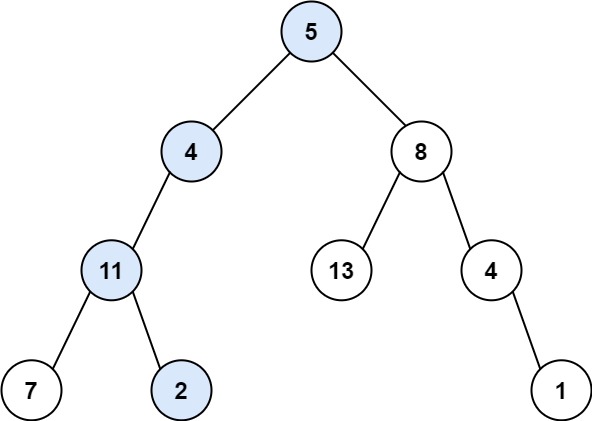
输入:root = [5,4,8,11,null,13,4,7,2,null,null,null,1], targetSum = 22
输出:true
解释:等于目标和的根节点到叶节点路径如上图所示。
示例 2:
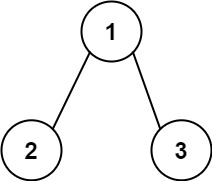
输入:root = [1,2,3], targetSum = 5
输出:false
解释:树中存在两条根节点到叶子节点的路径:
(1 --> 2): 和为 3
(1 --> 3): 和为 4
不存在 sum = 5 的根节点到叶子节点的路径。
示例 3:
输入:root = [], targetSum = 0
输出:false
解释:由于树是空的,所以不存在根节点到叶子节点的路径。提示:
- 树中节点的数目在范围
[0, 5000]内 -1000 <= Node.val <= 1000-1000 <= targetSum <= 1000
题解
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    public boolean hasPathSum(TreeNode root, int targetSum) {
      if (root == null) {
        return false;
      }
      if (root.left == null && root.right == null) {
        return root.val == targetSum;
      }
      return hasPathSum(root.left, targetSum - root.val)
      || hasPathSum(root.right, targetSum - root.val);
    }
}
复杂度分析
- 时间复杂度:O(N),其中 N 是树的节点数。对每个节点访问一次。
- 空间复杂度:O(H),其中 H 是树的高度。空间复杂度主要取决于递归时栈空间的开销,最坏情况下,树呈现链状,空间复杂度为 O(N)。平均情况下树的高度与节点数的对数正相关,空间复杂度为 O(logN)。
总结
在完成前面的章节之后,你应该能够熟悉二叉树以及具备解决相关问题的能力。在本节中,我们会提供更多的练习,帮助你进一步理解二叉树相关的题目。
LC 从中序与后序遍历序列构造二叉树
给定两个整数数组 inorder 和 postorder,其中 inorder 是二叉树的中序遍历,postorder 是同一棵树的后序遍历,请你构造并返回这棵二叉树。
示例 1:
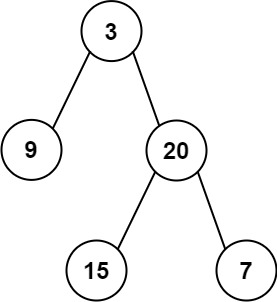
输入:inorder = [9,3,15,20,7], postorder = [9,15,7,20,3]
输出:[3,9,20,null,null,15,7]
示例 2:
输入:inorder = [-1], postorder = [-1]
输出:[-1]提示:
1 <= inorder.length <= 3000postorder.length == inorder.length-3000 <= inorder[i], postorder[i] <= 3000inorder和postorder都由 不同 的值组成postorder中每一个值都在inorder中inorder保证 是树的中序遍历postorder保证 是树的后序遍历
题解
查看题解
我们可以根据中序和后序遍历的特点发现,后序遍历的数组最后一个元素代表的即为根节点。知道这个性质后,我们可以利用已知的根节点信息在中序遍历的数组中找到根节点所在下标,然后根据其将中序遍历的数组分成左右两部分,左边部分即左子树,右边部分为右子树,针对每个部分可以用同样的方法继续递归下去构造。
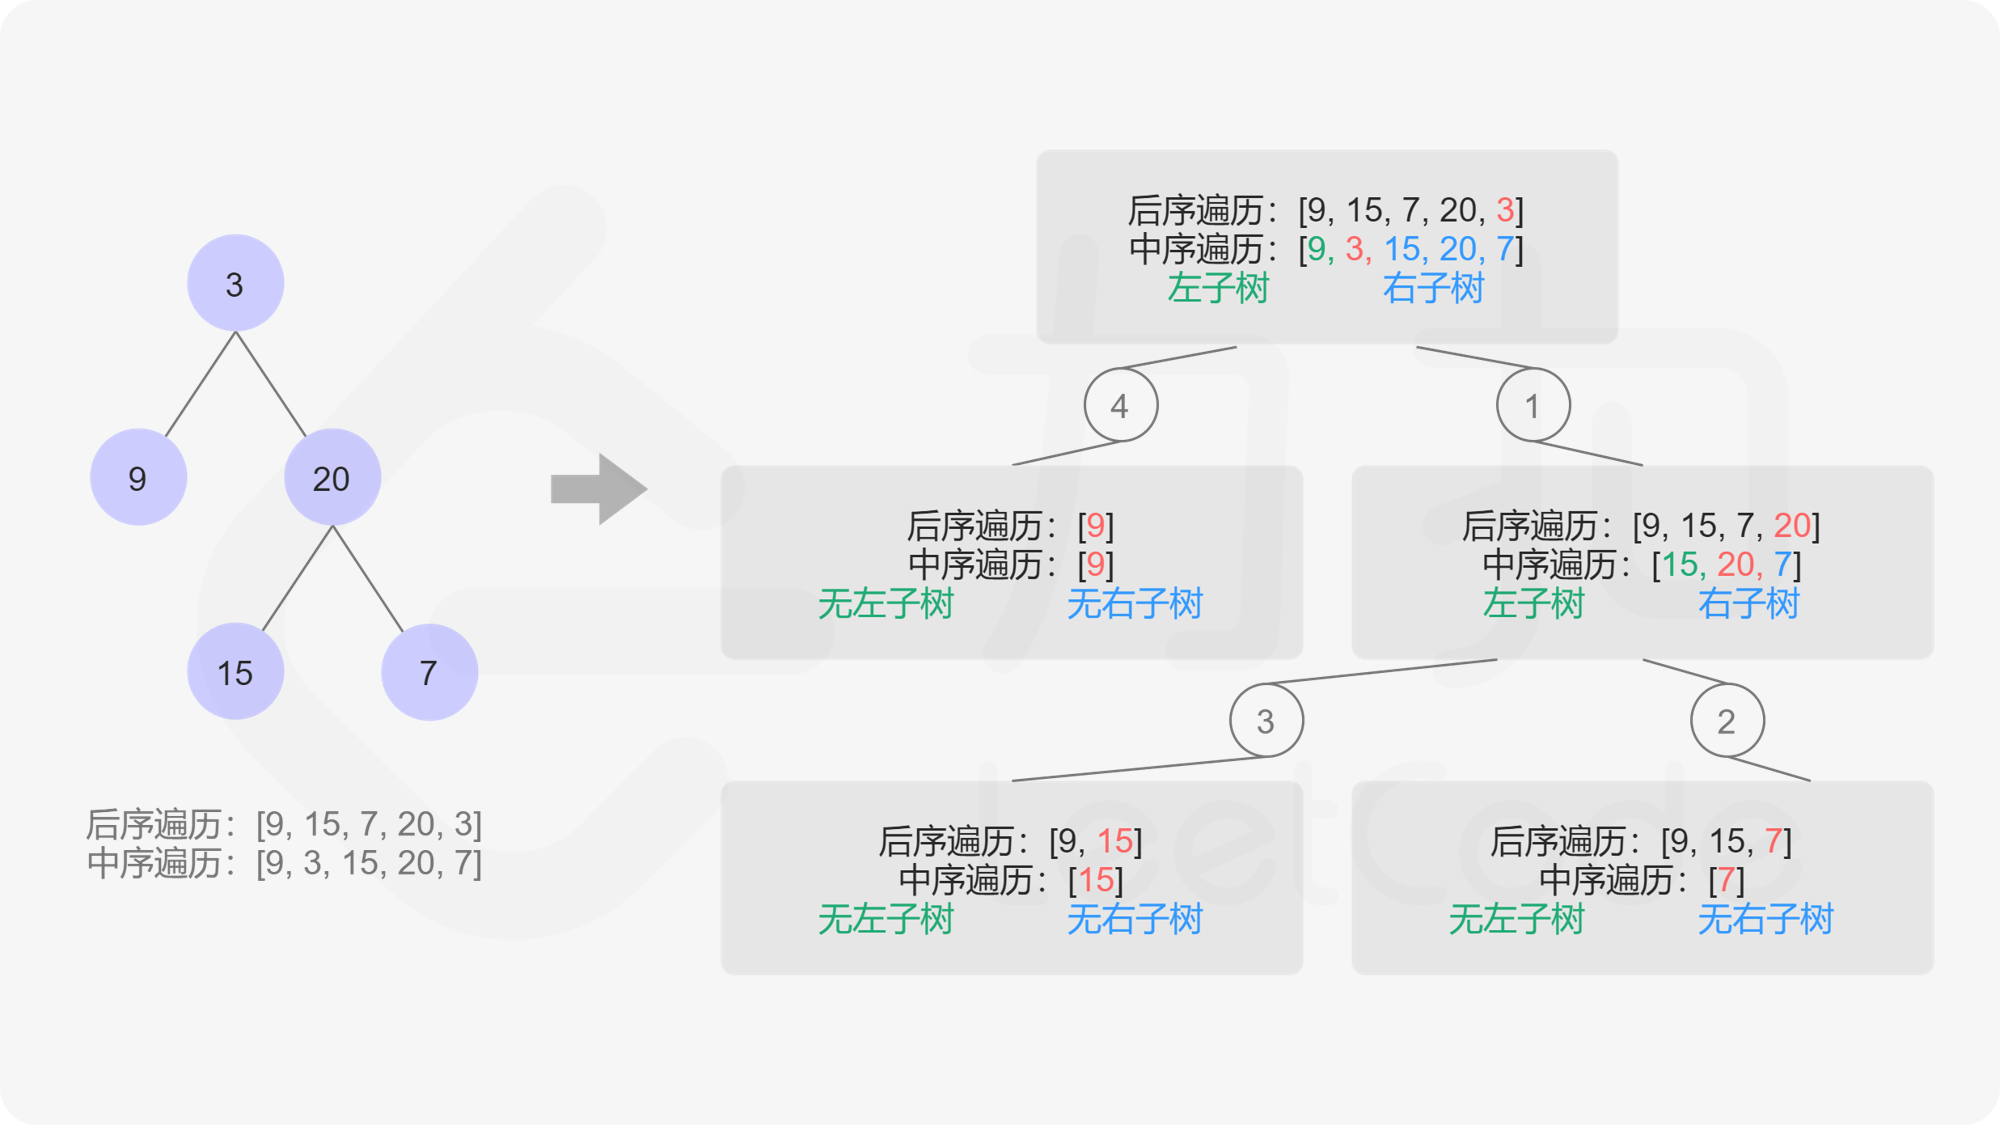
算法
- 为了高效查找根元素在中序遍历数组的下标,我们选择创建哈希表来存储中序序列,即建立一个(元素,下标)键值对的哈希表。
- 定义递归函数 helper(in_left, in_right) 表示当前递归到中序序列中当前子树的左右边界,递归入口为 helper(0, n – 1):
- 如果 in_left > in_right,说明子树为空,返回空节点。
- 选择后序遍历的最后一个节点作为根节点。
- 利用哈希表 O(1) 查询,当根节点在中序遍历中下标为 index。从 in_left 到 index – 1 属于左子树,从 index + 1 到 in_right 属于右子树。
- 根据后序遍历逻辑,递归创建右子树 helper(index + 1, in_right) 和左子树 helper(in_left, index – 1)。注意这里有需要先创建右子树,再创建左子树的依赖关系。可以理解为在后序遍历的数组中整个数组是先存储左子树的节点,再存储右子树的节点,最后存储根节点,如果按每次选择 [后序遍历的最后一个节点] 为根节点,则先被构造出来的应该为右子树。
- 返回根节点 root。
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    int post_idx;
    int[] postorder;
    int[] inorder;
    Map<Integer, Integer> idx_map = new HashMap<Integer,Integer>();
    public TreeNode helper(int in_left, int in_right) {
      // 如果这里没有节点构造二叉树,就结束
      if (in_left > in_right) {
        return null;
      }

      // 选择 post_idx 位置的元素作为当前子树根节点
      int root_val = postorder[post_idx];
      TreeNode root = new TreeNode(root_val);

      // 根据 root 所在位置分成左右两棵子树
      int index = idx_map.get(root_val);

      // 下标减一
      post_idx--;
      // 注意构造子树的先后顺序
      // 构造右子树
      root.right = helper(index + 1, in_right);
      // 构造左子树
      root.left = helper(in_left, index - 1);
      return root;
    }
    public TreeNode buildTree(int[] inorder, int[] postorder) {
      this.postorder = postorder;
      this.inorder = inorder;
      // 从后序遍历的最后一个元素开始
      post_idx = postorder.length - 1;

      // 建立(元素,下标)键值对的哈希表
      int idx = 0;
      for (Integer val : inorder) {
        idx_map.put(val, idx++);
      }

      return helper(0, inorder.length - 1);
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 是树中节点个数。
- 空间复杂度:O(n)。我们需要使用 O(n) 的空间存储哈希表,以及 O(h) (其中 h 是树的高度)的空间表示递归时栈的空间。这里 h < n,所以总空间复杂度为 O(n)。
LC 从前序与中序遍历序列构造二叉树
给定两个整数数组 preorder 和 inorder,其中 preorder 是二叉树的 先序遍历,inorder 是同一棵树的 中序遍历,请你构造二叉树并返回其根节点。
示例 1:
输入: preorder = [3,9,20,15,7], inorder = [9,3,15,20,7]
输出: [3,9,20,null,null,15,7]
示例 2:
输入: preorder = [-1], inorder = [-1]
输出: [-1]提示:
1 <= preorder.length <= 3000preorder.length == inorder.length-3000 <= inorder[i], preorder[i] <= 3000inorder和preorder都由 不同 的值组成inorder均出现在preorderinorder保证 是树的中序遍历preorder保证 是树的前序遍历
题解
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode() {}
 *     TreeNode(int val) { this.val = val; }
 *     TreeNode(int val, TreeNode left, TreeNode right) {
 *         this.val = val;
 *         this.left = left;
 *         this.right = right;
 *     }
 * }
 */
class Solution {
    int pre_idx = 0;
    int[] preorder;
    int[] inorder;
    Map<Integer, Integer> idx_map = new HashMap<Integer, Integer>();
    public TreeNode helper(int in_left, int in_right) {
      if (in_left > in_right) {
        return null;
      }

      int root_val = preorder[pre_idx];
      TreeNode root = new TreeNode(root_val);

      int index = idx_map.get(root_val);
		  // 下标右移
      pre_idx++;
      // 注意构造子树的先后顺序
      root.left = helper(in_left, index - 1);
      root.right = helper(index + 1, in_right);
      return root;
    }
    public TreeNode buildTree(int[] preorder, int[] inorder) {
      this.preorder = preorder;
      this.inorder = inorder;

      int idx = 0;
      for (Integer val : inorder) {
        idx_map.put(val, idx++);
      }

      return helper(0, inorder.length - 1);
    }
}
复杂度分析
- 时间复杂度:O(n),其中 n 是树中节点个数。
- 空间复杂度:O(n)。我们需要使用 O(n) 的空间存储哈希表,以及 O(h) (其中 h 是树的高度)的空间表示递归时栈的空间。这里 h < n,所以总空间复杂度为 O(n)。
LC 填充每个节点的下一个右侧节点指针
给定一个 完美二叉树,其所有叶子节点都在同一层,每个父节点都有两子节点。二叉树定义如下:
struct Node {
  int val;
  Node *left;
  Node *right;
  Node *next;
}
填充它的每个 next 指针,让这个指针指向其下一个右侧节点。如果找不到下一个右侧节点,则将 next 指针设置为 NULL。
初始状态下,所有 next 指针都被设置为 NULL。
示例 1:
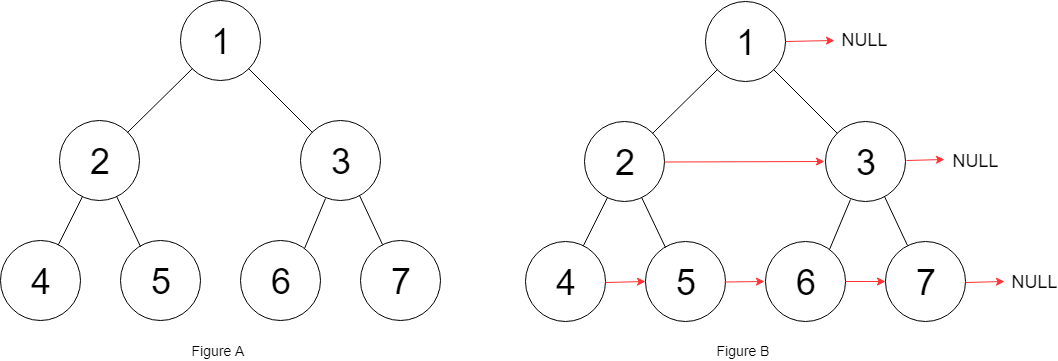
输入:root = [1,2,3,4,5,6,7]
输出:[1,#,2,3,#,4,5,6,7,#]
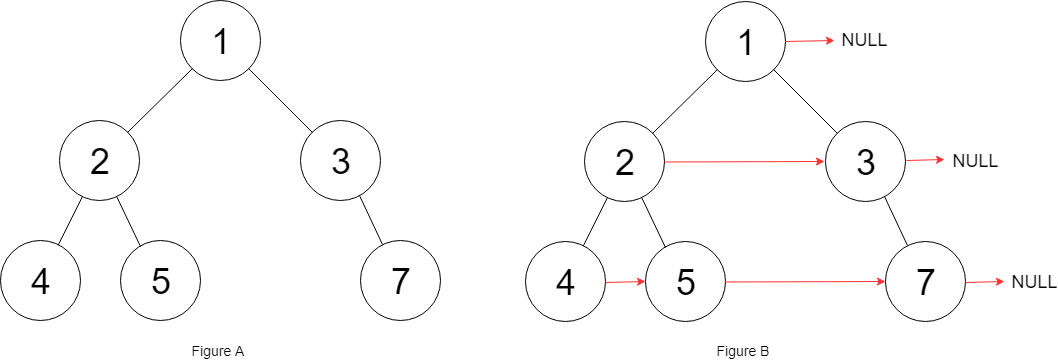
解释:给定二叉树如图 A 所示,你的函数应该填充它的每个 next 指针,以指向其下一个右侧节点,如图 B 所示。序列化的输出按层序遍历排列,同一层节点由 next 指针连接,'#' 标志着每一层的结束。
示例 2:
输入:root = []
输出:[]提示:
- 树中节点的数量在 [0, 212 – 1] 范围内
-1000 <= node.val <= 1000
进阶:
- 你只能使用常量级额外空间。
- 使用递归解题也符合要求,本题中递归程序占用的栈空间不算做额外的空间复杂度
题解
/*
// Definition for a Node.
class Node {
    public int val;
    public Node left;
    public Node right;
    public Node next;

    public Node() {}

    public Node(int _val) {
        val = _val;
    }

    public Node(int _val, Node _left, Node _right, Node _next) {
        val = _val;
        left = _left;
        right = _right;
        next = _next;
    }
};
*/

class Solution {
    public Node connect(Node root) {
      if (root != null) {
        dfs(root.left, root.right);
      }
      return root;
    }
    private void dfs(Node left, Node right) {
      if(left == null) return;
      left.next = right;
      dfs(left.left, left.right);
      dfs(left.right, right.left);
      dfs(right.left, right.right);
    }
}
LC 填充每个节点的下一个右侧节点指针Ⅱ
给定一个二叉树
struct Node {
  int val;
  Node *left;
  Node *right;
  Node *next;
}
填充它的每个 next 指针,让这个指针指向其下一个右侧节点。如果找不到下一个右侧点,则将 next 指针设置为 NULL。
初始状态下,所有 next 指针都被设置为 NULL。
示例 1:
输入:root = [1,2,3,4,5,null,7]
输出:[1,#,2,3,#,4,5,7,#]
解释:给定二叉树如图 A 所示,你的函数应该填充它的每个 next 指针,以指向其下一个右侧节点,如图 B 所示。序列化输出按层序遍历顺序(由 next 指针连接),'#' 表示每层的末尾。
示例 2:
输入:root = []
输出:[]提示:
- 树中的节点数在范围
[0, 6000]内 -100 <= Node.val <= 100
进阶:
- 你只能使用常量级额外空间
- 使用递归解题也符合要求,本题中递归程序的隐式栈空间不计入额外空间复杂度。
题解
/*
// Definition for a Node.
class Node {
    public int val;
    public Node left;
    public Node right;
    public Node next;

    public Node() {}

    public Node(int _val) {
        val = _val;
    }

    public Node(int _val, Node _left, Node _right, Node _next) {
        val = _val;
        left = _left;
        right = _right;
        next = _next;
    }
};
*/

class Solution {
    public Node connect(Node root) {
      if (root == null) return null;
      if (root.left != null) {
        root.left.next = root.right != null ? root.right : getNext(root.next);
      }
      if (root.right != null) {
        root.right.next = getNext(root.next);
      }
      // 注意递归的先后顺序
      connect(root.right);
      connect(root.left);
      return root;
    }
    // 根据已经连接好的父节点找下一个可连接的右侧节点
    private Node getNext(Node uncle) {
      if (uncle == null) return null;
      if (uncle.left != null) return uncle.left;
      if (uncle.right != null) return uncle.right;
      return getNext(uncle.next);
    }
}
LC 二叉树的最近公共祖先
给定一个二叉树,找到该树中两个指定节点的最近公共祖先。
最近公共祖先的定义为:“对于有根树 T 的两个节点 p、q,最近公共祖先表示为一个节点 x,满足 x 是 p、q 的祖先且 x 的深度尽可能大(一个节点也可以是它自己的祖先)。”
示例 1:
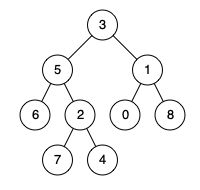
输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 1
输出:3
解释:节点 5 和节点 1 的最近公共祖先是节点 3 。
示例 2:
输入:root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 4
输出:5
解释:节点 5 和节点 4 的最近公共祖先是节点 5 。因为根据定义最近公共祖先节点可以为节点本身。
示例 3:
输入:root = [1,2], p = 1, q = 2
输出:1提示:
- 树中节点数目在范围
[2, 10^5^]内。 - 109 <= Node.val <= 109
- 所有
Node.val 互不相同 p != qp和q均存在于给定的二叉树中。
题解
/**
 * Definition for a binary tree node.
 * public class TreeNode {
 *     int val;
 *     TreeNode left;
 *     TreeNode right;
 *     TreeNode(int x) { val = x; }
 * }
 */
class Solution {
    public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q) {
        if (root == null || root == p || root == q) {
            return root;
        }
        TreeNode left = lowestCommonAncestor(root.left, p, q);
        TreeNode right = lowestCommonAncestor(root.right, p, q);
        // 如果left为空,说明这两个节点在 root 结点的右子树上,我们只需要返回右子树查找的结果即可
        if (left == null) {
            return right;
        }
        // 同上
        if (right == null) {
            return left;
        }
        //如果left和right都不为空,说明这两个节点一个在 root 的左子树上一个在cur的右子树上,
        //我们只需要返回 root 结点即可。
        return root;
    }
}
复杂度分析
- 时间复杂度:O(N),其中 N 是二叉树的节点数。二叉树的所有节点有且只会被访问一次。
- 空间复杂度:O(N),其中 N 是二叉树的结点数。递归调用的栈深度取决于二叉树的高度,二叉树最坏的情况下为一条链,此时高度为 N,因此空间复杂度为 O(N)。
LC 二叉树的序列化与反序列化
序列化是将一个数据结构或者对象转换为连续的比特位的操作,进而可以将转换后的数据存储在一个文件或者内存中,同时也可以通过网络传输到另一个计算机环境,采取相反方式重构得到原数据。
请设计一个算法来实现二叉树的序列化与反序列化。这里不限定你的序列 / 反序列化算法执行逻辑,你只需要保证一个二叉树可以被序列化为一个字符串并且将这个字符串反序列化为原始的树结构。
示例 1:
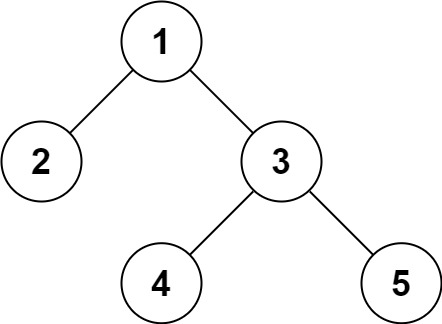
 输入:root = [1,2,3,null,null,4,5]
 输出:[1,2,3,null,null,4,5]
示例 2:
 输入:root = []
 输出:[]
示例 3:
 输入:root = [1]
 输出:[1]
示例 4:
 输入:root = [1,2]
输出:[1,2]提示:
- 树中节点数在范围 [0, 104] 内
-1000 <= Node.val <= 1000
题解
查看解析
二叉树的序列化本质是对其进行编码,更重要的是对其结构进行编码。可以遍历树来完成上述任务。一般有两个策略:广度优先搜索和深度优先搜索。
- 广度优先搜索可以按照层次的顺序从上到下遍历所有的节点。
- 深度优先搜索可以从一个根开始,一直延伸到某个叶,然后回到根,到达另一个分支。根据根节点、左节点和右节点之间的相对顺序,可以进一步将深度优先搜索策略分为:
- 先序遍历
- 中序遍历
- 后续遍历
这里,我们选择先序遍历的编码方式:
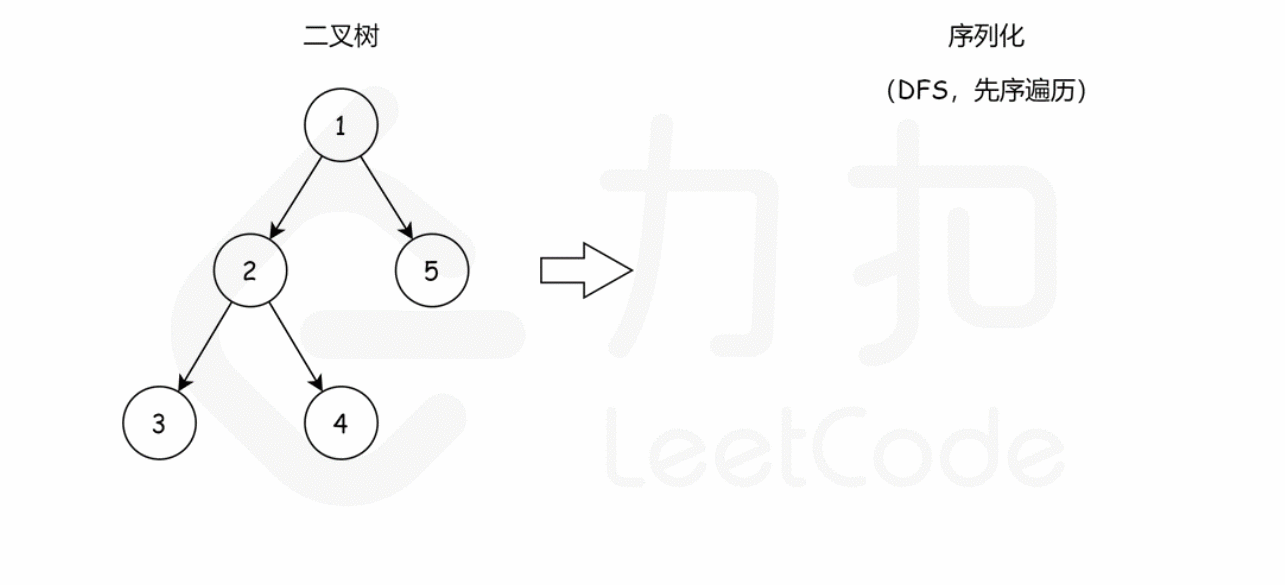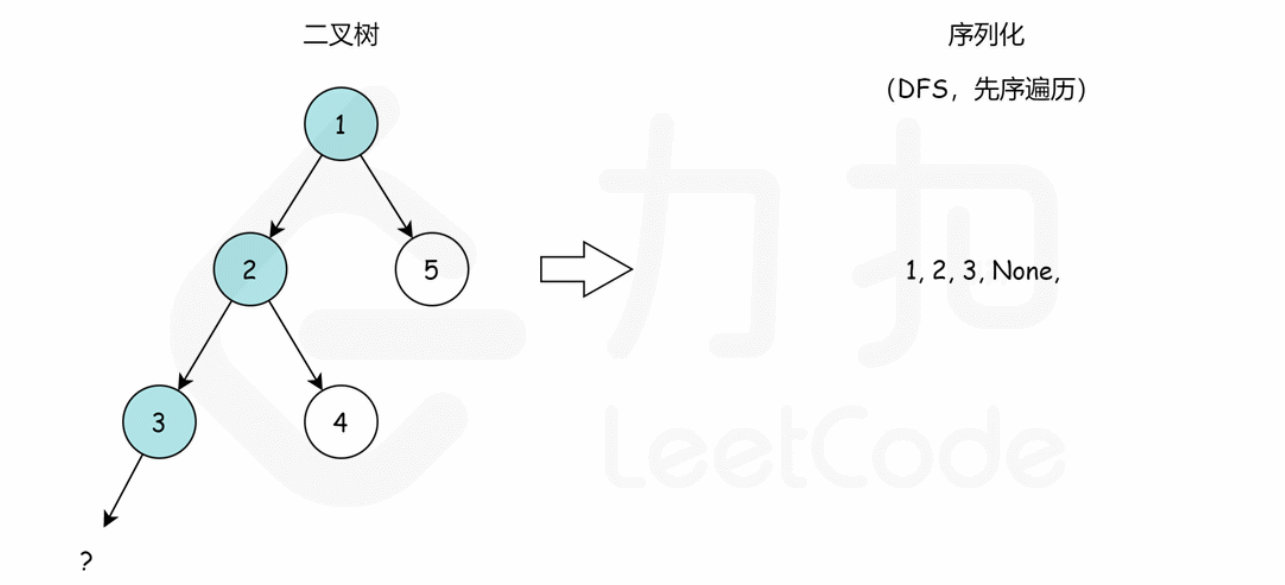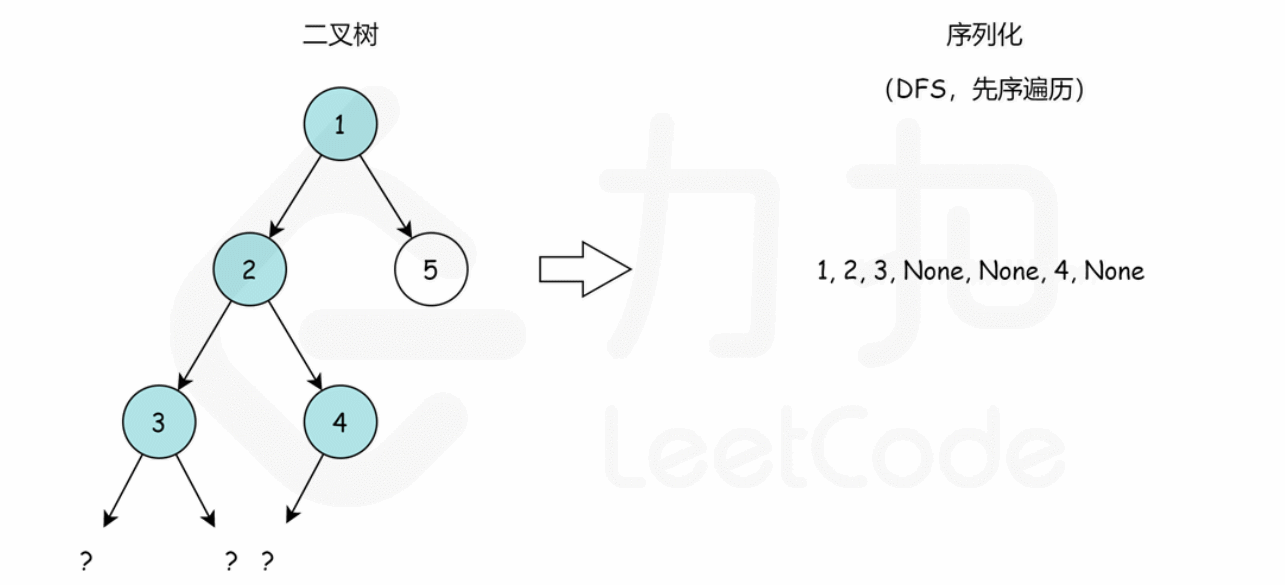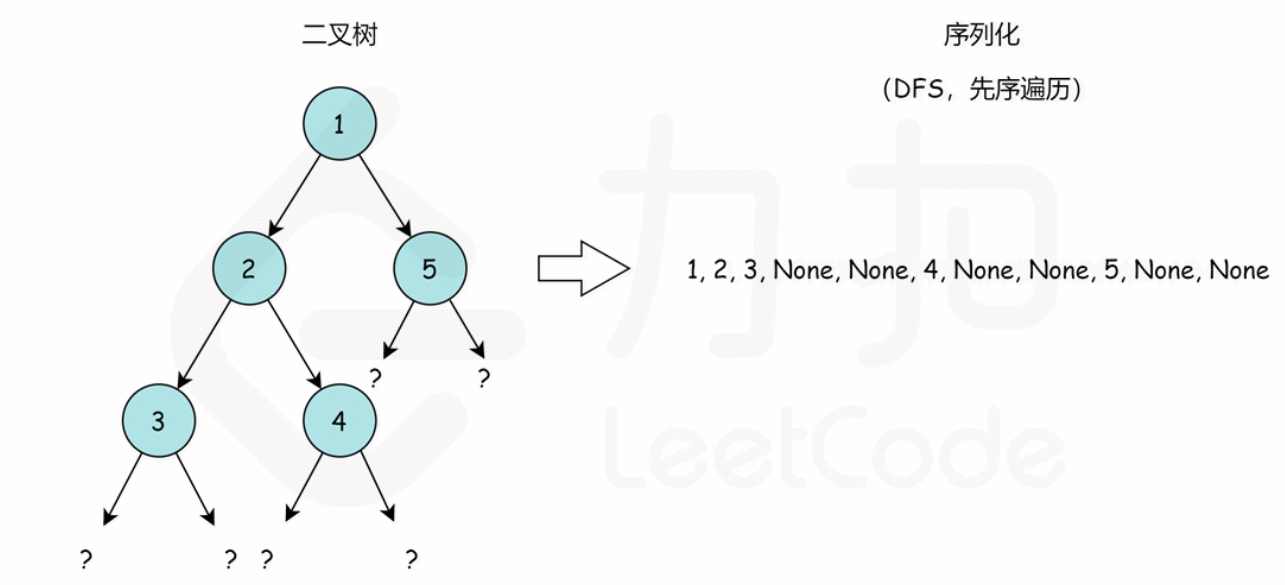
我们从根节点 1 开始,序列化字符串是 1。然后我们跳到根节点 2 的左子树,序列化字符串变成 1, 2。现在从节点 2 开始,我们访问它的左节点 3(1, 2, 3, None, None)和右节点 4(1, 2, 3, None, None, 4, None, None)。None, None 是用来标记缺少左、右子节点,这就是我们在序列化期间保存树结构的方式。最后,我们回到根节点 1 并访问它的右子树,它恰好是叶节点 5。最后序列化字符串是 1, 2, 3, None, None, 4, None, None, 5, None, None。
即我们可以先序遍历这棵二叉树,遇到空子树的时候序列化成 None,否则继续递归序列化。那么我们如何反序列化,首先我们需要根据 “,” 把原先的序列分割开来得到先序遍历的元素列表,然后从左向右遍历这个序列:
- 如果当前元素为 None,则当前为空树
- 否则先解析这树的左子树,再解析它的右子树
public class Codec {
public String serialize(TreeNode root) {
return rserialize(root, "");
}
public TreeNode deserialize(String data) {
String[] dataArray = data.split(",");
List<String> dataList = new LinkedList<String>(Arrays.asList(dataArray));
return rdeserialize(dataList);
}
public String rserialize(TreeNode root, String str) {
if (root == null) {
str += "None,";
} else {
str += str.valueOf(root.val) + ",";
str = rserialize(root.left, str);
str = rserialize(root.right, str);
}
return str;
}
public TreeNode rdeserialize(List<String> dataList) {
if (dataList.get(0).equals("None")) {
dataList.remove(0);
return null;
}
TreeNode root = new TreeNode(Integer.valueOf(dataList.get(0)));
dataList.remove(0);
root.left = rdeserialize(dataList);
root.right = rdeserialize(dataList);
return root;
}
}复杂度分析
- 时间复杂度:在序列化和反序列化函数中,我们只访问每个节点一次,因此时间复杂度为 O(n),其中 n 是节点数,即树的大小。
- 空间复杂度:在序列化和反序列化函数中,我们递归会使用栈空间,故渐进空间复杂度为 O(n)。
