共计 4733 个字符,预计需要花费 12 分钟才能阅读完成。
时间复杂度
概念
时间复杂度的定义:在计算机科学中,算法的时间复杂度是一个函数,它定量描述了该算法的运行时间。 一个算法执行所耗费的时间理论上来说是算不出来的,因为它不仅仅与你写的算法有关,还与运行这个算法的机器也有关系,如果你的机器很好,那么你所耗费的时间就可能会更少,所以,一个算法耗费的时间是需要放在机器上实际测验才能知道的,但是我们总不能每个算法都拿来上机测试,来记录该算法的时间,所以我们就有了时间复杂度这样的分析方式。
一个算法所花费的时间与其中语句的执行次数成正比例,算法中的基本操作的执行次数,为算法的时间复杂度。
大O的线性表示法
大O符号(Big O notation):是用于描述函数渐进行为的数学符号。 我们来计算一下下面代码的时间复杂度:
 void Func1(int N)
 {
     int count = 0;
     for (int i = 0; i < N; ++i)
     {
         for (int j = 0; j < N; ++j)
         {
             ++count;
         }
     }
     for (int k = 0; k < 2 * N; ++k)
     {
         ++count;
     }
     int M = 10;
     while (M--)
     {
         ++count;
     }
     printf("%d\n", count);
 }
这个函数在调用的过程中使用了三个for循环和一个while循环,每循环一次我们说它进行了一次基本操作。那么这个函数执行基本操作的次数为 F(N) = N² + 2*N + 10
那么我们如何用大O的线性表示法来表示这个函数的时间复杂度呢?
推导大O阶方法:
- 用常数1取代运行时间中的所有加法常数。
- 在修改后的运行次数函数中,只保留最高阶项。
- 如果最高阶项存在且不是1,则去除与这个项目相乘的常数。得到的结果就是大O阶。
按照上面的规则,那么上述代码的时间复杂度就为O(N²)。
我们发现,通过上面的规则,我们就使用N²来代替了N²+2*N+10,我们为什么要这样规定呢,我们以上面的表达式为例,当N为不同的值时,表达式的结果为多少
N = 100 F(N) = 10210
N = 1000 F(N) = 1002010
N = 10000 F(N) = 100020010
我们发现,当N不断变大时,表达式的值也不断变大,而对表达式的结果影响最大的一项就是这个表达式中阶数最高的那一项。
那我们为什么只保留对结果影响最大的那一项呢?我们知道时间复杂度描述的对象是一个算法,而不是某一次的运算,那么当我们使用这个算法并向里面传入一个能够影响算法基本操作执行次数的变量时,我们并不能确定我们输入的N的值是多少,N就有可能是任何值,当N比较小时,也许别的项与最高阶项的结果差距并没有那么大,但是当N的值越来越大时,最高阶项的值与其他项的值的差距也就越来越大了,我们还是以上面的代码为例,当我们的N在不断的变大时,因为其余项对结果的影响相对来说比较小,那么我们就可以忽略他们对结果的影响,只保留对结果影响最大的那一项来表示我们的时间复杂度。
那么为什么我们要用1来表示所以的常数呢,这是因为计算机的运行速度是非常快的,每秒可能就可以执行上亿此的运算,那么常数次的执行次数与我们计算机的运算速度相比,可能与执行一次的运行速度相差不会太大,所以我们就使用1来代替所有的常数项,那么只有循环次数为常数的算法的时间复杂度相应的就是O(1)。
去掉与最高阶项相乘的常数的原因也是因为对结果影响最大的是这个最高阶项,而不是这个最高阶项前面的系数,所以也要把它去掉。
时间复杂度举例
现在我们就大概明白了如何来计算一个算法的时间复杂度,下面我们来看几个代码练习一下。
 void Func(int N, int M)
 {
     int count = 0;
     for (int k = 0; k < M; ++k)
     {
         ++count;
     }
     for (int k = 0; k < N; ++k)
     {
         ++count;
     }
     printf("%d\n", count);
 }
在这个算法中,我们在传入了两个变量,导致两个循环的循环次数分别由两个变量来决定,这时我们认为时间复杂度为O(N+M),因为我们不知道M和N谁大,所以我们谁都无法省略。
 void my_strchr(char* str,char c)
 {
     while (*str != '\0')
     {
         if (*str == c)
         {
             return str;
         }
         str++;
     }
 }
这是一个简单的字符串查找函数,在这个算法中,并没有一个变量值来描述我们需要进行循环的次数,而觉得我们循环次数的是被查找字符串的长度,在时间复杂度的计算中,我们通常假设数组或字符串的长度为N,还有一个问题是这个算法中即使我们知道了字符串的长度但是我们执行循环的次数也是不一定的,因为我们不知道什么时候能够在字符串中找到我们寻找的元素,可能我们在第一个位置就找到了,也有可能我们要遍历整个字符串在最后一个元素的位置才能找到,出现这种情况时默认时间复杂度要以最坏的情况为准,即O(N)。
冒泡排序的时间复杂度:
 void BubbleSort(int* a, int n)
 {
     assert(a);
     for (size_t end = n; end > 0; --end)
     {
         int exchange = 0;
         for (size_t i = 1; i < end; ++i)
         {
             if (a[i - 1] > a[i])
             {
                 Swap(&a[i - 1], &a[i]);
                 exchange = 1;
             }
         }
         if (exchange == 0)
             break;
     }
 }
上面的是一个冒泡排序的函数,我们知道在进行冒泡排序时,我们首先要进行 N 次排序,然后在每次排序时,我们又要遍历这个数组,但是我们每进行一次排序,在下一次排序时我们就可以少遍历一个元素,所以我们可以得到实际的运算次数F(N) = N + (N-1) + (N-2)……+ 2 + 1。这是一个等差数列,结果化简为 F(N) = N*(N+1) / 2,所以时间复杂度为O(N²)
二分查找的时间复杂度:
 int BinarySearch(int* a, int n, int x)
 {
     assert(a);
     int begin = 0;
     int end = n - 1;
     while (begin < end)
     {
         int mid = begin + ((end - begin) >> 1);
         if (a[mid] < x)
             begin = mid + 1;
         else if (a[mid] > x)
             end = mid;
         else
             return mid;
     }
     return -1;
}上面的是一个二分查找函数的代码,我们知道二分查找是在一个有序数组中查找某一个元素时的比较高效的方法,在进行二分查找时,我们每次都取数组的中间值,然后再根据中间值与查找值的大小来确定我们要查找的元素在那一半,然后在对找到的哪一半数组进行重复的操作,直到找到我们需要的元素,使用二分查找时,最坏的情况是我们把数组除的只剩最后一个元素,这时表达式为N ÷ 2 ÷ 2 ÷ 2 ÷ 2…÷ 2 ÷ 2 = 1我们把这个式子换算一下为N = 1 × 2 × 2 × 2…× 2 × 2我们每相乘一次,就进行了一次基本操作,所以上式中我们一共进行了log₂N次,所以时间复杂度为O(log₂N)。
递归的时间复杂度:
 long long Fibonacci(size_t N)
 {
     return N < 2 ? N : Fibonacci(N-1)+Fibonacci(N-2);
 }
上面的代码是一个计算斐波那契数列的函数,使用的是递归的方法,我们知道递归的方法来计算斐波那契数列是非常低效的,最好还是使用循环的方法,但是递归的时间复杂度是多少呢?
我们知道每一次调用这个函数时,我们的时间复杂度是一个常数,那么这个递归的时间复杂度就是我们一共调用了多少次函数,现在我们来分析一下我们到底调用了多少次这个函数。
其调用结构如图所示:
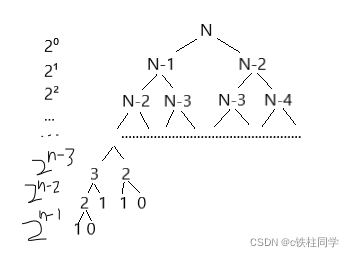
当我们输入N时,函数会进行两调用,然后不断地调用,其调用的结果如图所示,在右下角是有一个空缺区域的,但是我们可以把这一块空缺的区域看作一个常数,假设它是满的,那么我们执行调用的总次数为F(N) = 2⁰ + 2¹ + 2² +…+ 2N - 1 = 2N-1,所以该算法的时间按复杂度为O(2N)。
由以上的计算我们就可以发现用递归来算斐波那契数的算法的时间复杂度太高了,也就说明了这个算法的低效。
空间复杂度
空间复杂度的定义
空间复杂度是对一个算法在运行过程中临时占用存储空间大小的量度 。空间复杂度不是程序占用了多少bytes的空间,因为这个也没太大意义,所以空间复杂度算的是变量的个数。空间复杂度计算规则基本跟实践复杂度类似,也使用大O渐进表示法。
空间复杂度举例
冒泡排序的空间复杂度:
 void BubbleSort(int* a, int n)
 {
      assert(a);
      for (size_t end = n; end > 0; --end)
      {
          int exchange = 0;
          for (size_t i = 1; i < end; ++i)
          {
              if (a[i-1] > a[i])
              {
                  Swap(&a[i-1], &a[i]);
                  exchange = 1;
              }
          }
          if (exchange == 0)
          break;
      }
 }
还是刚刚冒泡排序的代码,我们刚刚计算了它的时间复杂度,现在再来看一下它的空间复杂度,根据定义我们知道,空间复杂度是用来估算占用空间的大小的,那么我们就可以根据算法中创建的变量的个数来表示算法的空间复杂度,这个冒泡排序算法创建了 3 个变量,根据大O的渐进表示法的规则,该算法的空间复杂度就为 O(1)。
循环方法计算斐波那契数列的空间复杂度:
long long* Fibonacci(size_t n)
{
if (n == 0)
return NULL;
long long* fibArray =(long long*)malloc((n + 1) * sizeof(long long));
fibArray[0] = 0;
fibArray[1] = 1; for (int i = 2; i <= n; ++i)
{
fibArray[i] = fibArray[i - 1] + fibArray[i - 2];
}
return fibArray;
}这就是循环方法计算斐波那契数的代码,我们发现在这个算法中,我们使用 malloc 开辟了一块元素个数为 n+1 的空间,那就相当于创建了 n+1 个变量,根据大O的线性表示法,该算法的空间复杂度就为 O(N)。
那么我们使用递归的方法时的空间复杂度又是多少呢?
long long Factorial(size_t N)
{
     return N < 2 ? N : Factorial(N-1)*N;
}
我们知道在调用函数时,是会创建栈帧的,简单来说就是我们每调用一次函数,就会为调用的那个函数创建一块空间,在计算递归算法的空间复杂度时,我们可以认为每次函数调用时都会创建常数个变量,那么影响我们算法空间复杂度的就是我们调用递归的次数,那么以上面的算法为例,该算法的空间复杂度就是 O(N)。递归算法的空间复杂度通常是递归的深度。
空间复杂度一般只有两种情况:
- 创建了常数个变量:O(1)
- 创建了N个变量:O(N)
原文地址:https://blog.csdn.net/qq_45967533/article/details/123221399
