共计 29045 个字符,预计需要花费 73 分钟才能阅读完成。
数组和字符串
数组 是数据结构中的基本模块之一。因为 字符串 是由字符数组形成的,所以二者是相似的。大多数面试问题都属于这个范畴。
在本 LeetBook 中,我们将介绍 数组 和 字符串。完成后,你将:
- 理解数组的 基本概念 及其 操作方式;
- 理解 二维数组 的基本概念,熟悉二维数组的使用;
- 了解 字符串 的概念以及字符串所具有的不同特性;
- 理解字符串匹配中的 KMP 算法;
- 能够运用 双指针 解决实际问题。
数组简介
本章节中,我们将详细介绍 数组 这种数据结构。
完成本章后,你将能够回答以下问题:
- 数组和列表、集合之间有什么不同?
- 如何理解数组的读取、查找、插入、删除等 基本操作?
- 数组在内存中是如何存放的?
- 在你常用的语言中,如何对数组执行初始化、数据访问、修改、迭代、排序、添加、删除等操作?
A 集合、列表和数组
具体介绍数组之前,我们先来了解一下集合、列表和数组的概念之间的差别。
集合
集合一般被定义为:由一个或多个确定的元素所构成的整体。
通俗来讲,集合就是将一组事物组合在一起。你可以将力扣的题库看作一个集合:
也可以将力扣商店里的礼品看做一个集合:
甚至可以将桌面上的物品当作一个集合。
集合有什么特性呢?
首先,集合里的元素类型不一定相同。 你可以将商品看作一个集合,也可以将整个商店看作一个集合,这个商店中有人或者其他物品也没有关系。
其次,集合里的元素没有顺序。 我们不会这样讲:我想要集合中的第三个元素,因为集合是没有顺序的。
事实上,这样的集合并不直接存在于编程语言中。然而,实际编程语言中的很多数据结构,就是在集合的基础上添加了一些规则形成的。
列表
列表(又称线性列表)的定义为:是一种数据项构成的有限序列,即按照一定的线性顺序,排列而成的数据项的集合。
列表的概念是在集合的特征上形成的,它具有顺序,且长度是可变的。你可以把它看作一张购物清单:
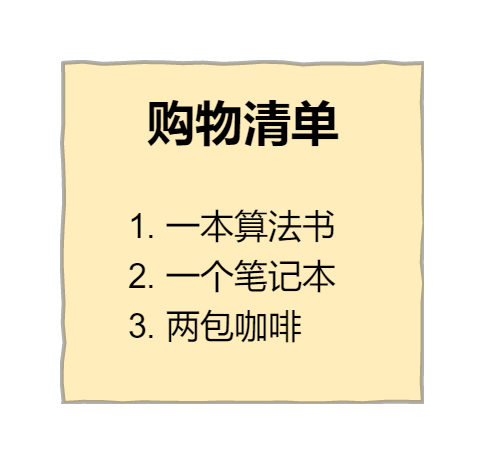
在这张清单中:
- 购物清单中的条目代表的类型可能不同,但是按照一定顺序进行了排列;
- 购物清单的长度是可变的,你可以向购物清单中增加、删除条目。
在编程语言中,列表最常见的表现形式有数组和链表,而我们熟悉的栈和队列则是两种特殊类型的列表。除此之外,向列表中添加、删除元素的具体实现方式会根据编程语言的不同而有所区分。
数组
数组是列表的实现方式之一,也是面试中经常涉及到的数据结构。
正如前面提到的,数组是列表的实现方式,它具有列表的特征,同时也具有自己的一些特征。然而,在具体的编程语言中,数组这个数据结构的实现方式具有一定差别。比如 C++ 和 Java 中,数组中的元素类型必须保持一致,而 Python 中则可以不同。Python 中的数组叫做 list,具有更多的高级功能。
那么如何从宏观上区分列表和数组呢?这里有一个重要的概念:索引。
首先,数组会用一些名为 索引 的数字来标识每项数据在数组中的位置,且在大多数编程语言中,索引是从 0 算起的。我们可以根据数组中的索引,快速访问数组中的元素。
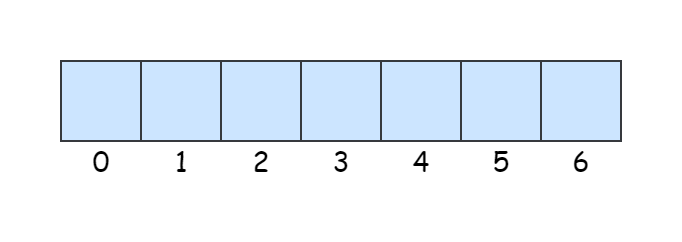
而列表中没有索引,这是数组与列表最大的不同点。
其次,数组中的元素在内存中是连续存储的,且每个元素占用相同大小的内存。要理解这一点,我们需要了解数组在内存中的存储方式,我们将在下一节中详细介绍。
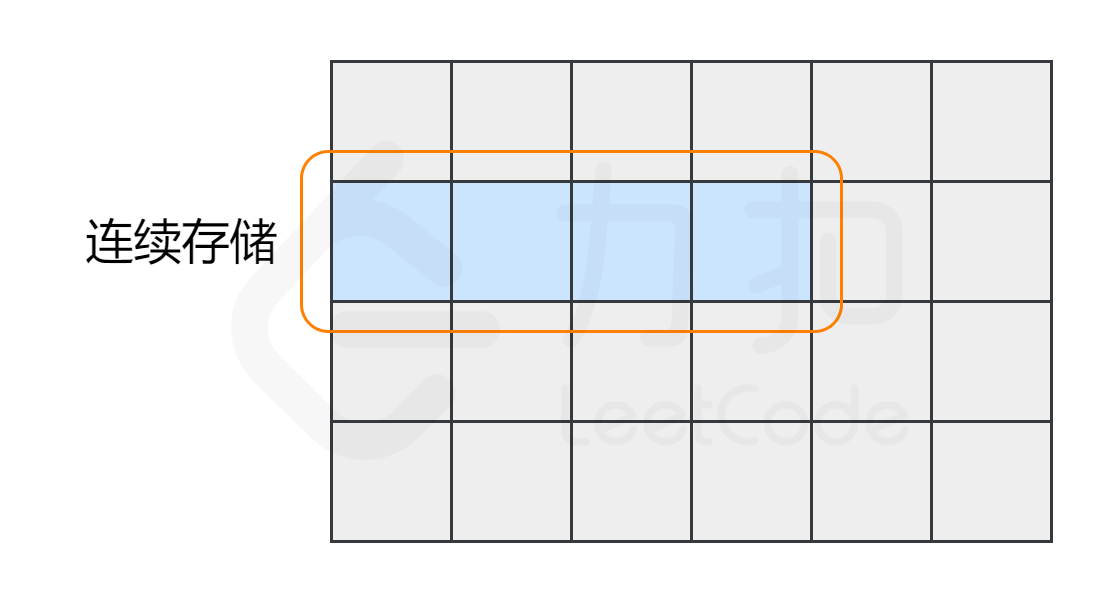
相反,列表中的元素在内存中可能彼此相邻,也可能不相邻。比如列表的另一种实现方式——链表,它的元素在内存中则不一定是连续的。
A 数组的操作
读取元素
读取数组中的元素,是通过访问索引的方式来读取的,索引一般从 0 开始。
在计算机中,内存可以看成一些已经排列号的格子,每个格子对应一个内存地址。一般情况下,数据会分散的存储在不同的格子中。
而对于数组,计算机会在内存中为其申请一段 连续 的空间,并且会记下索引为 0 处的内存地址。以数组 ["C","O","D","E","R"] 为例,它的各元素对应的索引以及内存地址如下图所示。
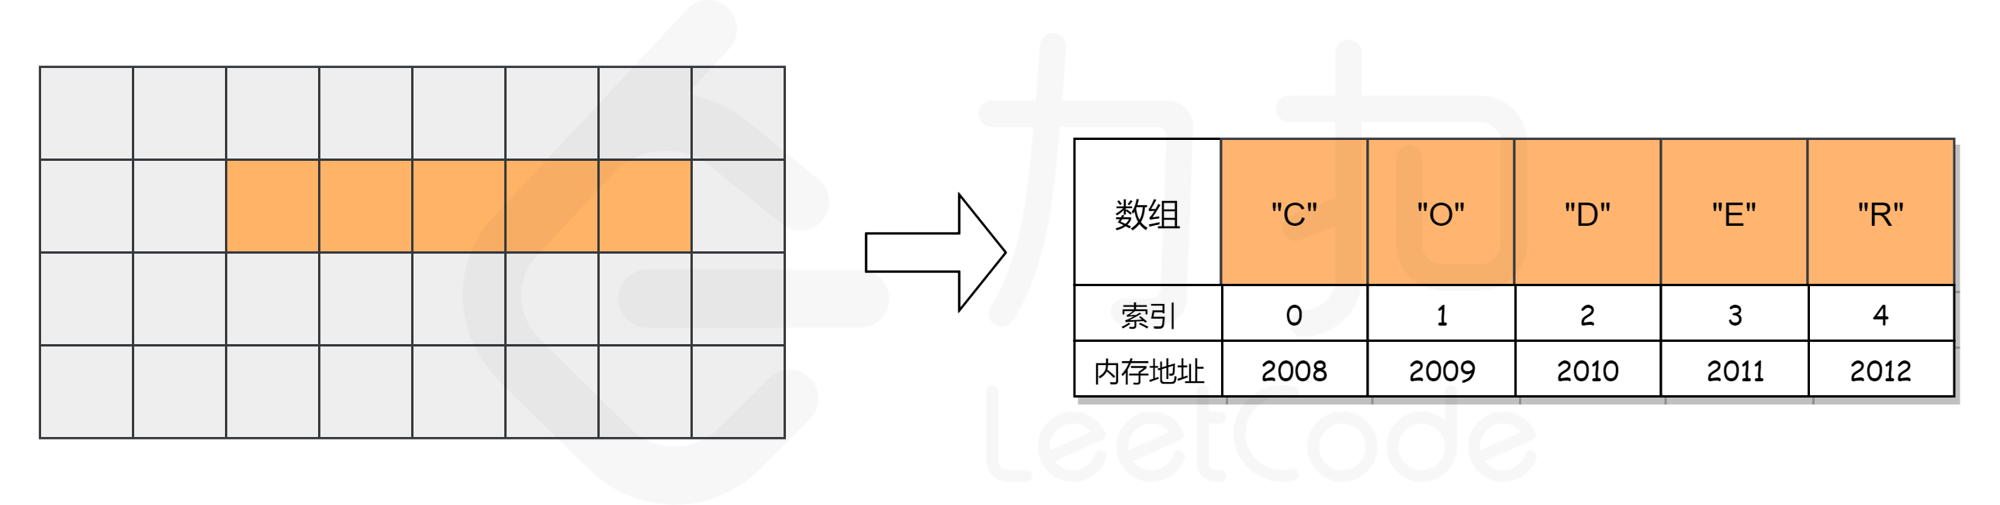
假如我们想要访问索引为 2 处的元素 "D" 时,计算机会进行以下计算:
- 找到该数组的索引
0的内存地址:2008; - 将内存地址加上索引值,作为目标元素的地址,即
2008 + 2 = 2010,对应的元素为"D",这时便找到了目标元素。
我们知道,计算内存地址这个过程是很快的,而我们一旦知道了内存地址就可以立即访问到该元素,因此它的时间复杂度是常数级别,为 O(1)。
查找元素
假如我们对数组中包含哪些元素并不了解,只是想知道其中是否含有元素 "E",数组会如何查找元素 "E" 呢?
与读取元素类似,由于我们只保存了索引为 0 处的内存地址,因此在查找元素时,只需从数组开头逐步向后查找就可以了。如果数组中的某个元素为目标元素,则停止查找;否则继续搜索直到到达数组的末尾。
我们发现,最坏情况下,搜索的元素为 "R",或者数组中不包含目标元素时,我们需要查找 n 次,n 为数组的长度,因此查找元素的时间复杂度为 O(N),N。
插入元素
假如我们想在原有的数组中再插入一个元素 "S” 呢?
如果要将该元素插入到数组的末尾,只需要一步。即计算机通过数组的长度和位置计算出即将插入元素的内存地址,然后将该元素插入到指定位置即可。
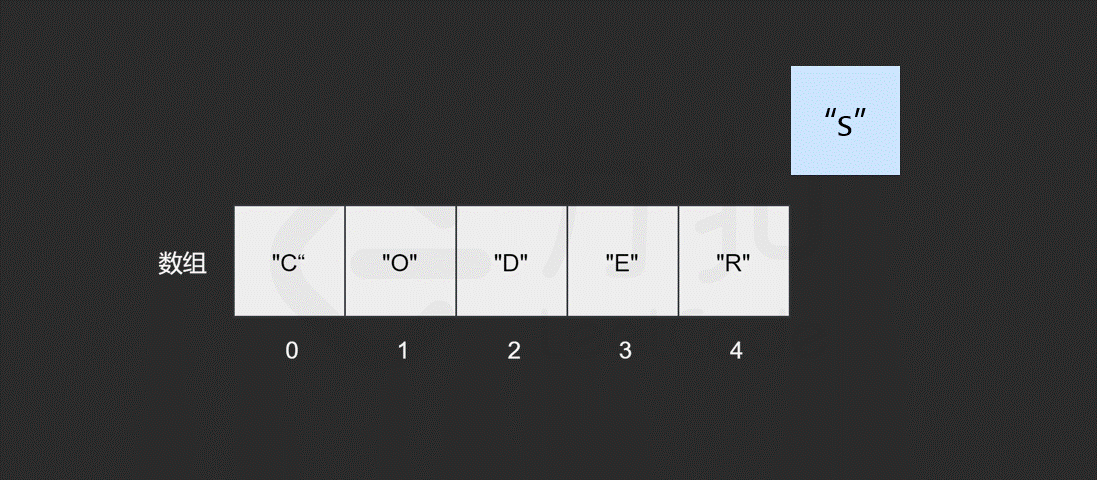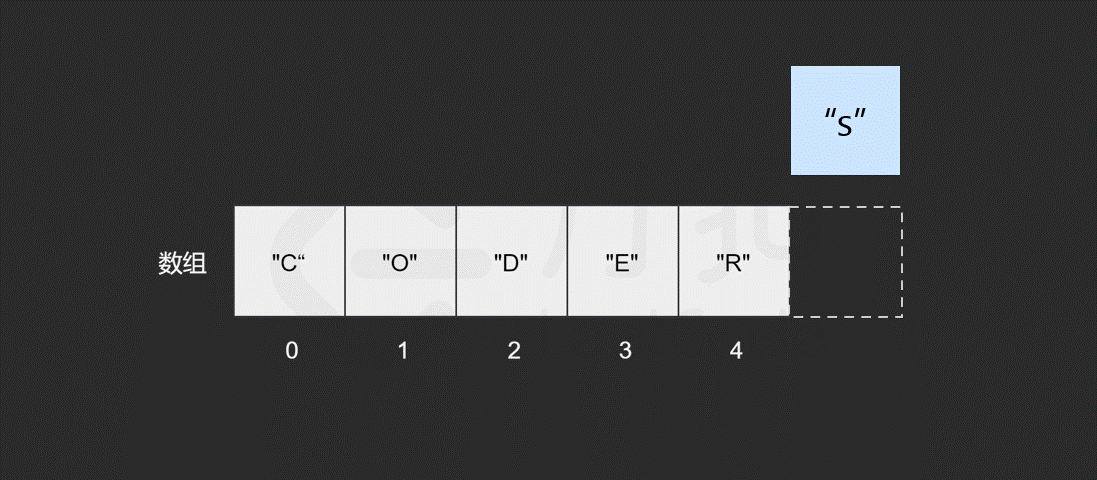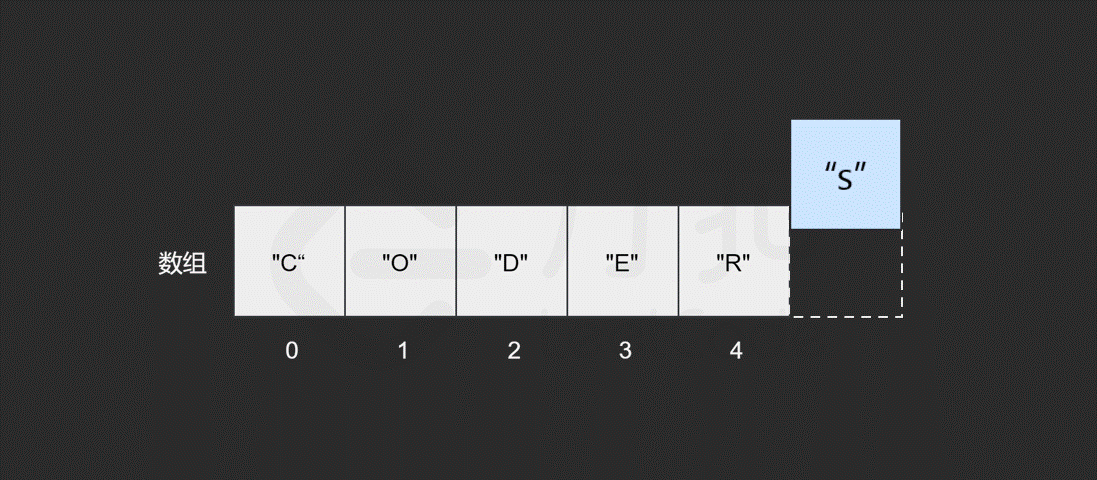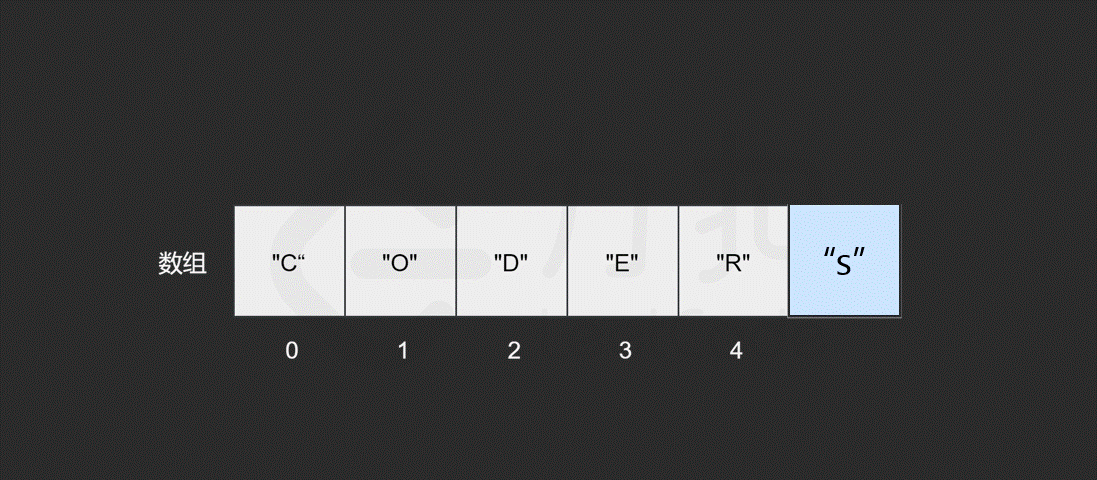
然而,如果要将该元素插入到数组中的其他位置,则会有所区别,这时我们首先需要为该元素所要插入的位置 腾出 空间,然后进行插入操作。比如,我们想要在索引 2 处插入 "S"。
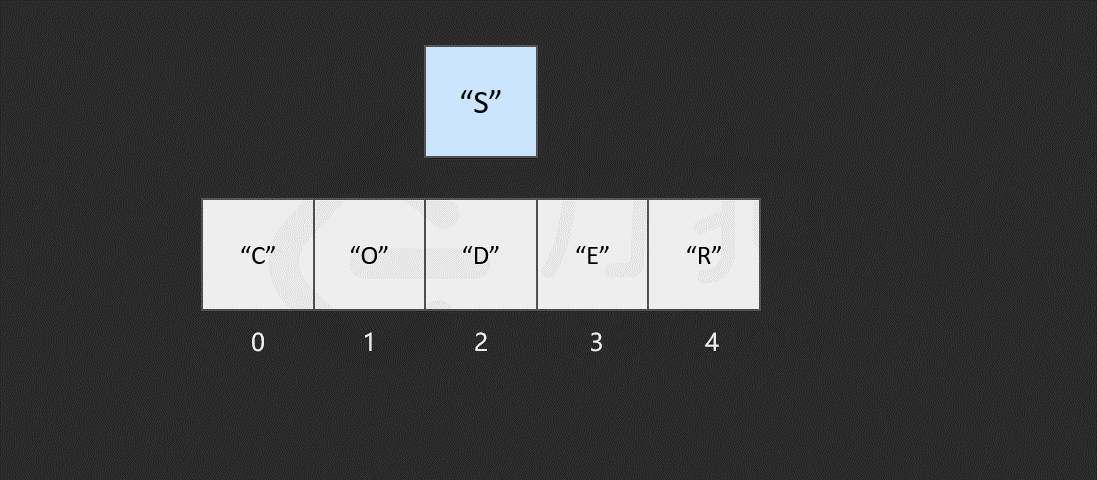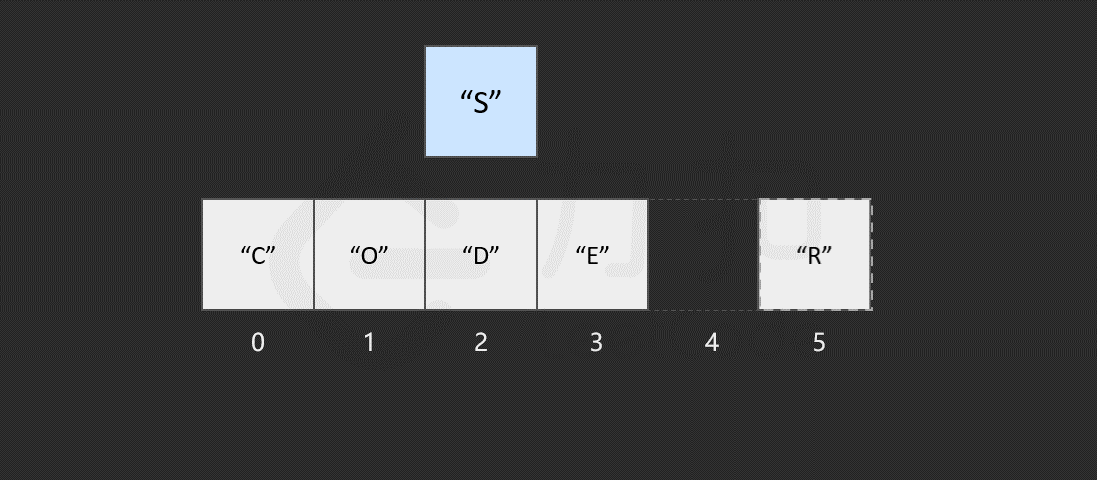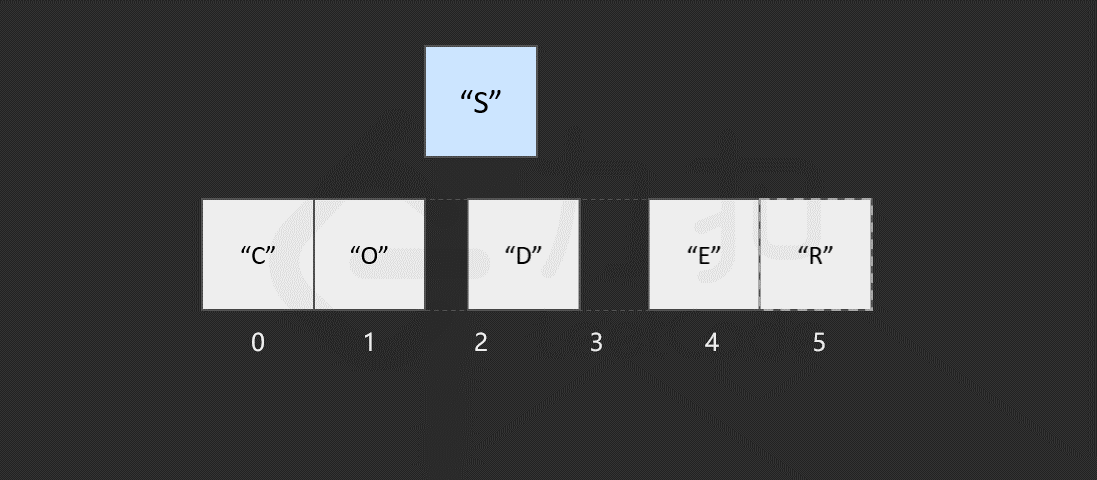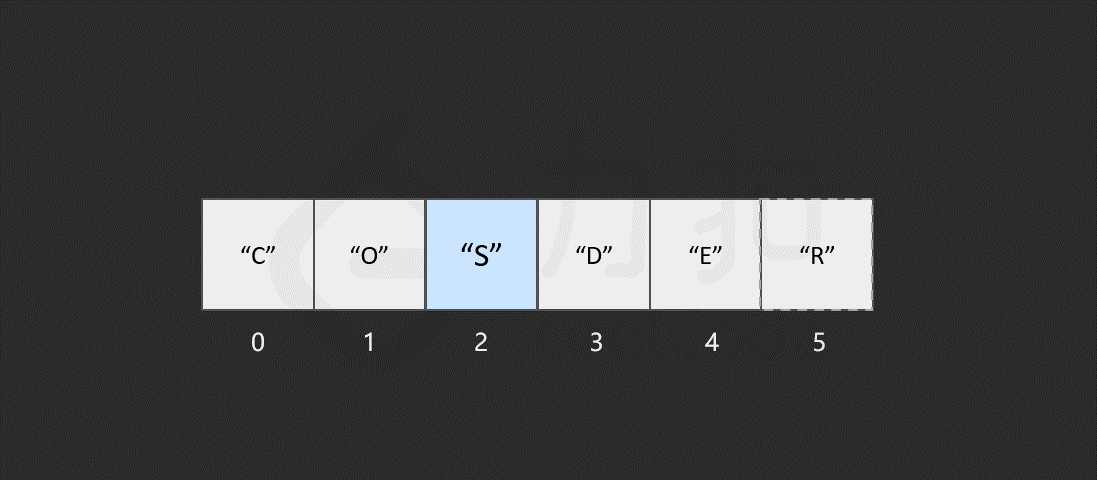
我们发现,如果需要频繁地对数组元素进行插入操作,会造成时间的浪费。事实上,另一种数据结构,即链表可以有效解决这个问题。
删除元素
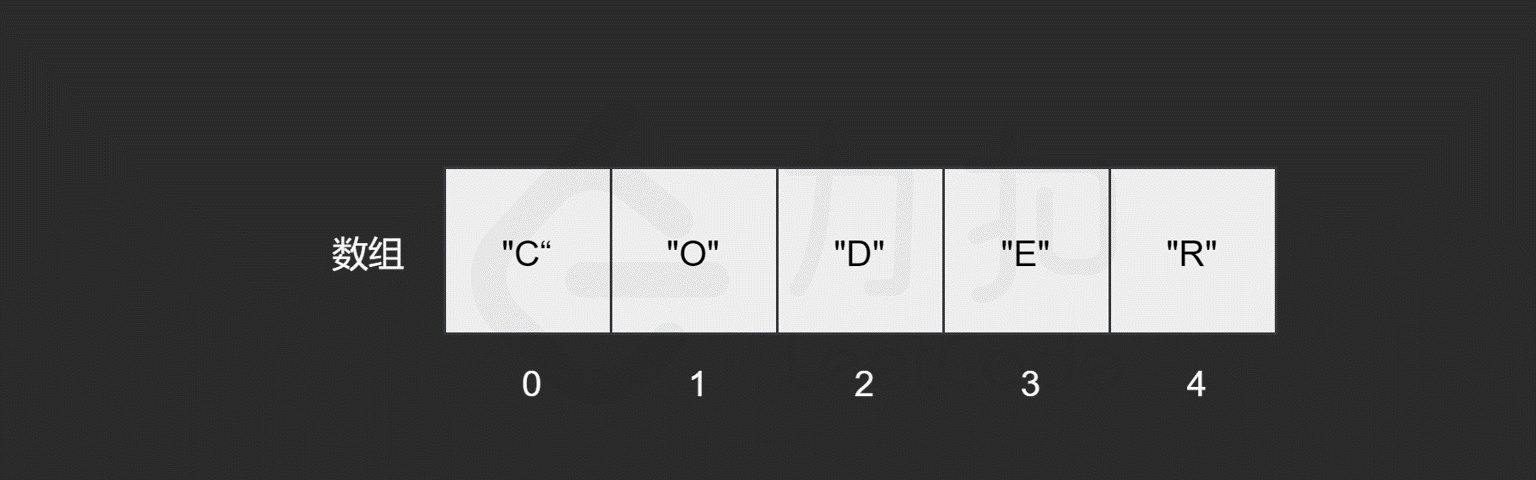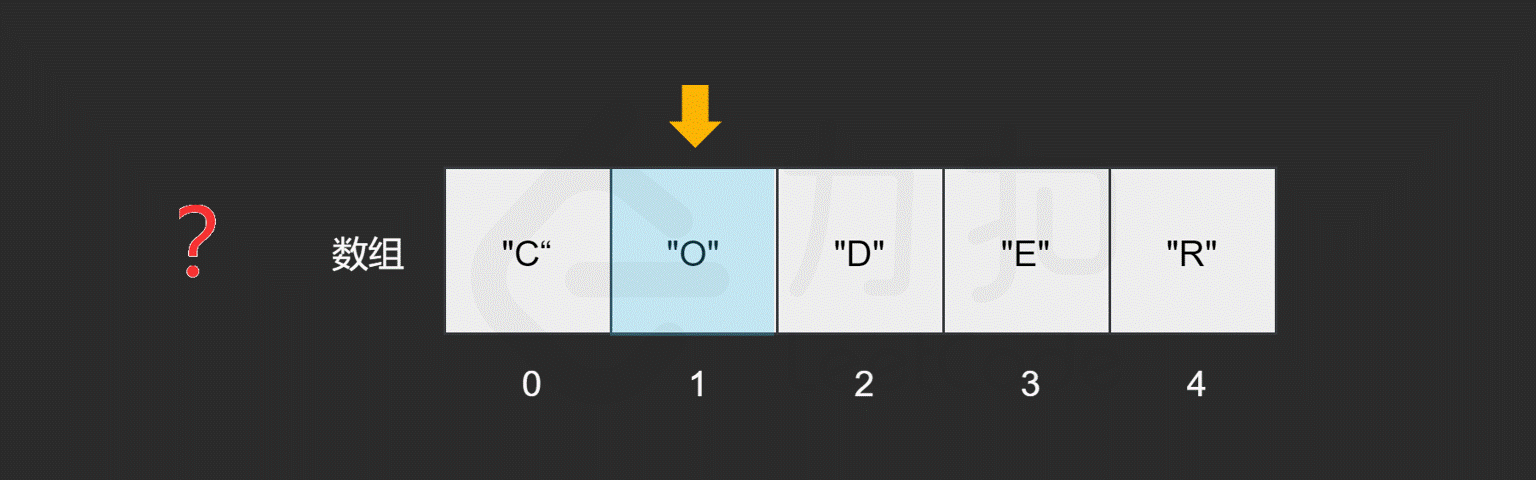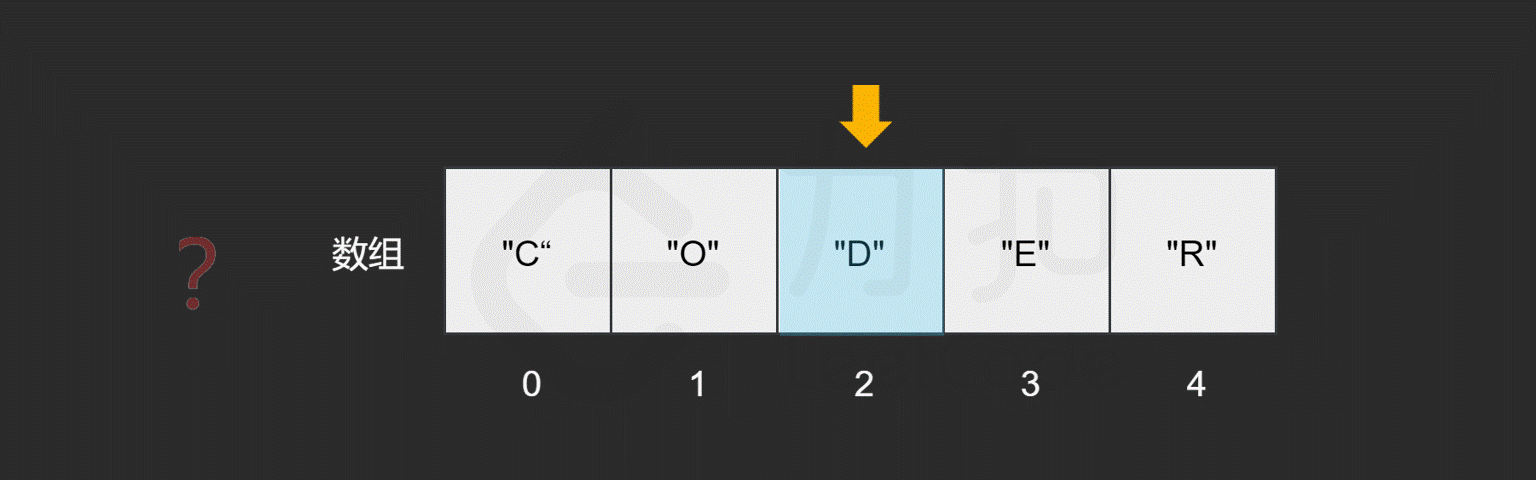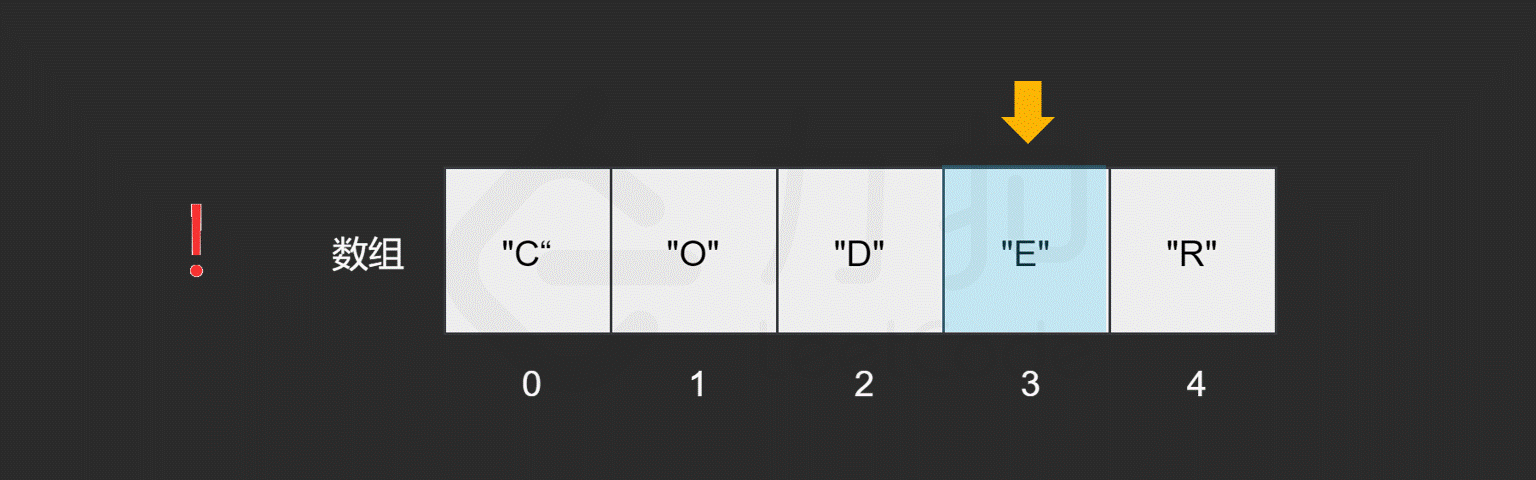
删除元素与插入元素的操作类似,当我们删除掉数组中的某个元素后,数组中会留下 空缺 的位置,而数组中的元素在内存中是连续的,这就使得后面的元素需对该位置进行 填补 操作。
以删除索引 1 中的元素 "O" 为例,具体过程如图所示。
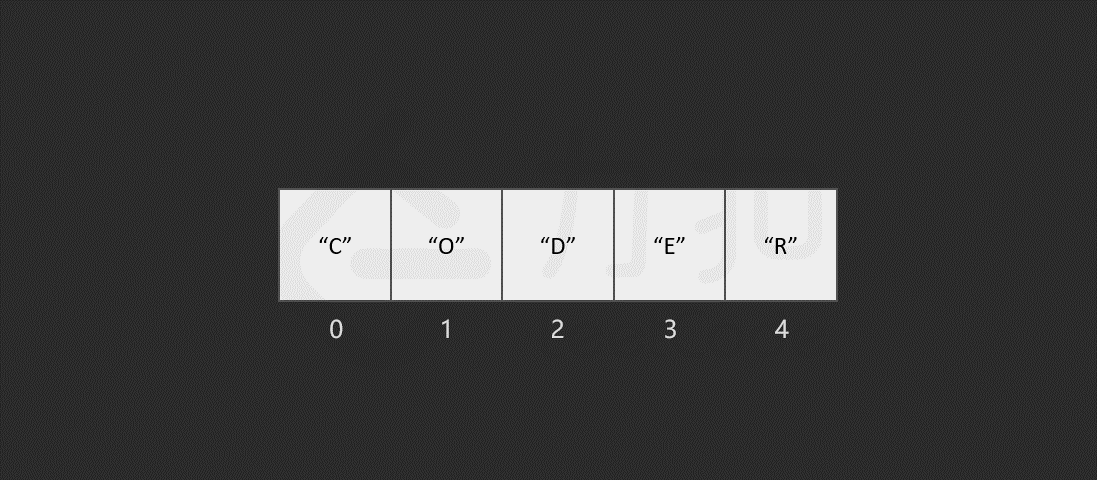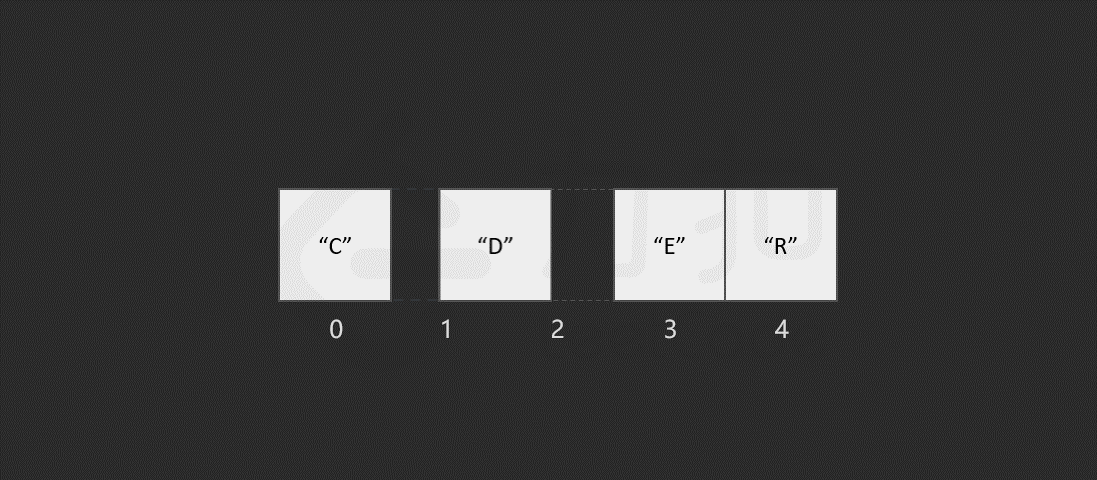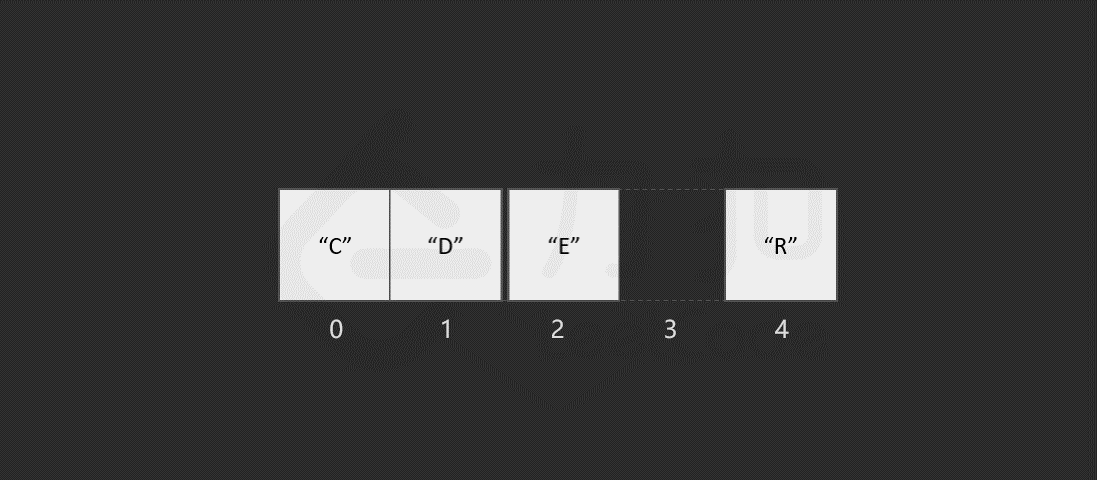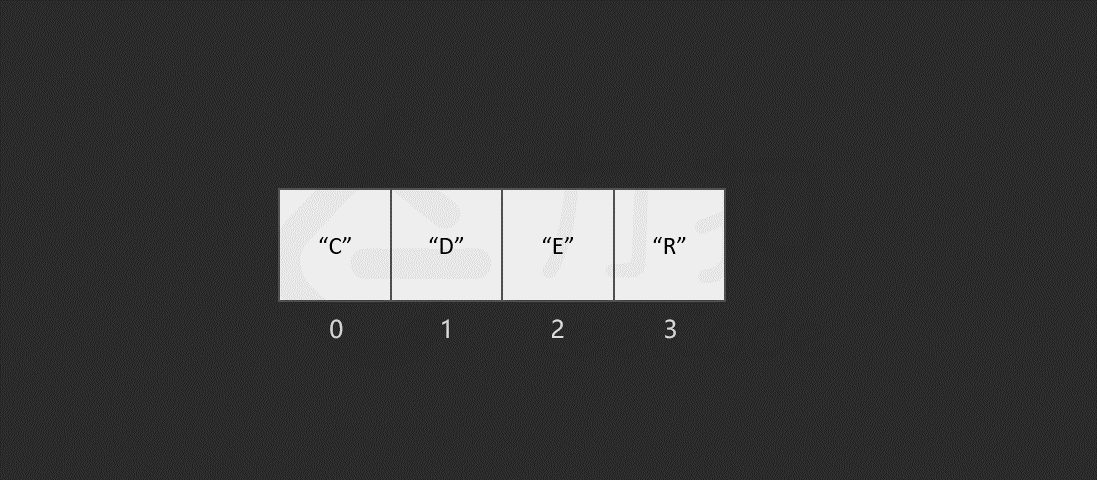
当数组的长度为 n 时,最坏情况下,我们删除第一个元素,共需要的步骤数为 1 + (n - 1) = n 步,其中,1 为删除操作,n - 1 为移动其余元素的步骤数。删除操作具有线性时间复杂度,即时间复杂度为 O(N),N 为数组的长度。
LC 寻找数组的中心索引
给你一个整数数组 nums ,请计算数组的 中心下标 。
数组 中心下标 是数组的一个下标,其左侧所有元素相加的和等于右侧所有元素相加的和。
如果中心下标位于数组最左端,那么左侧数之和视为 0 ,因为在下标的左侧不存在元素。这一点对于中心下标位于数组最右端同样适用。
如果数组有多个中心下标,应该返回 最靠近左边 的那一个。如果数组不存在中心下标,返回 -1 。
示例 1:
 输入:nums = [1, 7, 3, 6, 5, 6]
 输出:3
 解释:
 中心下标是 3 。
 左侧数之和 sum = nums[0] + nums[1] + nums[2] = 1 + 7 + 3 = 11 ,
 右侧数之和 sum = nums[4] + nums[5] = 5 + 6 = 11 ,二者相等。
示例 2:
 输入:nums = [2, 1, -1]
 输出:0
 解释:
 中心下标是 0 。
 左侧数之和 sum = 0 ,(下标 0 左侧不存在元素),
右侧数之和 sum = nums[1] + nums[2] = 1 + -1 = 0 。提示:
1 <= nums.length <= 104-1000 <= nums[i] <= 1000
题解:
 /**
  * @param {number[]} nums
  * @return {number}
  */
 var pivotIndex = function(nums) {
     const total = nums.reduce((a,b) => a + b, 0);
     let lsum = 0;
     for (i = 0; i < nums.length; i++) {
         if ( 2*lsum + nums[i] === total) {
             return i;
         }
         lsum += nums[i];
     }
     return -1;
};计算数组内元素,计算方法为内部函数方法。
LC 搜索插入位置
给定一个排序数组和一个目标值,在数组中找到目标值,并返回其索引。如果目标值不存在于数组中,返回它将会被按顺序插入的位置。
请必须使用时间复杂度为 O(log n) 的算法。
示例 1:
 输入: nums = [1,3,5,6], target = 5
 输出: 2
示例 2:
 输入: nums = [1,3,5,6], target = 2
 输出: 1
示例 3:
 输入: nums = [1,3,5,6], target = 7
输出: 4提示:
- 1 <= nums.length <= 104
- -104 <= nums[i] <= 104
nums为 无重复元素 的 升序 排列数组- -104 <= target <= 104
题解:
 /**
  * @param {number[]} nums
  * @param {number} target
  * @return {number}
  */
 var searchInsert = function(nums, target) {
     const n = nums.length;
     let left = 0, right = n - 1, ans = n;
     while (left <= right) {
         let mid = ((right - left) >> 1) + left;
 //         (a << b) === Math.ceil(a*(2**b));
 //      (a >> b) === Math.floor(a/(2**b));
         // let mid = left + (right - left) / 2;
         if (target <= nums[mid]) {
             ans = mid;
             right = mid - 1;
         } else {
             left = mid + 1;
         }
     }
     return ans;
 };
JavaScript 位运算符
位运算符工作于32位的数字上。任何数字操作都将转换为32位。结果会转换为 JavaScript 数字。菜鸟教程
| 运算符 | 描述 | 例子 | 类似于 | 结果 | 十进制 |
|---|---|---|---|---|---|
| & | AND | x = 5 & 1 | 0101 & 0001 | 0001 | 1 |
| | | OR | x = 5 | 1 | 0101 | 0001 | 0101 | 5 |
| ~ | 取反 | x = ~ 5 | ~0101 | 1010 | -6 |
| ^ | 异或 | x = 5 ^ 1 | 0101 ^ 0001 | 0100 | 4 |
| << | 左移 | x = 5 << 1 | 0101 << 1 | 1010 | 10 |
| >> | 右移 | x = 5 >> 1 | 0101 >> 1 | 0010 | 2 |
LC 合并区间
以数组 intervals 表示若干个区间的集合,其中单个区间为 intervals[i] = [starti, endi] 。请你合并所有重叠的区间,并返回 一个不重叠的区间数组,该数组需恰好覆盖输入中的所有区间 。
示例 1:
 输入:intervals = [[1,3],[2,6],[8,10],[15,18]]
 输出:[[1,6],[8,10],[15,18]]
 解释:区间 [1,3] 和 [2,6] 重叠, 将它们合并为 [1,6].
示例 2:
 输入:intervals = [[1,4],[4,5]]
 输出:[[1,5]]
解释:区间 [1,4] 和 [4,5] 可被视为重叠区间。提示:
- 1 <= intervals.length <= 104
- intervals[i].length == 2
- 0 <= starti <= endi <= 104
题解:
 /**
  * @param {number[][]} intervals 设为 [[1,3],[2,6],[8,10],[15,18]]
  * @return {number[][]}
  */
 var merge = function(intervals) {
     // 对于左边界从小到大排序
     intervals.sort((a,b) => a[0] - b[0]);
     const result = [];
     let prev = intervals[0]; // prev = [1,3]
     // 合并重叠区间
     for(let i = 1; i < intervals.length; i++) {
         let cur = intervals[i];
         if(prev[1] < cur[0]) {  // i = 1 时,prev[1]=3,cur[0]=2
           // 若前一个数组的尾部小于后一个数组的头部,则不需合并,将前一个数组push进结果数组
           result.push(prev);
           prev = cur;
         }
         else {
           prev[1] = Math.max(prev[1], cur[1]);
         }
     }
     // 将最后一个区间加入 result 集合中
     result.push(prev);
     return result;
 };
sort() 方法用于对数组的元素进行排序。排序顺序可以是字母或数字,并按升序或降序。默认排序顺序为按字母升序。
语法: array.sort(sortfunction) sortfunction 可选,规定排序顺序,必须是函数
例:
//数字排序(数字和升序):
var points = [40,100,1,5,25,10];
points.sort(function(a,b){return a-b});
// 输出结果:1,5,10,25,40,100
// 数字排序(数字和降序):
var points = [40,100,1,5,25,10];
points.sort(function(a,b){return b-a});
// 输出结果:100,40,25,10,5,1二维数组简介
A 二维数组简介
二维数组是一种结构较为特殊的数组,只是将数组中的每个元素变成了一维数组。
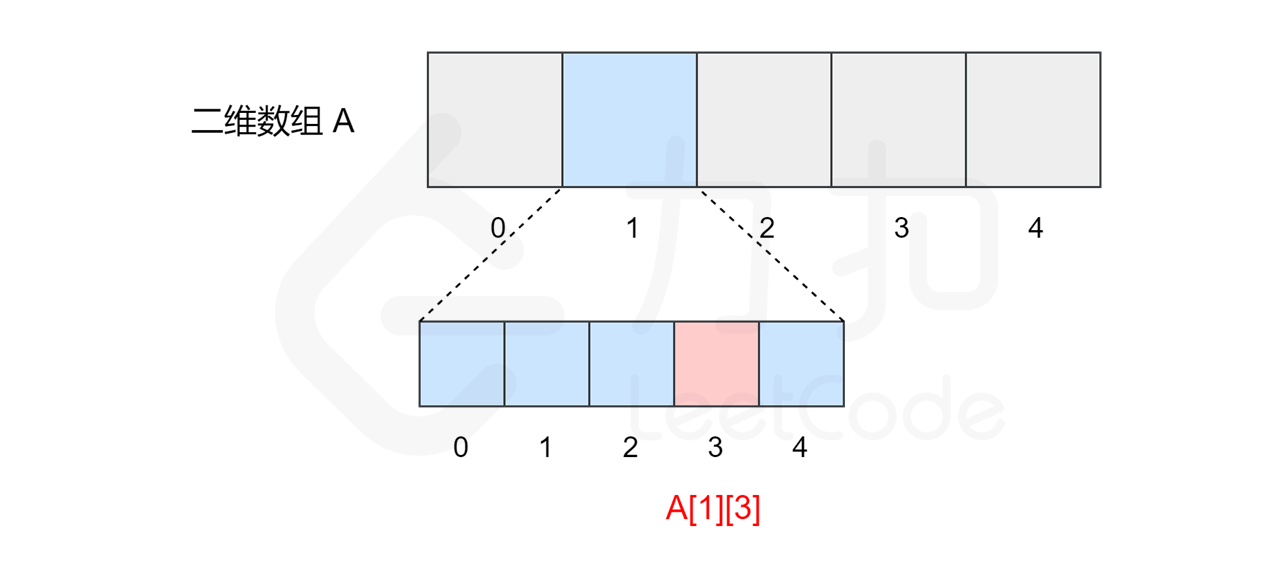
所以二维数组的本质上仍然是一个一维数组,内部的一维数组仍然从索引 0 开始,我们可以将它看作一个矩阵,并处理矩阵的相关问题。
示例
类似一维数组,对于一个二维数组 A = [[1, 2, 3, 4],[2, 4, 5, 6],[1, 4, 6, 8]],计算机同样会在内存中申请一段 连续 的空间,并记录第一行数组的索引位置,即 A[0][0] 的内存地址,它的索引与内存地址的关系如下图所示。
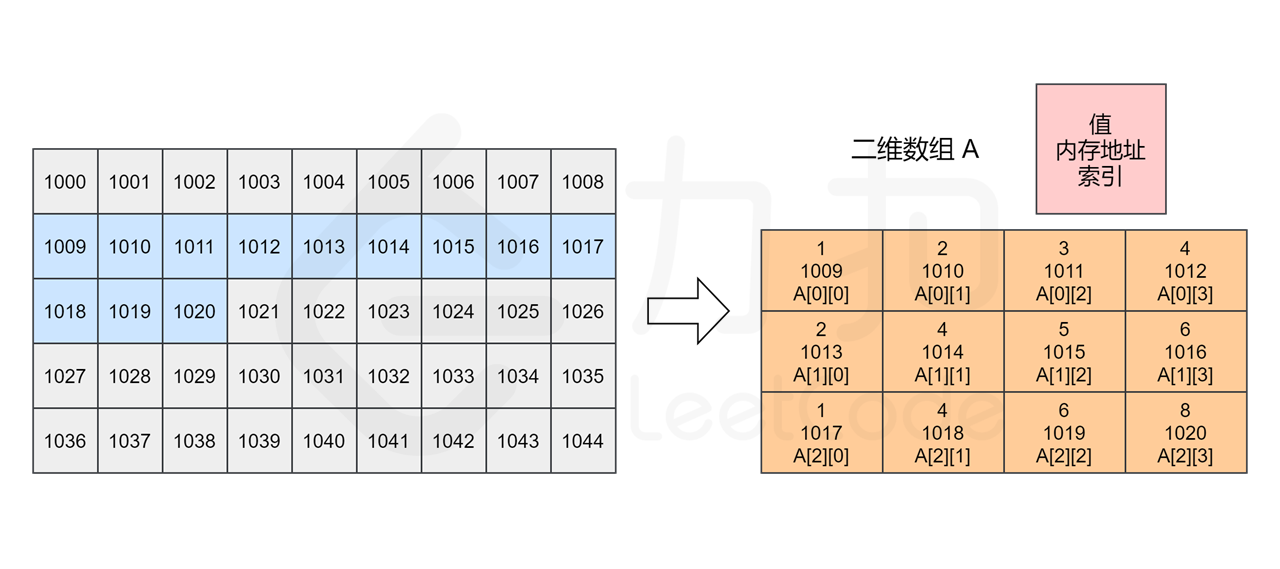
注意,实际数组中的元素由于类型的不同会占用不同的字节数,因此每个方格地址之间的差值可能不为 1。
实际题目中,往往使用二维数组处理矩阵类相关问题,包括矩阵旋转、对角线遍历,以及对子矩阵的操作等。
LC 旋转矩阵
给你一幅由 N × N 矩阵表示的图像,其中每个像素的大小为 4 字节。请你设计一种算法,将图像旋转 90 度。
不占用额外内存空间能否做到?
示例 1:
给定 matrix =
[
[1,2,3],
[4,5,6],
[7,8,9]
],
原地旋转输入矩阵,使其变为:
[
[7,4,1],
[8,5,2],
[9,6,3]
]示例 2:
给定 matrix =
[
[ 5, 1, 9,11],
[ 2, 4, 8,10],
[13, 3, 6, 7],
[15,14,12,16]
],
原地旋转输入矩阵,使其变为:
[
[15,13, 2, 5],
[14, 3, 4, 1],
[12, 6, 8, 9],
[16, 7,10,11]
]题解:
 /**
  * @param {number[][]} matrix
  * @return {void} Do not return anything, modify matrix in-place instead.
  */
 var rotate = function(matrix) {
     const n = matrix.length;
     // 创建新数组
     const matrix_new = new Array(n).fill(0).map(() => new Array(n).fill(0));
     for (let i = 0; i < n; i++) { // 旋转
         for (let j = 0; j < n; j++) {
             matrix_new[j][n - i - 1] = matrix[i][j];
         }
     }
     for (let i = 0; i < n; i++) { // 将结果数组复制到原数组
         for (let j = 0; j < n; j++) {
             matrix[i][j] = matrix_new[i][j];
         }
     }
};fill() 方法用于将一个固定值替换数组的元素。
语法:array.fill(value, start, end)
value:必须,填充的值;
start:可选,开始填充位置;
end:可选,停止填充位置;
例:
 var fruits = ["Banana", "Orange", "Apple", "Mango"];
 fruits.fill("Runoob", 2, 4);
 // 输出结果:Banana,Orange,Runoob,Runoob
map() 方法返回一个新数组,数组中的元素为原始数组元素调用函数处理后的值。
map() 方法按照原始数组元素顺序依次处理元素。
语法:array.map(function(currentValue,index,arr), thisValue)
currentValue:必须,当前元素的值
index:可选,当前元素的索引值
arr:可选,当前元素属于的数组对象
LC 零矩阵
编写一种算法,若M × N矩阵中某个元素为0,则将其所在的行与列清零。
示例 1:
 输入:
 [
   [1,1,1],
   [1,0,1],
   [1,1,1]
 ]
 输出:
 [
   [1,0,1],
   [0,0,0],
   [1,0,1]
 ]
示例 2:
 输入:
 [
   [0,1,2,0],
   [3,4,5,2],
   [1,3,1,5]
 ]
 输出:
 [
   [0,0,0,0],
   [0,4,5,0],
   [0,3,1,0]
 ]
题解
方法一:使用标记数组
我们可以用两个标记数组分别记录每一行和每一列是否有零出现。
具体地,我们首先遍历该数组一次,如果某个元素为 0,那么就将该元素所在的行和列所对应标记数组的位置置为 true。最后我们再次遍历该数组,用标记数组更新原数组即可。
 /**
  * @param {number[][]} matrix
  * @return {void} Do not return anything, modify matrix in-place instead.
  */
 var setZeroes = function(matrix) {
     const n = matrix.length, m = matrix[0].length;
     let col = new Array(n).fill(false);
     let row = new Array(m).fill(false);
     for ( let i = 0; i < n; i++ ) {
         for ( let j = 0; j < m; j++) {
             if (matrix[i][j] == 0) {
                 col[i] = row[j] = true;
             }
         }
     }
     for ( let i = 0; i < n; i++ ) {
         for(let j = 0; j < m; j++) {
             if ( col[i] || row[j] ) {
                 matrix[i][j] = 0;
             }
         }
     }
 };
复杂度分析
- 时间复杂度:
O(mn),其中 m 是矩阵的行数,n 是矩阵的列数。我们至多只需要遍历该矩阵两次。 - 空间复杂度:
O(m+n),其中 m 是矩阵的行数,n 是矩阵的列数。我们需要分别记录每一行或每一列是否有零出现。
方法二:使用两个标记变量
我们可以用矩阵的第一行和第一列代替方法一中的两个标记数组,以达到 O(1) 的额外空间。但这样会导致原数组的第一行和第一列被修改,无法记录它们是否原本包含 0。因此我们需要额外使用两个标记变量分别记录第一行和第一列是否原本包含 0。
因为这道题中为了避免O(mn)空间复杂度的二维布尔数组的开辟(解一),因此在判断过程中,如果某个位置 arr[i][j] = 0 ,可以给它所在行的第一列 arr[i][0] 和所在列的第一行 a[0][j] 设置标记(事实上这个标记为也不一定就得是第 0 行,只要标记一下就行,但 0 比较符合大众思维),来说明这一行和这一列要被 “0化”,而如果这样一来,可能就会让原来第 0 行或者第 0 列的 0 被覆盖掉,假如原来第 0 行或第 0 列中有 0,那么第 0 行和第 0 列都要被 “0化”,因此对于这样的情况,需要额外设置两个 boolean 值,来判断第 0 行或者第 0 列中是否有 0,做到不开辟另外的空间。
 var setZeroes = function(matrix) {
     const m = matrix.length, n = matrix[0].length;
     let flagCol0 = false, flagRow0 = false;
     for (let i = 0; i < m; i++) { // 判断第一行是否有 0
         if (matrix[i][0] === 0) {
             flagCol0 = true;
         }
     }
     for (let j = 0; j < n; j++) { // 判断第一列是否有 0
         if (matrix[0][j] === 0) {
             flagRow0 = true;
         }
     }
     for (let i = 1; i < m; i++) { // 除了第一列第一行,若出现 0,则设所在第一行列为 0(标记)
         for (let j = 1; j < n; j++) {
             if (matrix[i][j] === 0) {
                 matrix[i][0] = matrix[0][j] = 0;
             }
         }
     }
     for (let i = 1; i < m; i++) { // 将出现 0 的行列(除了第一行列且已标记)变 0
         for (let j = 1; j < n; j++) {
             if (matrix[i][0] === 0 || matrix[0][j] === 0) {
                 matrix[i][j] = 0;
             }
         }
     }
     // 根据标记前判断,将第一行列变 0
     if (flagCol0) {
         for (let i = 0; i < m; i++) {
             matrix[i][0] = 0;
         }
     }
     if (flagRow0) {
         for (let j = 0; j < n; j++) {
             matrix[0][j] = 0;
         }
     }
 };
复杂度分析
- 时间复杂度:
O(mn),其中 m 是矩阵的行数,n 是矩阵的列数。我们至多只需要遍历该矩阵两次 - 空间复杂度:
O(1),我们只需要常数空间存储若干变量。
LC 对角线遍历
给你一个大小为 m x n 的矩阵 mat ,请以对角线遍历的顺序,用一个数组返回这个矩阵中的所有元素。
示例 1:
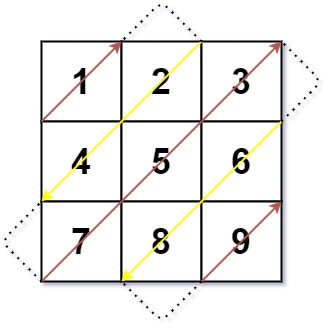
 输入:mat = [[1,2,3],[4,5,6],[7,8,9]]
 输出:[1,2,4,7,5,3,6,8,9]
示例 2:
 输入:mat = [[1,2],[3,4]]
 输出:[1,2,3,4]
提示:
m == mat.lengthn == mat[i].length1 <= m, n <= 1041 <= m * n <= 104- -105 <=
mat[i][j]<= 105
题解
 /**
  * @param {number[][]} mat
  * @return {number[]}
  */
 var findDiagonalOrder = function(mat) {
     const m = mat.length, n = mat[0].length; // 定义 m 为行数,n 为列数
     let pos = 0; // 新数组存储开始位置
     let resArr = new Array(m*n).fill(0); // 新建数组
     for (let i = 0; i  < m + n - 1; i++) { // 共有 m+n-1 条对角线
         if (i % 2 === 1) { // 当对角线为奇数时,为从上往下遍历
             let x = i < n ? 0 : i - n + 1; // 判断对角线起始位置
             let y = i < n ? i : n - 1;
             while (x < m && y >= 0) { // 遍历边界限制
                 resArr[pos] = mat[x][y];
                 pos++;
                 x++;
                 y--;
             }
         }
         else { // 对角线偶数时,为从下往上遍历
             let x = i < m ? i : m - 1;
             let y = i < m ? 0 : i - m + 1;
             while ( y < n && x >= 0) {
                 resArr[pos] = mat[x][y];
                 pos++;
                 x--;
                 y++;
             }
         }
     }
     return resArr;
 };
复杂度分析
- 时间复杂度:
O(m×n),其中 mm 为矩阵行的数量,n 为矩阵列的数量。需要遍历一遍矩阵中的所有元素,需要的时间复杂度为O(m×n)。 - 空间复杂度:
O(1)。除返回值外不需要额外的空间。
字符串简介
正如我们在概述中提到的那样,字符串是一个由字符构成的数组。
本章节中,我们将深入研究字符串。完成本章后,你将:
- 熟悉字符串中的 基本操作,尤其是在数组中没有的独特操作
- 理解不同 比较 函数之间的区别
- 理解字符串 是否可变 以及导致连接过程中出现的问题
- 能够解决与字符串相关的基本问题,如排序、子串、字符串匹配等
A 字符串简介
为何单独讨论字符串类型
我们知道,字符串与数组有很多相似之处,比如使用 名称[下标] 来得到一个字符。那么我们为什么要单独讨论字符串呢?原因主要有:
- 字符串的基本操作对象通常是字符串整体或者其子串例如有这样一个字符串序列:
I like leetcode现在你想把这句话反向输出,可能会变成这样:edocteel ekil I这是我们想要的结果吗?你可能会回答不是,因为它没有任何意义。我们通常希望单词仍然维持原来的顺序,这样反向输出之后就是:Leetcode like I这样的结果对于我们来讲是不是更满意呢?维持单词本身的顺序使得我们方便进行更多操作,这里的每个单词就叫做字符串的「子串」,通常,我们的操作对象更多情况下是这些子串。 - 字符串操作比其他数据类型更复杂(例如比较、连接操作)对于不同的编程语言,字符串的某些操作会有所不同。下面我们将从字符串的「比较」和「连接」操作两个方面分别进行讲解。
比较函数
字符串有它自己的比较函数(我们将在下面的代码中向你展示比较函数的用法)。
然而,存在这样一个问题:
我们可以用 “==” 来比较两个字符串吗?
这取决于下面这个问题的答案:
我们使用的语言是否支持运算符重载?
- 如果答案是
yes(例如 C++、Python)。我们可以使用==来比较两个字符串; - 如果答案是
no(例如 Java),我们可能无法使用==来比较两个字符串。当我们使用==时,它实际上会比较这两个对象是否是同一个对象。
你可以运行下面的例子来比较结果:
 // "static void main" must be defined in a public class.
 public class Main {
     public static void main(String[] args) {
         // initialize
         String s1 = "Hello World";
         System.out.println("s1 is \"" + s1 + "\"");
         String s2 = s1;
         System.out.println("s2 is another reference to s1.");
         String s3 = new String(s1);
         System.out.println("s3 is a copy of s1.");
         // compare using '=='
         System.out.println("Compared by '==':");
         // true since string is immutable and s1 is binded to "Hello World"
         System.out.println("s1 and \"Hello World\": " + (s1 == "Hello World"));
         // true since s1 and s2 is the reference of the same object
         System.out.println("s1 and s2: " + (s1 == s2));
         // false since s3 is refered to another new object
         System.out.println("s1 and s3: " + (s1 == s3));
         // compare using 'equals'
         System.out.println("Compared by 'equals':");
         System.out.println("s1 and \"Hello World\": " + s1.equals("Hello World"));
         System.out.println("s1 and s2: " + s1.equals(s2));
         System.out.println("s1 and s3: " + s1.equals(s3));
         // compare using 'compareTo'
         System.out.println("Compared by 'compareTo':");
         System.out.println("s1 and \"Hello World\": " + (s1.compareTo("Hello World") == 0));
         System.out.println("s1 and s2: " + (s1.compareTo(s2) == 0));
         System.out.println("s1 and s3: " + (s1.compareTo(s3) == 0));
     }
 }
对于不同的编程语言中,字符串可能是可变的,也可能是不可变的。不可变意味着一旦字符串被初始化,你就无法改变它的内容。
- 在某些语言(如 C ++)中,字符串是可变的。 也就是说,你可以像在数组中那样修改字符串。
- 在其他一些语言(如 Java、Python)中,字符串是不可变的。
在 字符串不可变 的语言中,进行字符串的连接操作则会带来一些问题。
显然,不可变字符串无法被修改。哪怕你只是想修改其中的一个字符,也必须创建一个新的字符串。我们以 Java 为例,来看一个在 for 循环中重复进行字符串连接的例子:
 // "static void main" must be defined in a public class.
 public class Main {
     public static void main(String[] args) {
         String s = "";
         int n = 10000;
         for (int i = 0; i < n; i++) {
             s += "hello";
         }
     }
 }
我们发现在 C++ 中,进行字符串连接并没有明显的性能影响。
然而,对于 Java来说,由于字符串是不可变的,因此在连接时首先为新字符串分配足够的空间,复制旧字符串中的内容并附加到新字符串。
因此,总时间复杂度将是:
5+5×2+5×3+…+5×n=5×(1+2+3+…+n)=5×n×(n+1)/2 即 O(N2)
针对 Java 中出现的此问题,我们提供了以下解决方案:
- 如果你确实希望你的字符串是可变的,则可以使用
toCharArray将其转换为字符数组。 - 如果你经常必须连接字符串,最好使用一些其他的数据结构,如
StringBuilder。
LC 最长公共前缀
编写一个函数来查找字符串数组中的最长公共前缀。
如果不存在公共前缀,返回空字符串 ""。
示例 1:
 输入:strs = ["flower","flow","flight"]
 输出:"fl"
示例 2:
 输入:strs = ["dog","racecar","car"]
 输出:""
解释:输入不存在公共前缀。提示:
1 <= strs.length <= 2000 <= strs[i].length <= 200strs[i]仅由小写英文字母组成
题解
 var longestCommonPrefix = function(strs) {
     var re = '';
     if (!strs.length) return re;
     for (var j=0;j<strs[0].length;j++){//第j位
         for (var i=1;i<strs.length;i++){//第i个
             if (strs[i][j]!=strs[0][j]) return re
         }
         re += strs[0][j];
     }
     return re;
 };
通过逐个比较第 i 个字符串的第 j 位来确定最长公共前缀
LC 最长回文子串
给你一个字符串 s,找到 s 中最长的回文子串。
示例 1:
 输入:s = "babad"
 输出:"bab"
 解释:"aba" 同样是符合题意的答案。
示例 2:
 输入:s = "cbbd"
 输出:"bb"
提示
1 <= s.length <= 1000s仅由数字和英文字母组成
题解
 /**
  * @param {string} s
  * @return {string}
  */
 var longestPalindrome = function (s) {
     let size = s.length
     console.log(size);
     let start = 0
     let len = 0 //回文字串长度
     // 奇数长度的回文字串
     for (let i = 0; i < size; i++) {
         let left = i - 1
         let right = i + 1
         while (left >= 0 && right < size && s[left] == s[right]) { // 判断回文字串中心
             left--
             right++
         }
         if (right - left - 1 > len) { // 确定回文字串长度以及开始位置
             start = left + 1
             len = right - left - 1
         }
     }
     // 偶数长度的回文字串
     for (let i = 0; i < size; i++) {
         let left = i
         let right = i + 1
         while (left >= 0 && right < size && s[left] == s[right]) {
             left--
             right++
         }
         if (right - left - 1 > len) {
             start = left + 1
             len = right - left - 1
         }
     }
     return s.slice(start, start + len)
 };
slice() 方法可提取字符串的某个部分,并以新的字符串返回被提取的部分。
语法:stringObject.slice(start,end)
LC 翻转字符串例的单词
给你一个字符串 s ,请你反转字符串中 单词 的顺序。
单词 是由非空格字符组成的字符串。s 中使用至少一个空格将字符串中的 单词 分隔开。
返回 单词 顺序颠倒且 单词 之间用单个空格连接的结果字符串。
注意:输入字符串 s 中可能会存在前导空格、尾随空格或者单词间的多个空格。返回的结果字符串中,单词间应当仅用单个空格分隔,且不包含任何额外的空格。
示例 1:
 输入:s = "the sky is blue"
 输出:"blue is sky the"
示例 2:
 输入:s = "  hello world  "
 输出:"world hello"
 解释:反转后的字符串中不能存在前导空格和尾随空格。
示例 3:
 输入:s = "a good   example"
 输出:"example good a"
解释:如果两个单词间有多余的空格,反转后的字符串需要将单词间的空格减少到仅有一个。提示:
- 1 <= s.length <= 104
s包含英文大小写字母、数字和空格' 's中 至少存在一个 单词
进阶:如果字符串在你使用的编程语言中是一种可变数据类型,请尝试使用 O(1) 额外空间复杂度的 原地 解法。
题解
 /**
  * @param {string} s
  * @return {string}
  */
 var reverseWords = function(s) {
     return s.trim().split(/\s+/).reverse().join(' ');
 };
trim() 方法用于删除字符串的头尾空白符,空白符包括:空格、制表符 tab、换行符等其他空白符等。
trim() 方法不会改变原始字符串。
语法:string.trim()
split() 方法用于把一个字符串分割成字符串数组。
语法:string.split(separator,limit)
separator:可选。字符串或正则表达式,从该参数指定的地方分割
limit:可选。该参数可指定返回的数组的最大长度。
reverse() 方法用于颠倒数组中元素的顺序。
语法:array.reverse()
join() 方法
join() 方法用于把数组中的所有元素转换一个字符串。
元素是通过指定的分隔符进行分隔的。
语法:array.join(separator)
separator:可选。指定要使用的分隔符。如果省略该参数,则使用逗号作为分隔符。
A (选)字符串匹配算法:KMP
Knuth–Morris–Pratt(KMP)算法是一种改进的字符串匹配算法,它的核心是利用匹配失败后的信息,尽量减少模式串与主串的匹配次数以达到快速匹配的目的。它的时间复杂度是 O(m+n)。
情境 1
现在有两道字符串 S 和 T,你需要 判断 T 是否可以匹配成为 S 的子串。
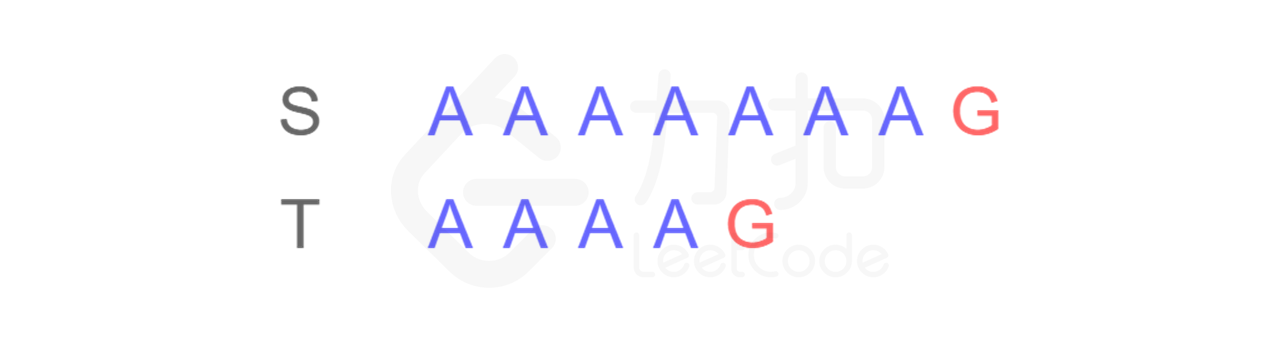
你可能会凭肉眼立即得出结论:是匹配的。可是计算机没有眼睛,只能对每个字符进行逐一比较。
对于计算机来讲,首先它会从左边第一个位置开始进行逐一比较:
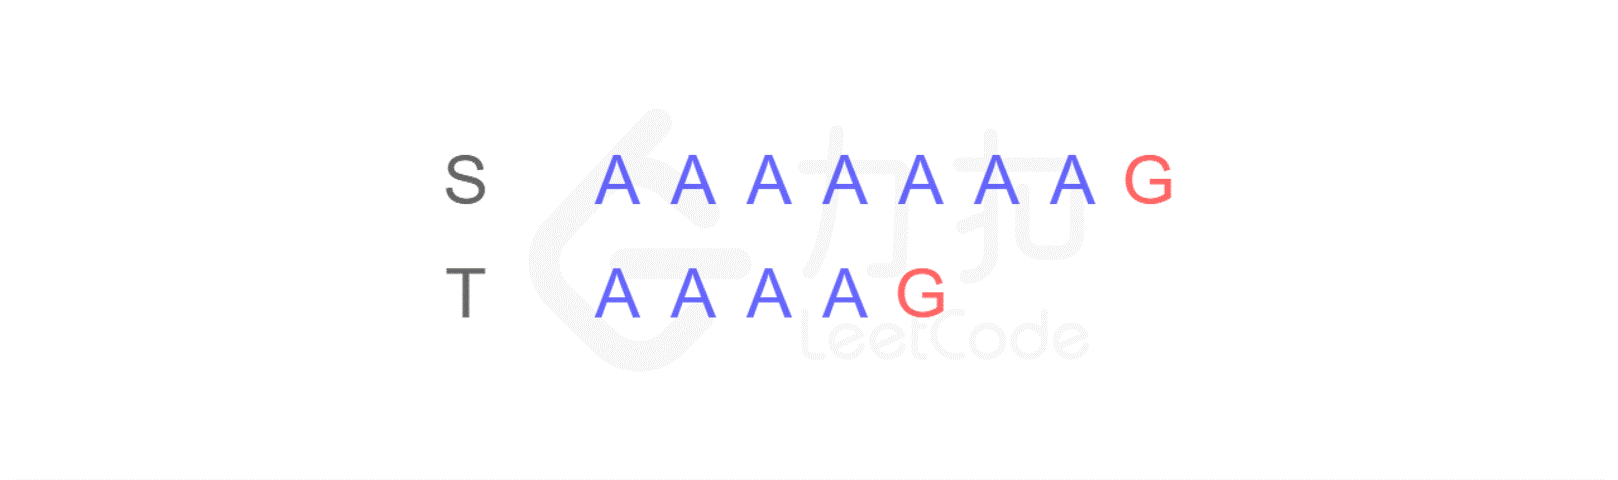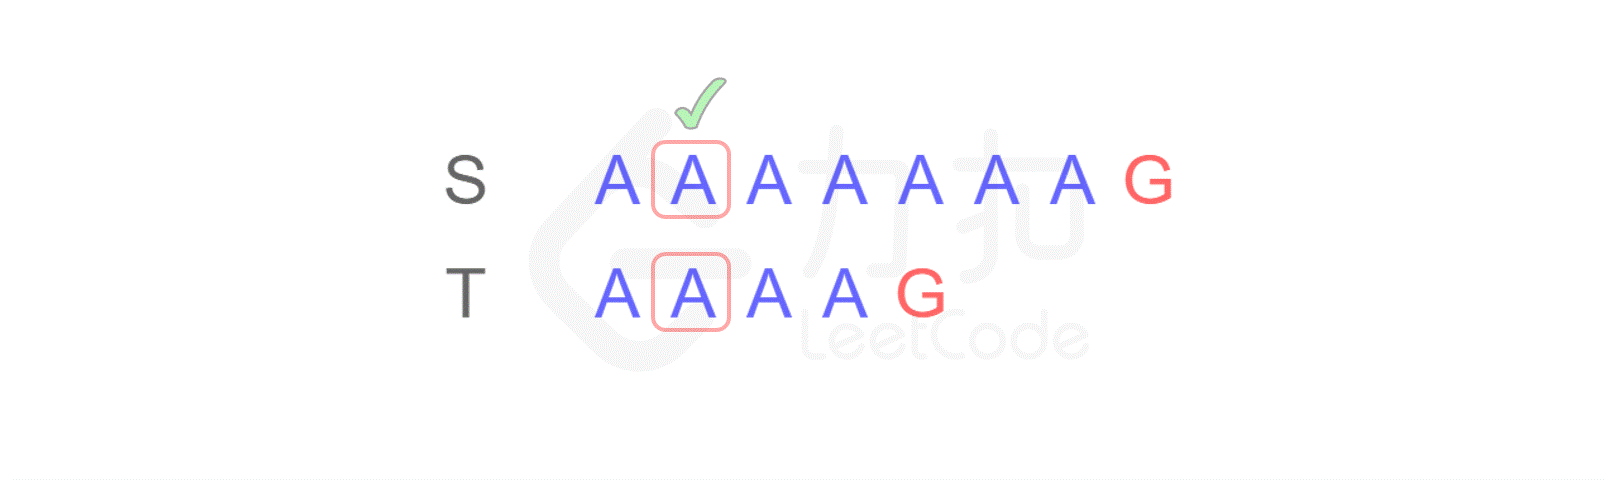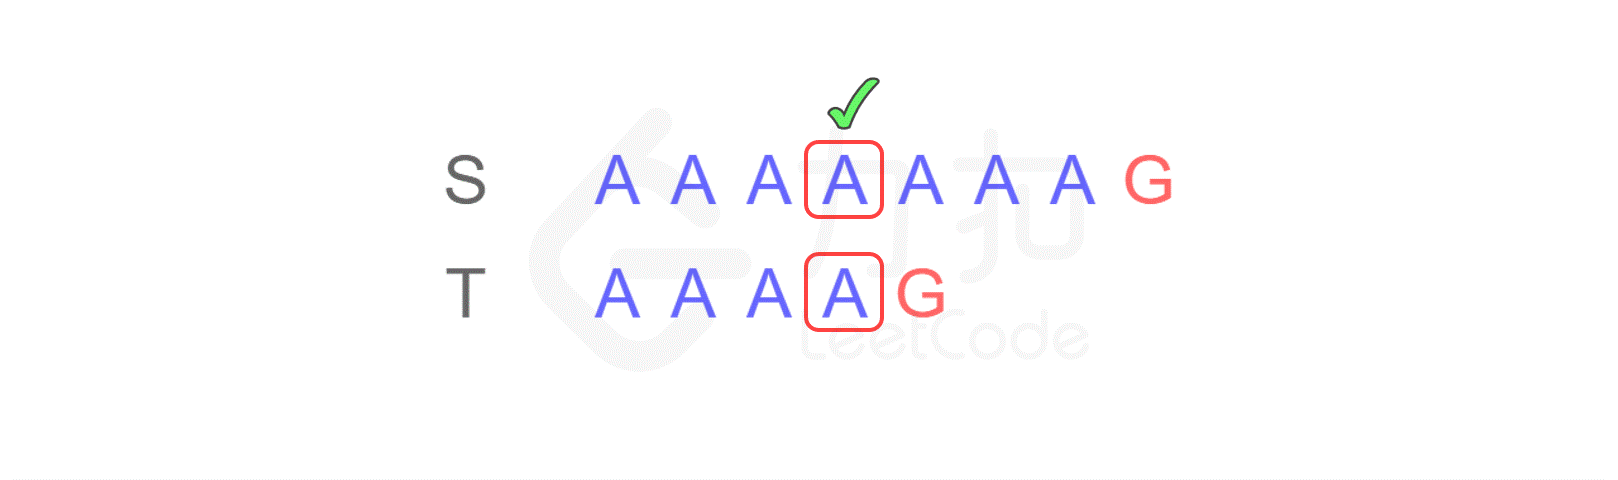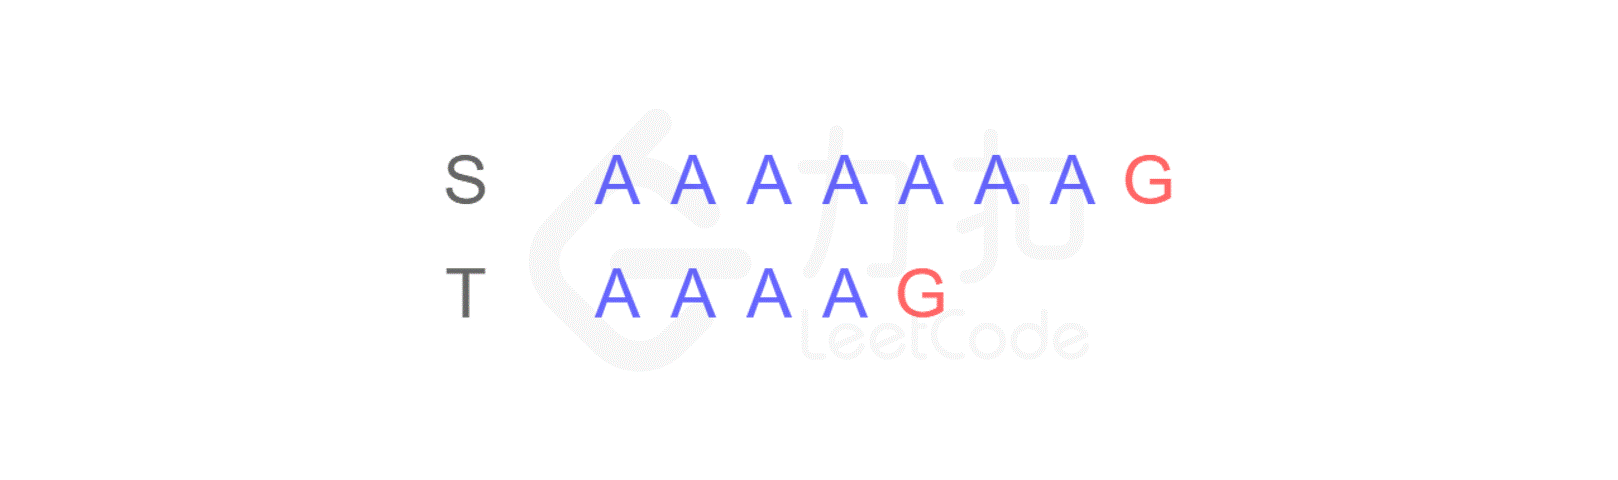
这样,当匹配到 T 的最后一个字符时,发现不匹配,于是从 S 的第二个字符开始重新比较:
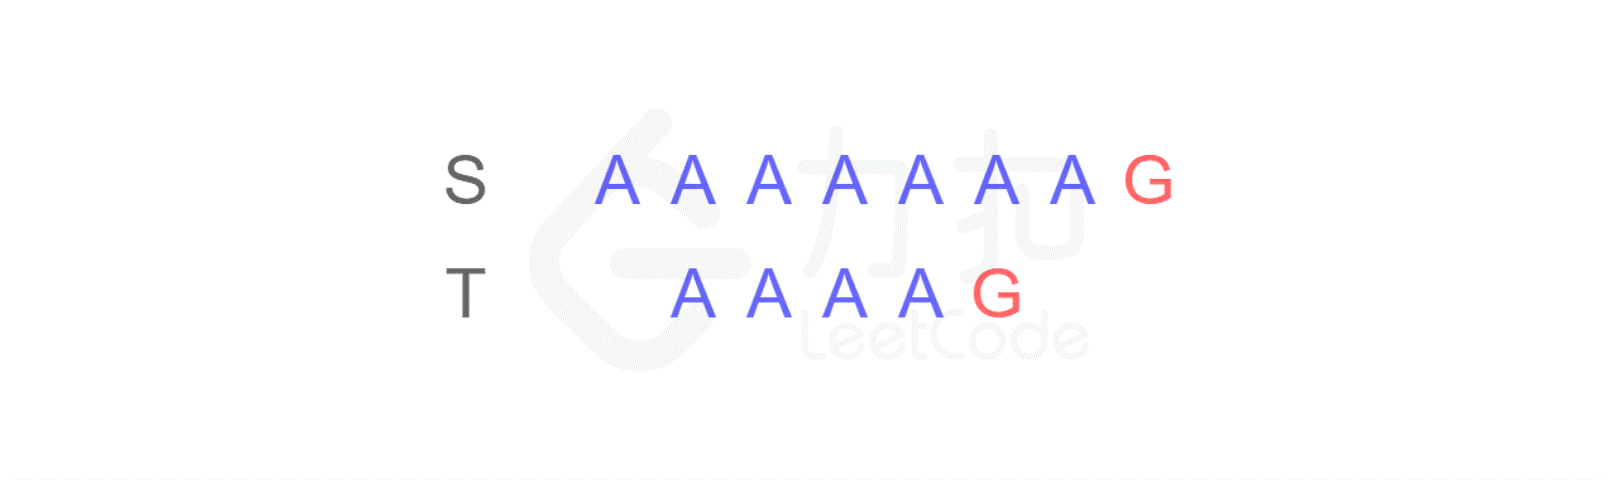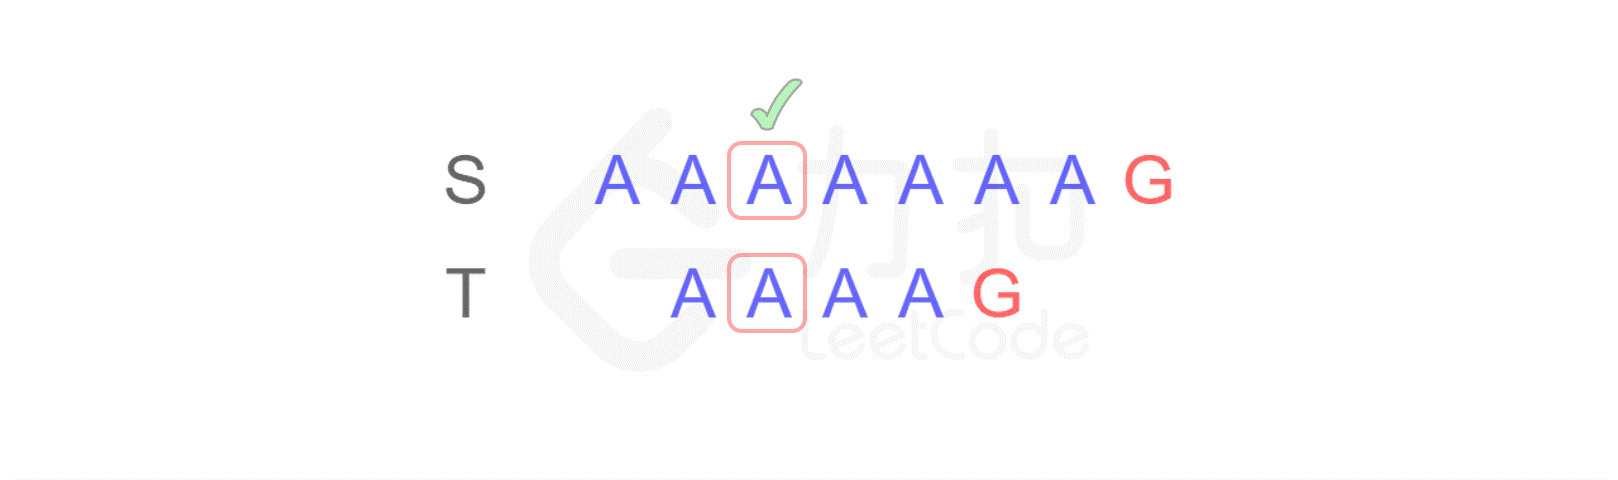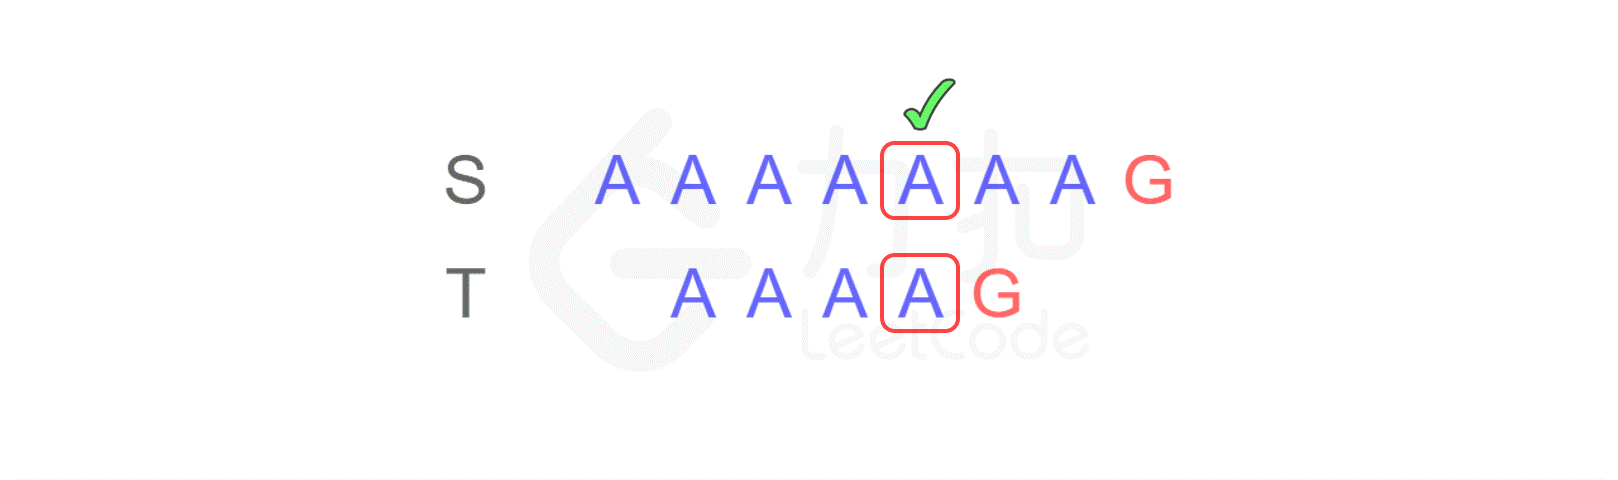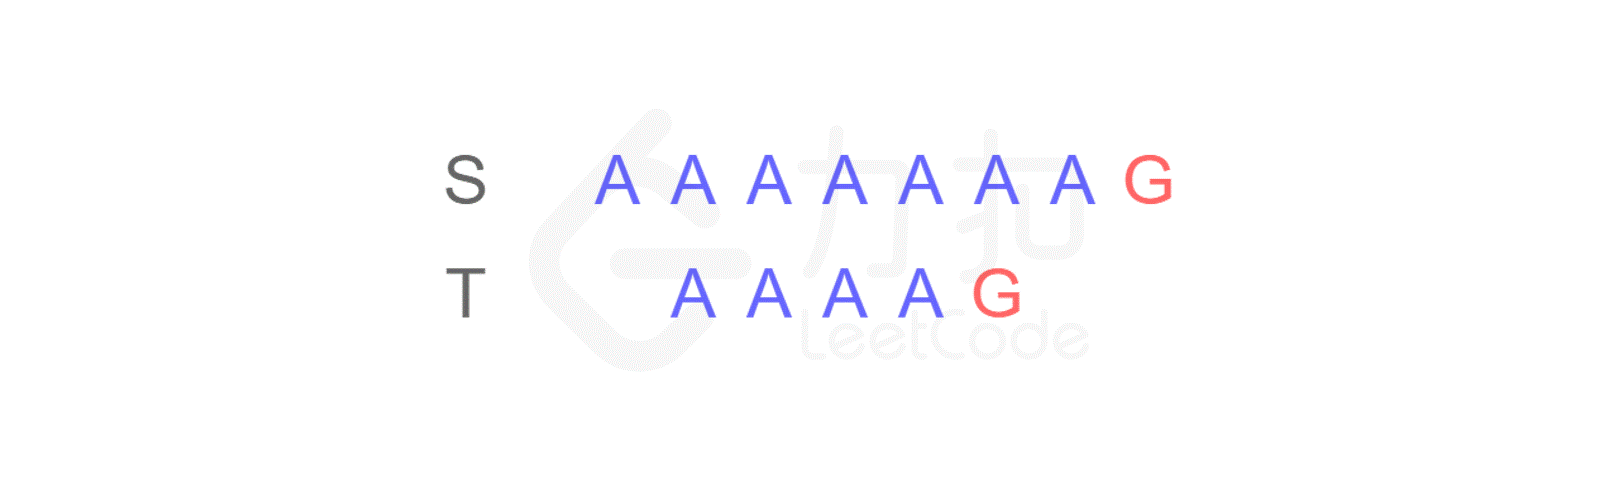
仍然不匹配,再次将 T 与 S 的第三个字符开始匹配……不断重复以上步骤,直到从 S 的第四个字符开始时,最终得出结论:S 与 T 是匹配的。
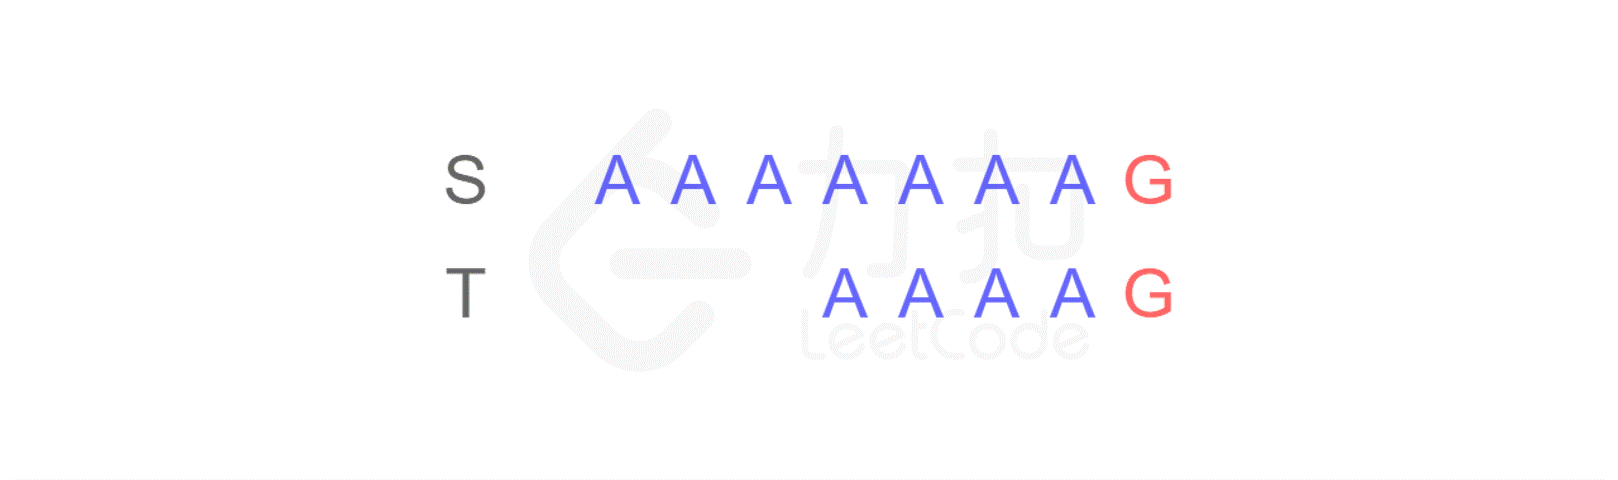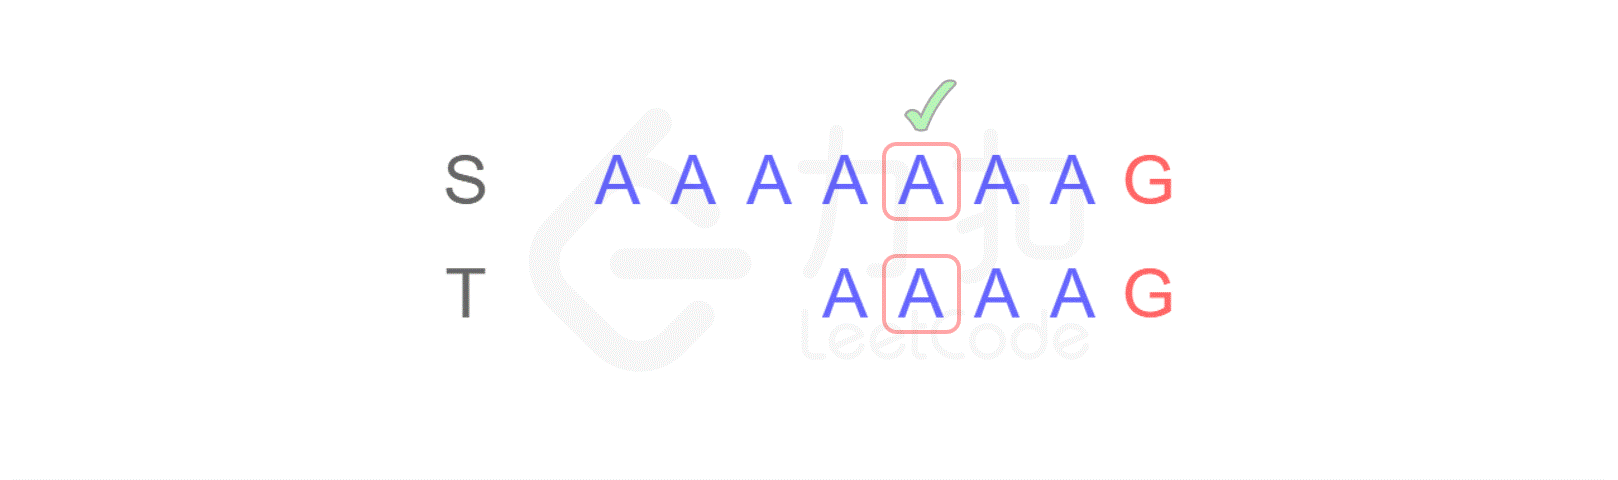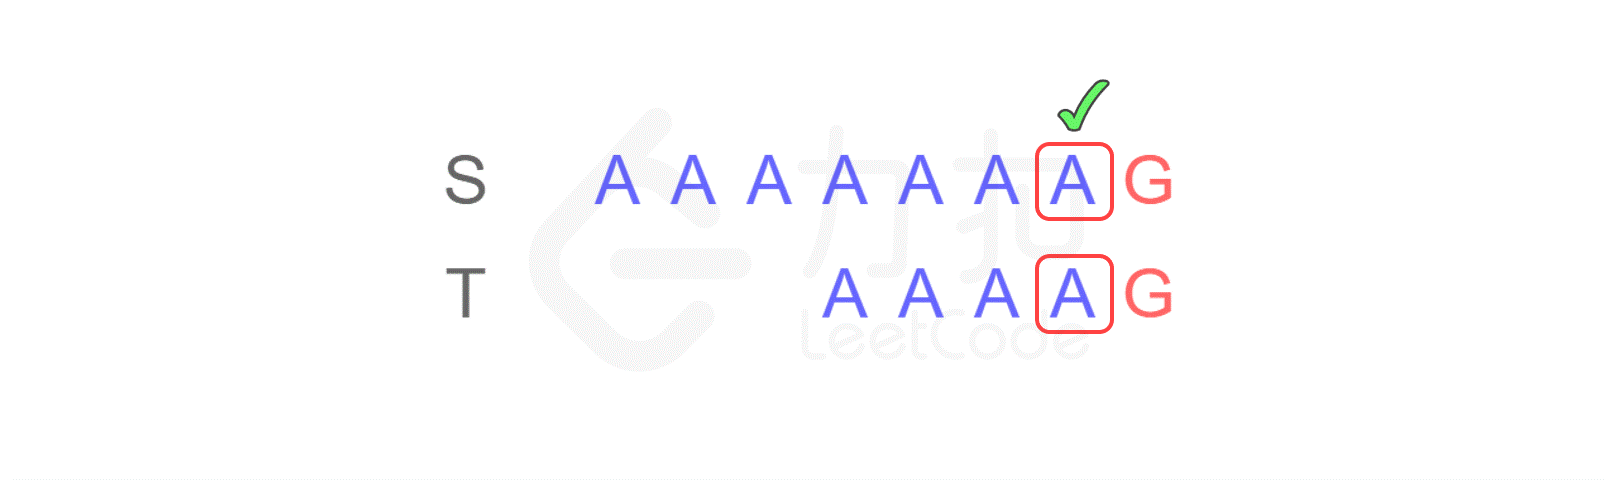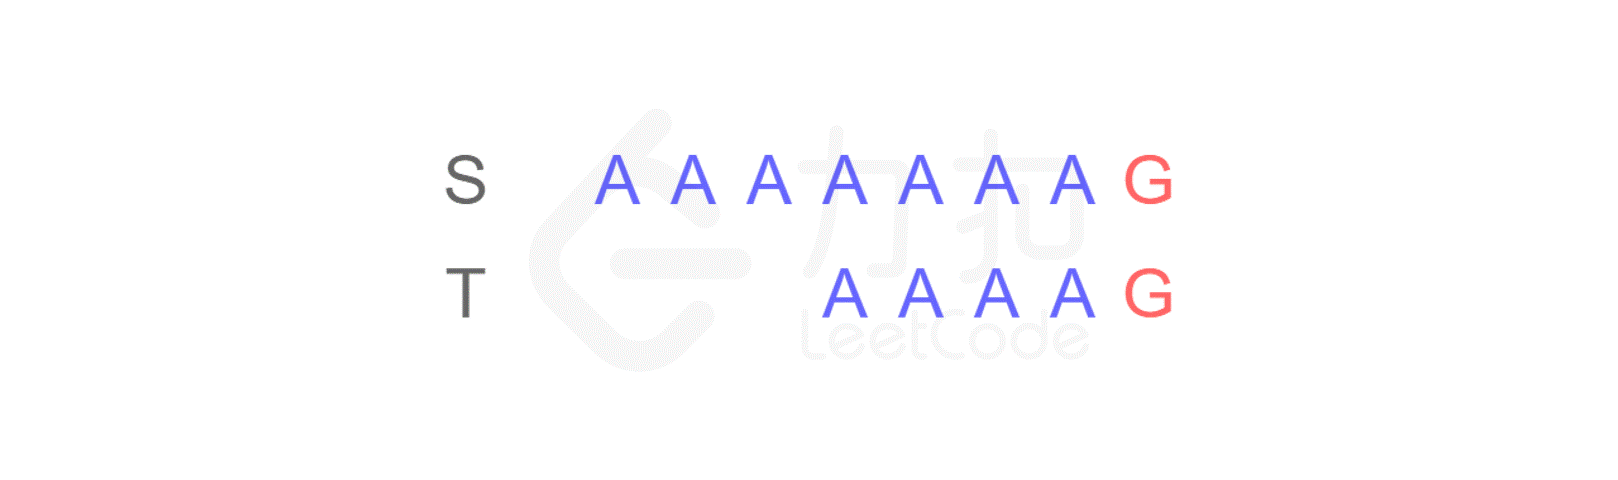
我们在进行每一轮匹配时,总是会重复对 A 进行比较。也就是说,对于 S 中的每个字符,我们都需要从 T 第一个位置重新开始比较,并且 S 前面的 A 越多,浪费的时间也就越多。假设 S 的长度为 m,T 的长度为 n,理论上讲,最坏情况下迭代 m−n+1 轮,每轮最多进行 n 次比对,一共比较了 (m−n+1)×n 次,当 m>>n 时,渐进时间复杂度为 O(mn)。
而 KMP 算法的好处在于,它可以将时间复杂度降低到 O(m+n),字符序列越长,该算法的优势越明显。它是怎么实现的呢?
情境 2
再举一个例子,现在有如下字符串 S 和 P,判断 P 是否为 S 的子串。
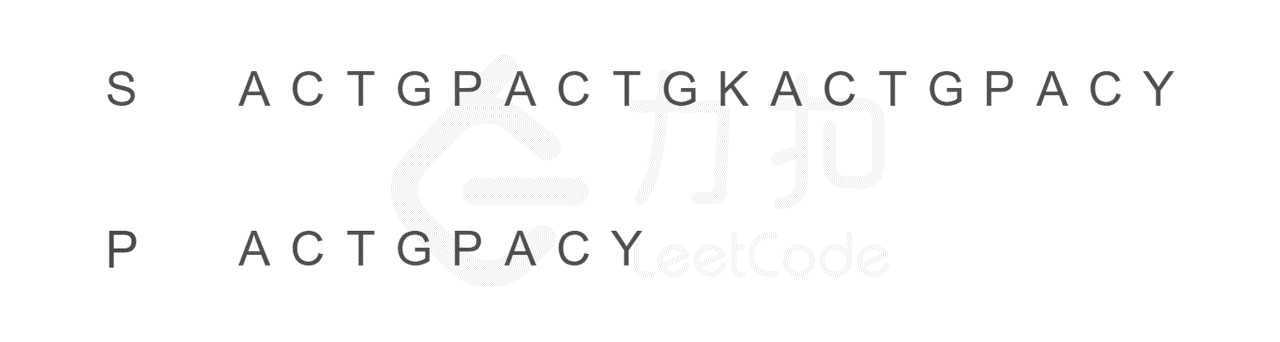
我们仍然按照原来的方式进行比较,比较到 P 的末尾时,我们发现了不匹配的字符。
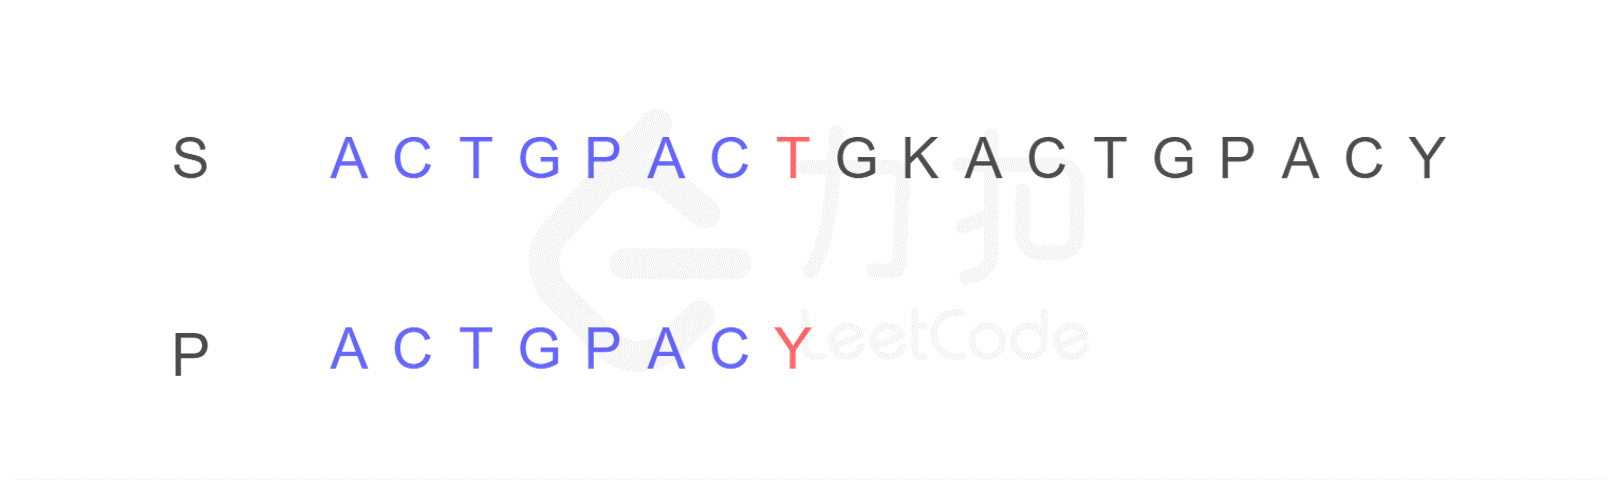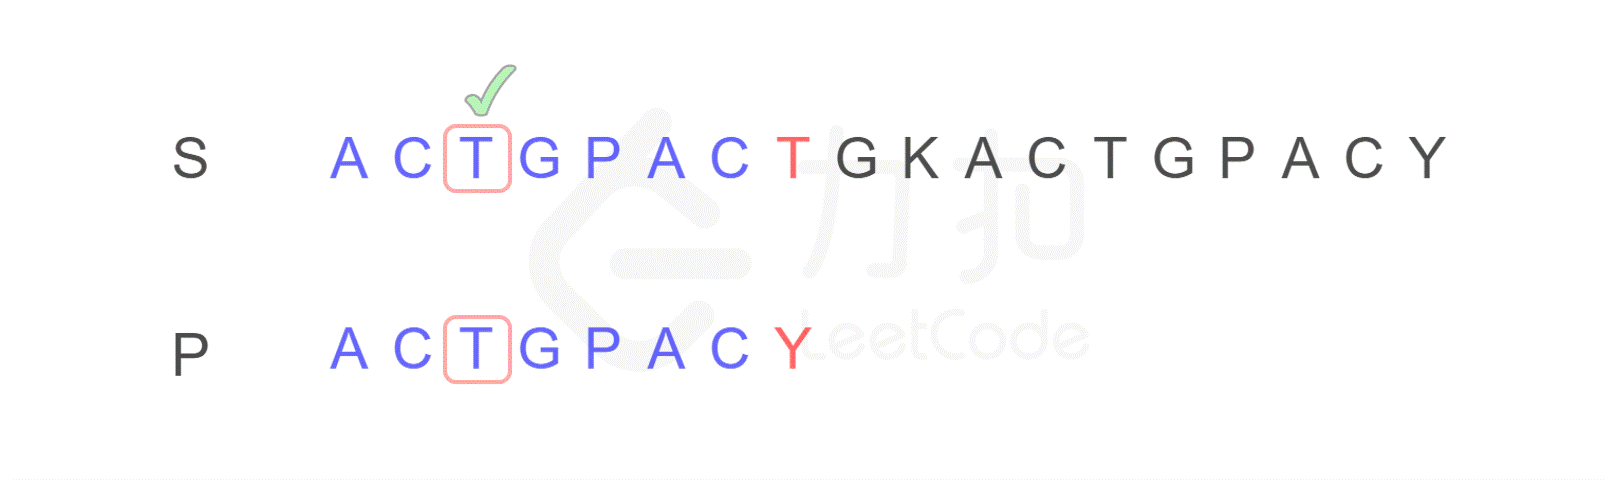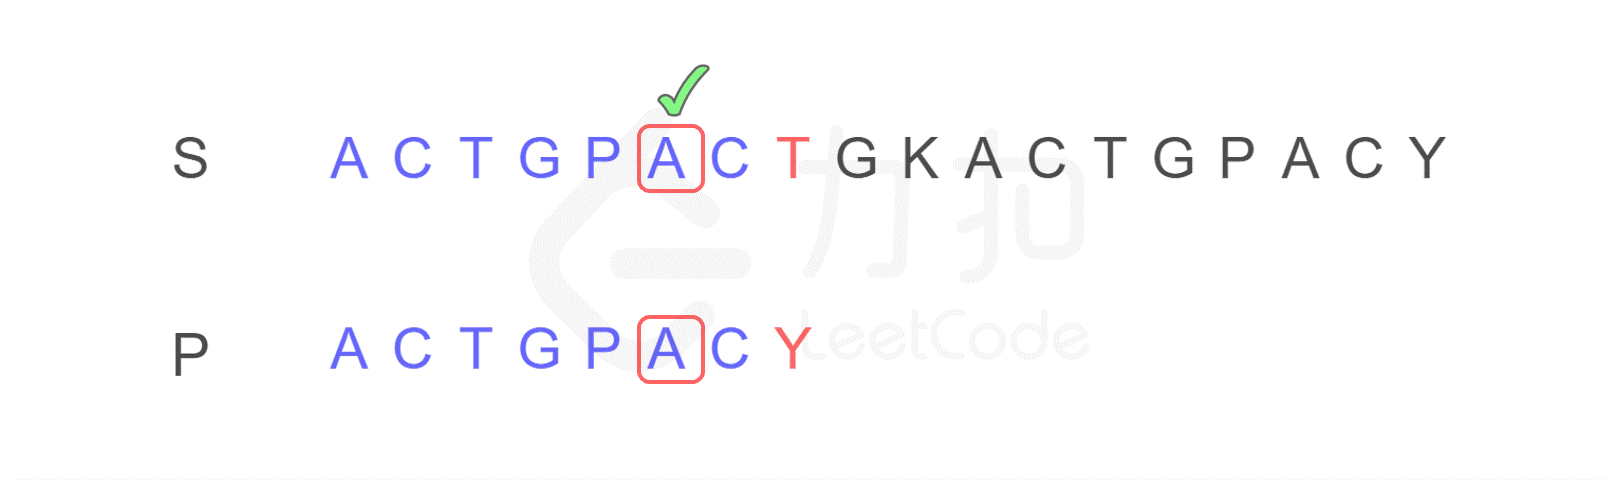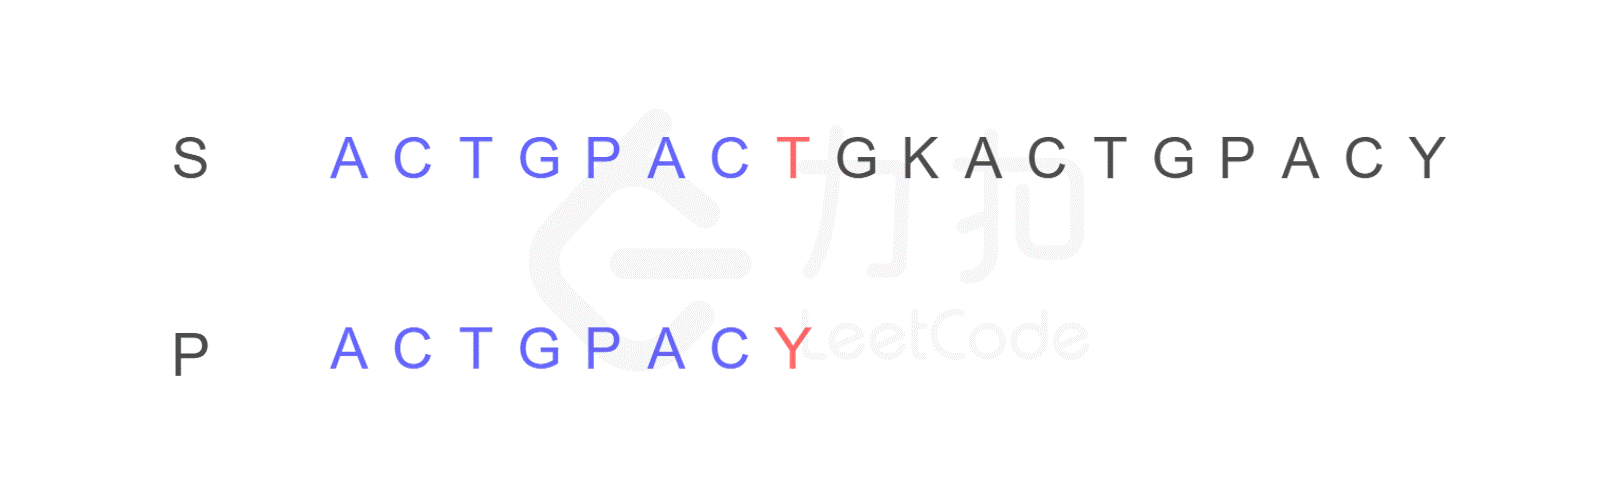
注意,按照原来的思路,我们下一步应将字符串 P 的开头,与字符串 S 的第二位 C 重新进行比较。而 KMP 算法告诉我们,我们只需将字符串 P 需要比较的位置重置到图中 j 的位置,S 保持 i 的位置不变,接下来即可从 i,j 位置继续进行比较。
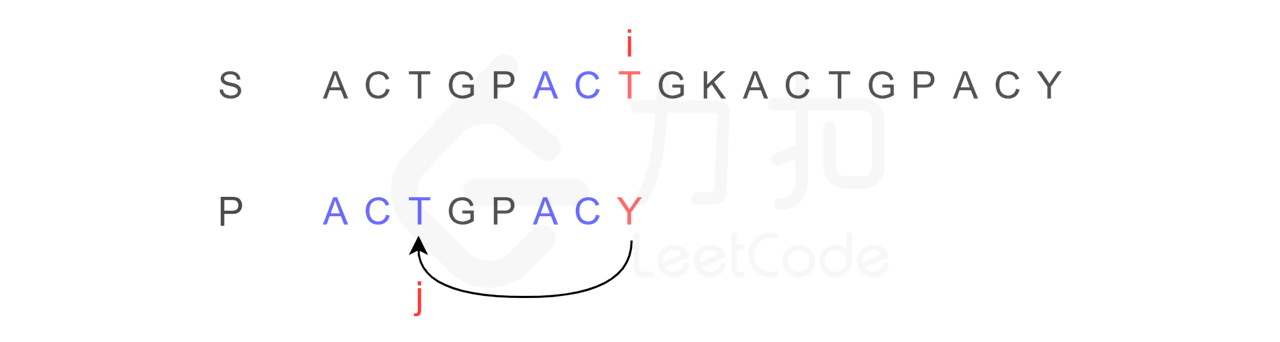
为什么?我们发现字符串 P 有子串 ACT 和 ACY,当 T 和 Y 不匹配时,我们就确定了 S 中的蓝色 AC 并不匹配 P 右侧的 AC,但是可能匹配左侧的 AC,所以我们从位置 i 和 j 继续比较。
换句话说,Y 对应下标 2,表示下一步要重新开始的地方。
既然如此,如果每次不匹配的时候,我们都能立刻知道 P 中不匹配的元素,下一步应该从哪个下标重新开始,这样不就能大大简化匹配过程了吗?这就是 KMP 的核心思想。
KMP 算法中,使用一个数组 next 来保存 P 中元素不匹配时,下一步应该重新开始的下标。由于计算机不能像我们人类一样,通过视觉来得出结论,因此这里有一种适合计算机的构造 next 数组的方法。
构造 next 数组
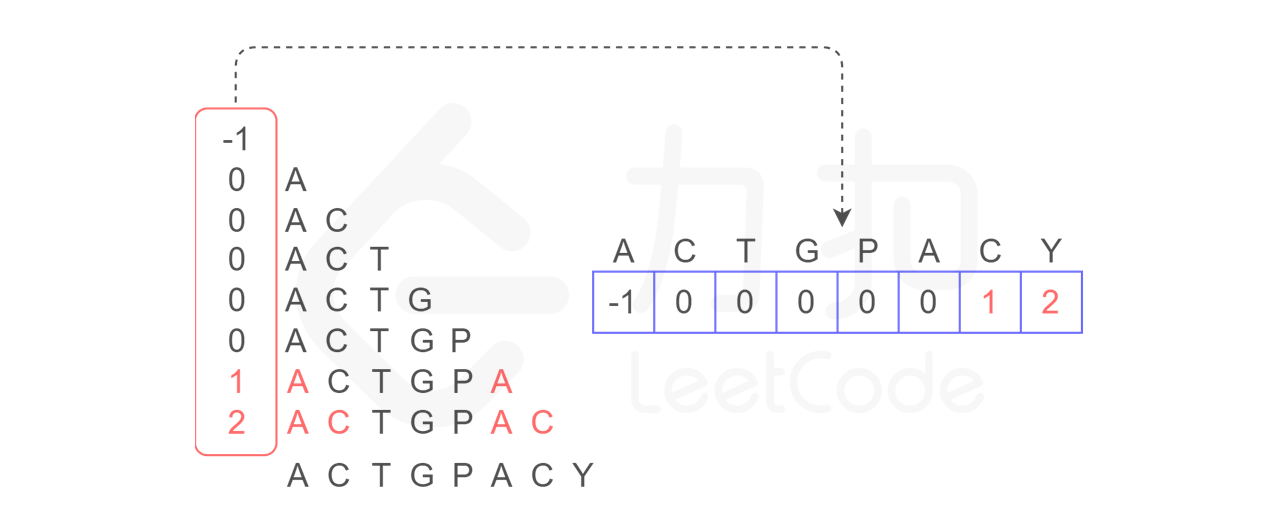
构造方法为:next[i] 对应的下标,为 P[0...i - 1] 的最长公共前缀后缀的长度,令 P[0] = -1。 具体解释如下:
例如对于字符串 abcba:
- 前缀:它的前缀包括:
a, ab, abc, abcb,不包括本身; - 后缀:它的后缀包括:
bcba, cba, ba, a,不包括本身; - 最长公共前缀后缀:
abcba的前缀和后缀中只有a是公共部分,字符串a的长度为1。
所以,我们将 P[0...i - 1] 的最长公共前后缀的长度作为 next[i] 的下标,就得到了 next 数组。
回到情境 2
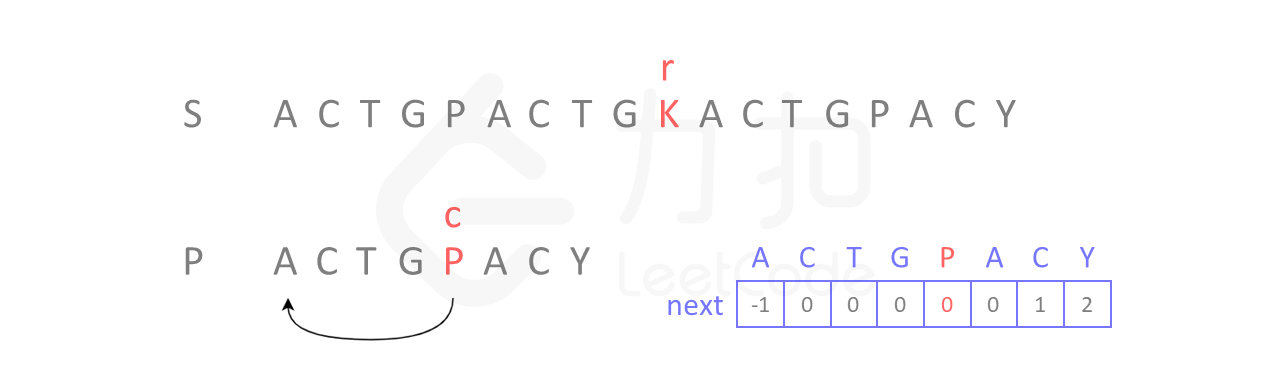
我们将思绪切换回来,上次我们还停留在位置 i 和 j,现在继续进行比较。从如下图所示,由于我们已经构造了 next 数组,当继续移动到图中的 r 和 c 位置时,发现不匹配,根据 next 数组,我们可以立即将位置 c 回到下标 0 的位置:
之后的情形就很简单了:
K与A不匹配,查看next数组,A对应next中的元素为-1,表示不动,r加1;- 位置
r字符与位置c字符匹配,继续比较下一位; - 后面元素均匹配,最终找到匹配元素。
最后给出相关代码:
 function getPMT(pat) { // 构造 next 表,查找最大公共前缀后缀长度
   // 创建一个数组并全部填充为 -1
   const next = Array(pat.length).fill(-1);
   let i = 0;
   let j = -1;
   // next[0] = -1,next[1] = 0是固定值,计算从 i = 2开始;
   while(i < pat.length) {
     if (j === -1 || pat[i] === pat[j]) {
       ++i; // 跳转下一字符
       ++j;
       next[i] = j;
     }
     else {
       j = next[j]; // 使 j = 0 或 -1(重新计算长度)
     }
   }
   return next;
 }
 // txt 为文本串,pat 为模式串
 function kmpSearch(txt, pat) {
   let i = 0; // 作为指针
   let j = 0;
   const next = getPMT(pat); // 返回 next 数组
   while (i < txt.length && j < pat.length) {
     if (j == -1 || txt[i] === pat[j]) {
       i++; // 跳转下一字符
       j++;
     }
     else {
       j = next[j]; // 重新匹配
     }
   }
   if (j === pat.length) {
     return i - j; // 返回匹配字符起始下标
   }
   return -1;
 }
LC 实现strStr()
给你两个字符串 haystack 和 needle ,请你在 haystack 字符串中找出 needle 字符串的第一个匹配项的下标(下标从 0 开始)。如果 needle 不是 haystack 的一部分,则返回 -1 。
示例 1:
 输入:haystack = "sadbutsad", needle = "sad"
 输出:0
 解释:"sad" 在下标 0 和 6 处匹配。
 第一个匹配项的下标是 0 ,所以返回 0 。
示例 2:
 输入:haystack = "leetcode", needle = "leeto"
 输出:-1
解释:"leeto" 没有在 "leetcode" 中出现,所以返回 -1 。提示:
- 1 <= haystack.length, needle.length <= 104
haystack和needle仅由小写英文字符组成
题解 (KMP 算法)
 /**
  * @param {string} haystack
  * @param {string} needle
  * @return {number}
  */
 var strStr = function(haystack, needle) {
     const n = haystack.length, m = needle.length;
     if (m === 0) {
         return 0;
     }
     const pi = new Array(m).fill(0);
     for (let i = 1, j = 0; i < m; i++) { // 判断公共最长前后缀长度
         while (j > 0 && needle[i] !== needle[j]) {
             j = pi[j - 1];
         }
         if (needle[i] == needle[j]) {
             j++;
         }
         pi[i] = j;
     }
     for (let i = 0, j = 0; i < n; i++) { // 开始匹配
         while (j > 0 && haystack[i] != needle[j]) {
             j = pi[j - 1];
         }
         if (haystack[i] == needle[j]) {
             j++;
         }
         if (j === m) {
             return i - m + 1;
         }
     }
     return -1;
 };
双指针技巧
A 双指针技巧 — 情景一
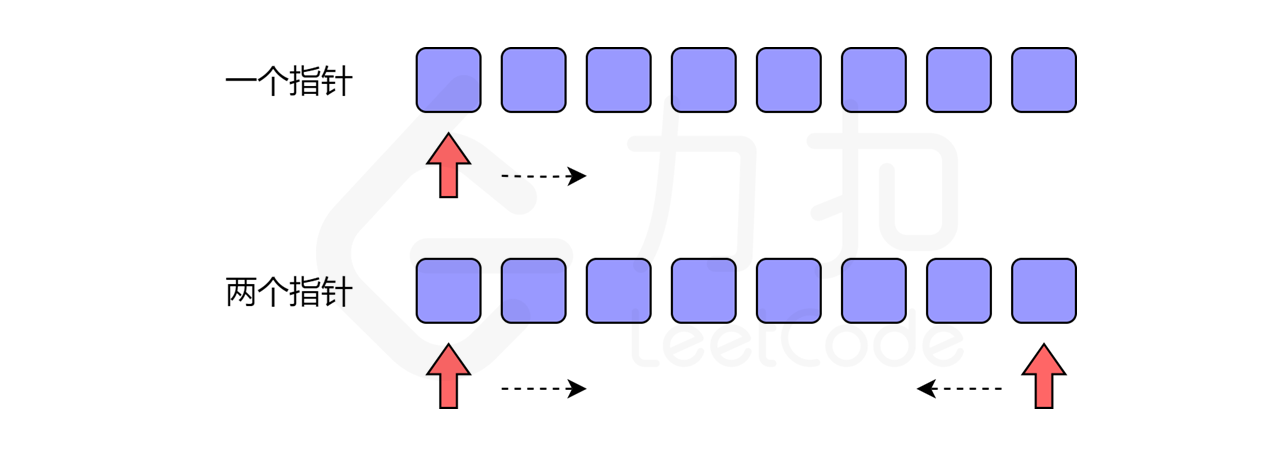
在上一章中,我们通过迭代数组来解决一些问题。通常,我们只需要一个指针进行迭代,即从数组中的第一个元素开始,最后一个元素结束。然而,有时我们会使用两个指针进行迭代。
示例
从一个经典问题开始:
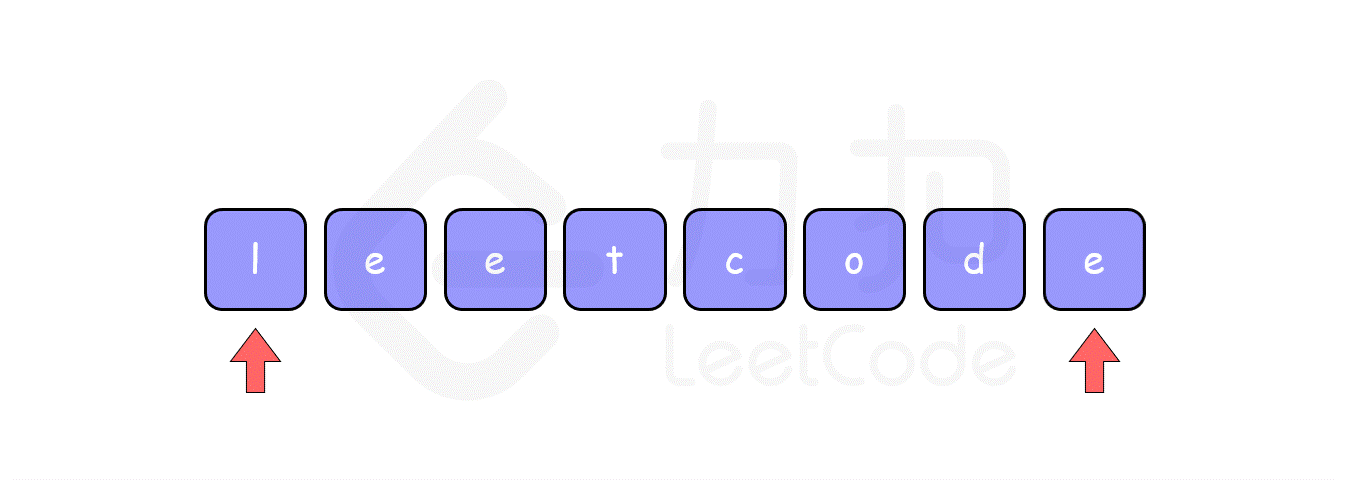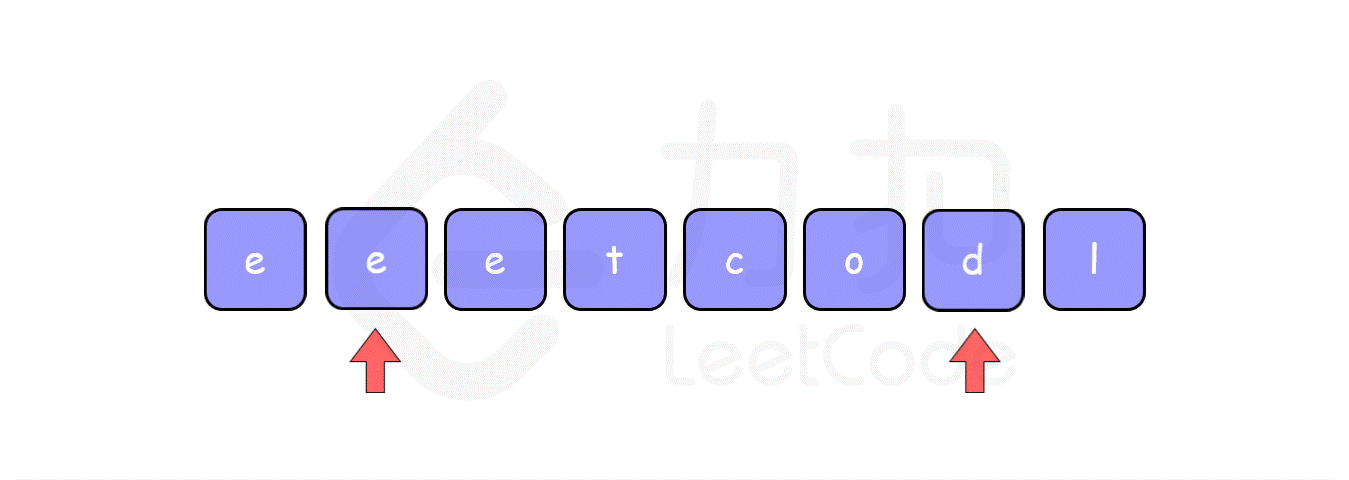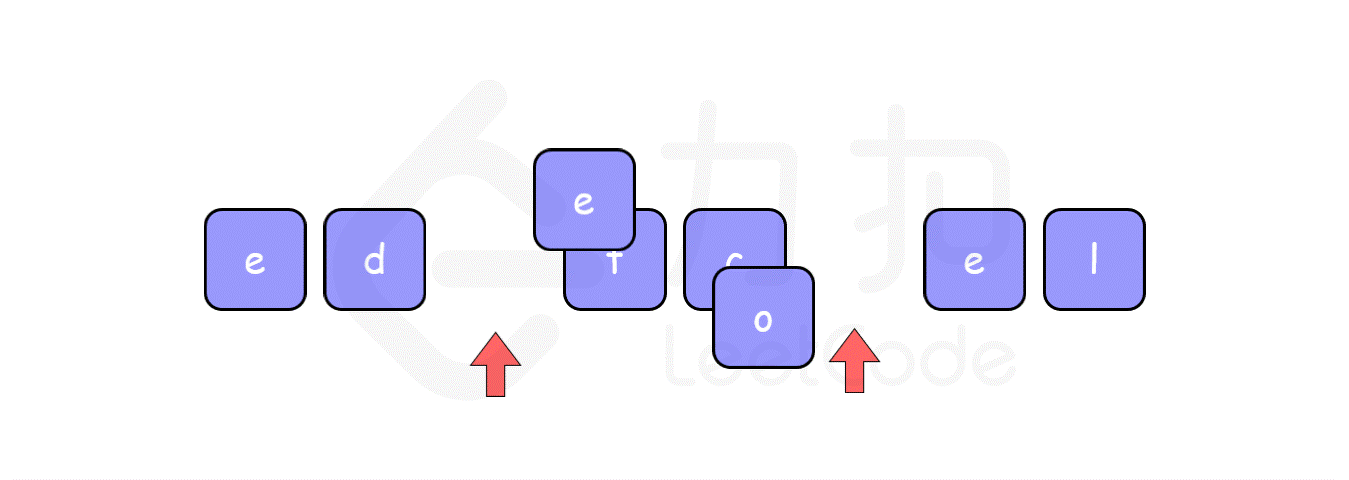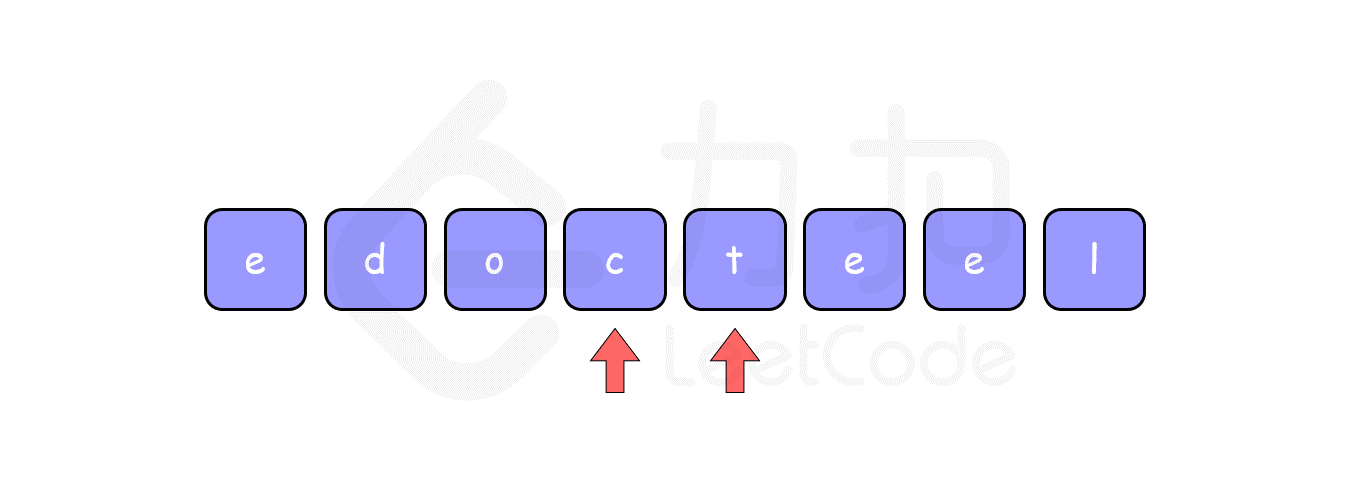
反转数组中的元素。比如数组为
['l', 'e', 'e', 't', 'c', 'o', 'd', 'e'],反转之后变为['e', 'd', 'o', 'c', 't', 'e', 'e', 'l']。
使用双指针技巧,其思想是分别将两个指针分别指向数组的开头及末尾,然后将其指向的元素进行交换,再将指针向中间移动一步,继续交换,直到这两个指针相遇。
代码参考
 def reverseString(self, s):
         i, j = 0, len(s) - 1
         while i < j:
             s[i], s[j] = s[j], s[i]
             i += 1
             j -= 1
LC 反转字符串
编写一个函数,其作用是将输入的字符串反转过来。输入字符串以字符数组 s 的形式给出。
不要给另外的数组分配额外的空间,你必须原地修改输入数组、使用 O(1) 的额外空间解决这一问题。
示例 1:
 输入:s = ["h","e","l","l","o"]
 输出:["o","l","l","e","h"]
示例 2:
 输入:s = ["H","a","n","n","a","h"]
输出:["h","a","n","n","a","H"]提示:
- 1 <= s.length <= 105
s[i]都是 ASCII 码表中的可打印字符
题解
 /**
  * @param {character[]} s
  * @return {void} Do not return anything, modify s in-place instead.
  */
 var reverseString = function(s) {
     const n = s.length;
     for (let left = 0, right = n - 1; left < right; ++left, --right) {
         [s[left], s[right]] = [s[right], s[left]];
     }
 };
LC 数组拆分 Ⅰ
给定长度为 2n 的整数数组 nums ,你的任务是将这些数分成 n 对, 例如 (a1, b1), (a2, b2), ..., (an, bn) ,使得从 1 到 n 的 min(ai, bi) 总和最大。
返回该 最大总和
示例 1:
 输入:nums = [1,4,3,2]
 输出:4
 解释:所有可能的分法(忽略元素顺序)为:
 1. (1, 4), (2, 3) -> min(1, 4) + min(2, 3) = 1 + 2 = 3
 2. (1, 3), (2, 4) -> min(1, 3) + min(2, 4) = 1 + 2 = 3
 3. (1, 2), (3, 4) -> min(1, 2) + min(3, 4) = 1 + 3 = 4
 所以最大总和为 4
示例 2:
 输入:nums = [6,2,6,5,1,2]
 输出:9
解释:最优的分法为 (2, 1), (2, 5), (6, 6). min(2, 1) + min(2, 5) + min(6, 6) = 1 + 2 + 6 = 9提示:
- 1 <= n <= 104
nums.length == 2 * n- -104 <= nums[i] <= 104
题解
 /**
  * @param {number[]} nums
  * @return {number}
  */
 var arrayPairSum = function(nums) {
     nums.sort((a, b) => a - b);
   let ans = 0;
   for (let i = 0; i < nums.length; i += 2) {
       ans += nums[i];
   }
   return ans;
 };
sort() 方法用于对数组的元素进行排序。排序顺序可以是字母或数字,并按升序或降序。默认排序顺序为按字母升序。
语法: array.sort(sortfunction) sortfunction 可选,规定排序顺序,必须是函数
例:
//数字排序(数字和升序):
var points = [40,100,1,5,25,10];
points.sort(function(a,b){return a-b});
// 输出结果:1,5,10,25,40,100
// 数字排序(数字和降序):
var points = [40,100,1,5,25,10];
points.sort(function(a,b){return b-a});
// 输出结果:100,40,25,10,5,1LC 两数之和 Ⅱ – 输入有序数组
给你一个下标从 1 开始的整数数组 numbers ,该数组已按 非递减顺序排列,请你从数组中找出满足相加之和等于目标数 target 的两个数。如果设这两个数分别是 numbers[index1] 和 numbers[index2] ,则 1 <= index1 < index2 <= numbers.length 。
以长度为 2 的整数数组 [index1, index2] 的形式返回这两个整数的下标 index1 和 index2。
你可以假设每个输入 只对应唯一的答案,而且你 不可以 重复使用相同的元素。
你所设计的解决方案必须只使用量级的额外空间。
示例 1:
 输入:numbers = [2,7,11,15], target = 9
 输出:[1,2]
 解释:2 与 7 之和等于目标数 9 。因此 index1 = 1, index2 = 2 。返回 [1, 2] 。
示例 2:
 输入:numbers = [2,3,4], target = 6
 输出:[1,3]
 解释:2 与 4 之和等于目标数 6 。因此 index1 = 1, index2 = 3 。返回 [1, 3] 。
示例 3:
 输入:numbers = [-1,0], target = -1
 输出:[1,2]
解释:-1 与 0 之和等于目标数 -1 。因此 index1 = 1, index2 = 2 。返回 [1, 2] 。提示:
- 2 <= numbers.length <= 3 * 104
-1000 <= numbers[i] <= 1000numbers按 非递减顺序 排列-1000 <= target <= 1000- 仅存在一个有效答案
题解
 /**
  * @param {number[]} numbers
  * @param {number} target
  * @return {number[]}
  */
 var twoSum = function(numbers, target) {
     let left = 0, right = numbers.length - 1;
     while (left < right) {
         if(numbers[left] + numbers[right] == target) {
             return [left + 1,right + 1];
         }
         else if(numbers[left] + numbers[right] > target) {
             right--;
         }
         else {
             left++;
         }
     }
 };
A 双指针技巧 — 情境二
有时,我们可以使用两个不同步的指针来解决问题,即快慢指针。与情景一不同的是,两个指针的运动方向是相同的,而非相反。
示例
让我们从一个经典问题开始:
给你一个数组
nums和一个值val,你需要 原地 移除所有数值等于val的元素,并返回移除后数组的新长度。
如果我们没有空间复杂度上的限制,那就更容易了。我们可以初始化一个新的数组来存储答案。如果元素不等于给定的目标值,则迭代原始数组并将元素添加到新的数组中。
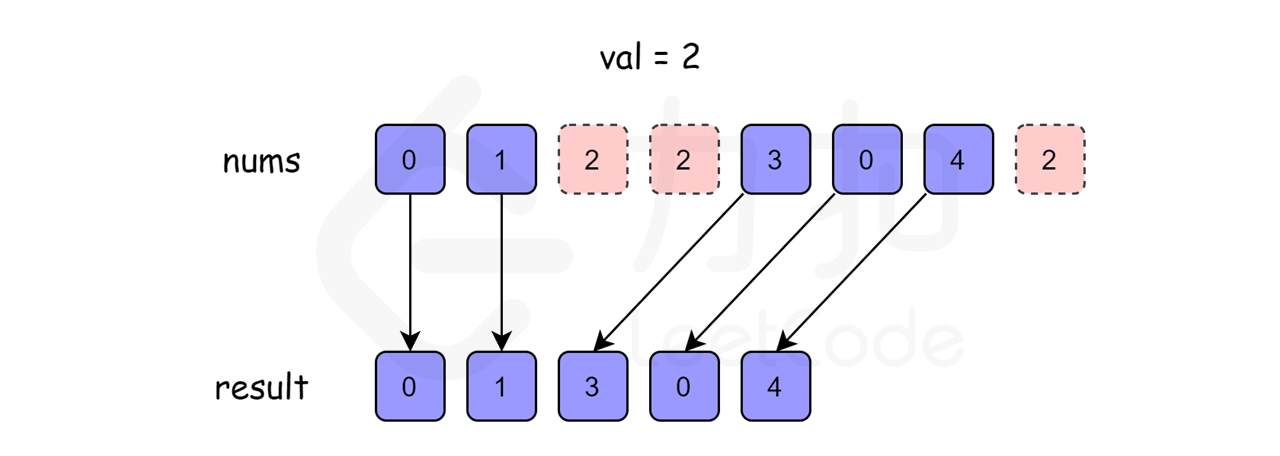
实际上,它相当于使用了两个指针,一个用于原始数组的迭代,另一个总是指向新数组的最后一个位置。
考虑空间限制
如果我们不使用额外的数组,只是在原数组上进行操作呢?
此时,我们就可以采用快慢指针的思想:初始化一个快指针 fast 和一个慢指针 slow,fast 每次移动一步,而 slow 只当 fast 指向的值不等于 val 时才移动一步。
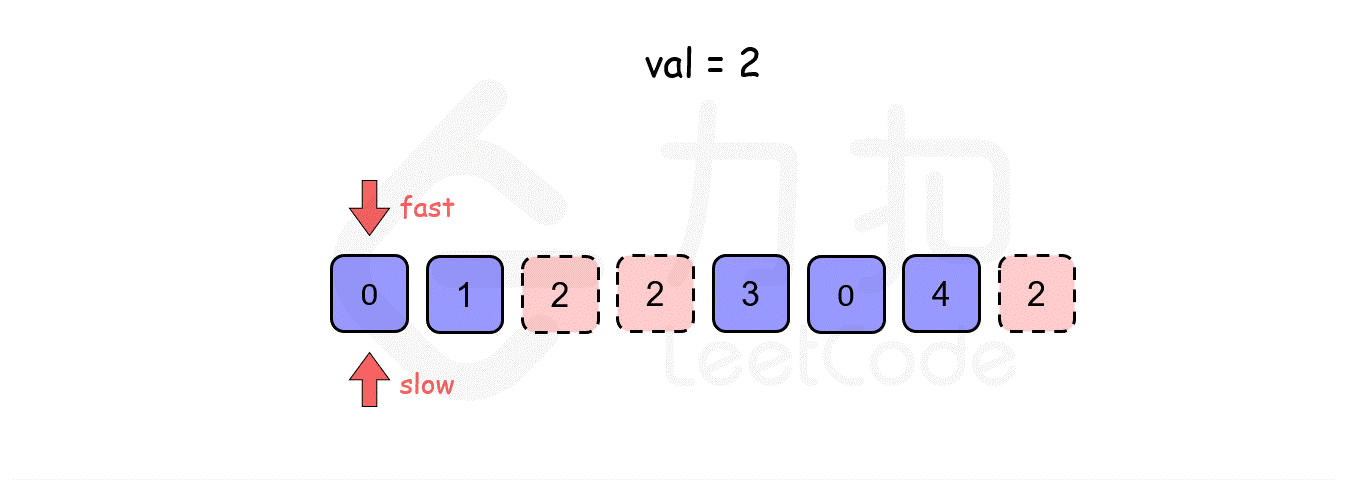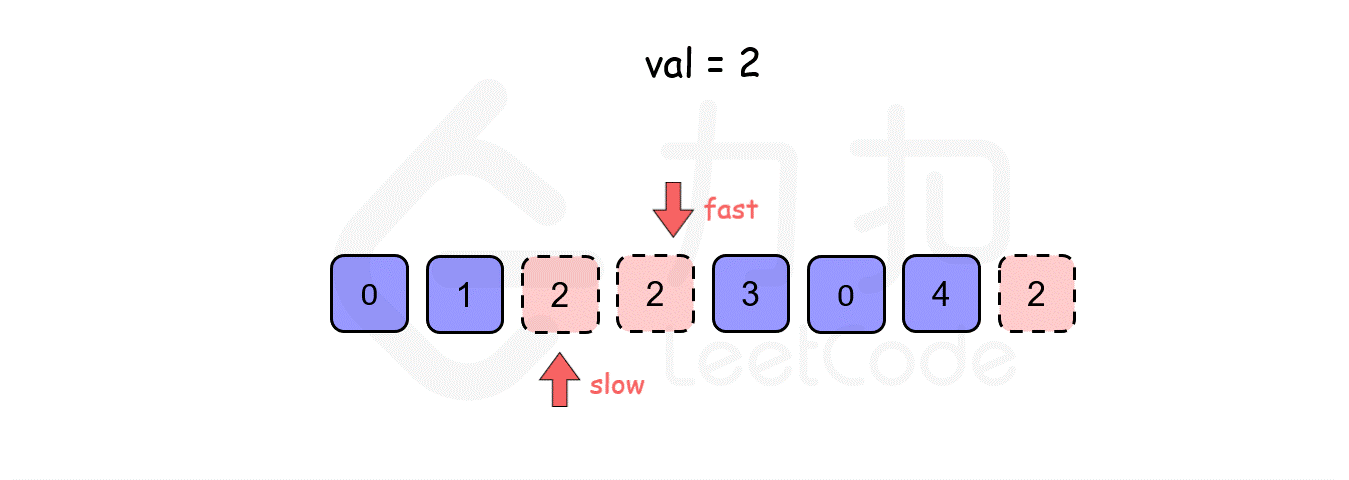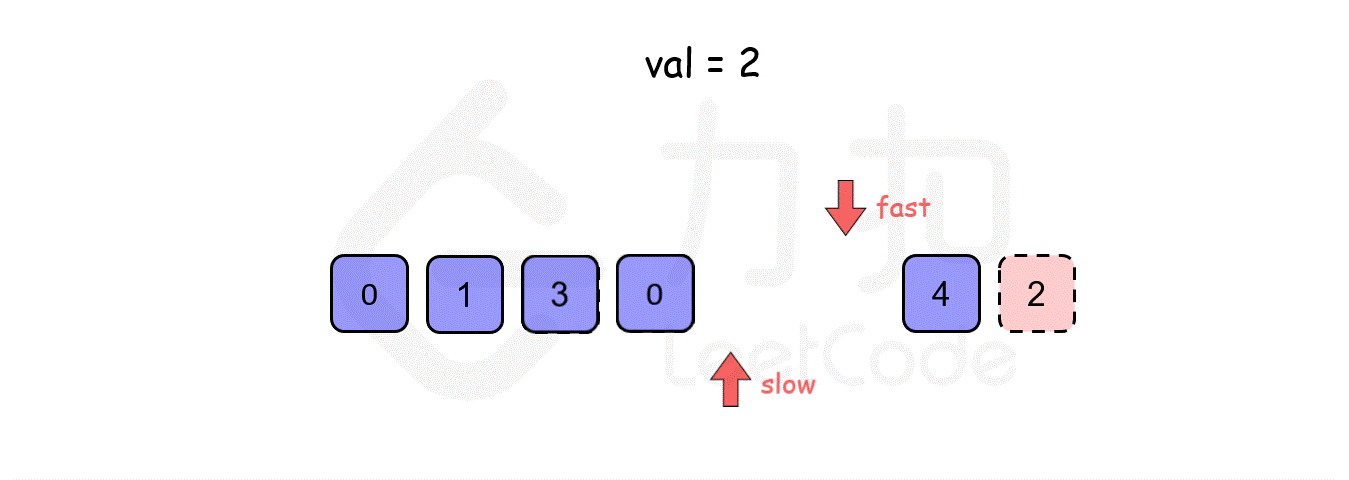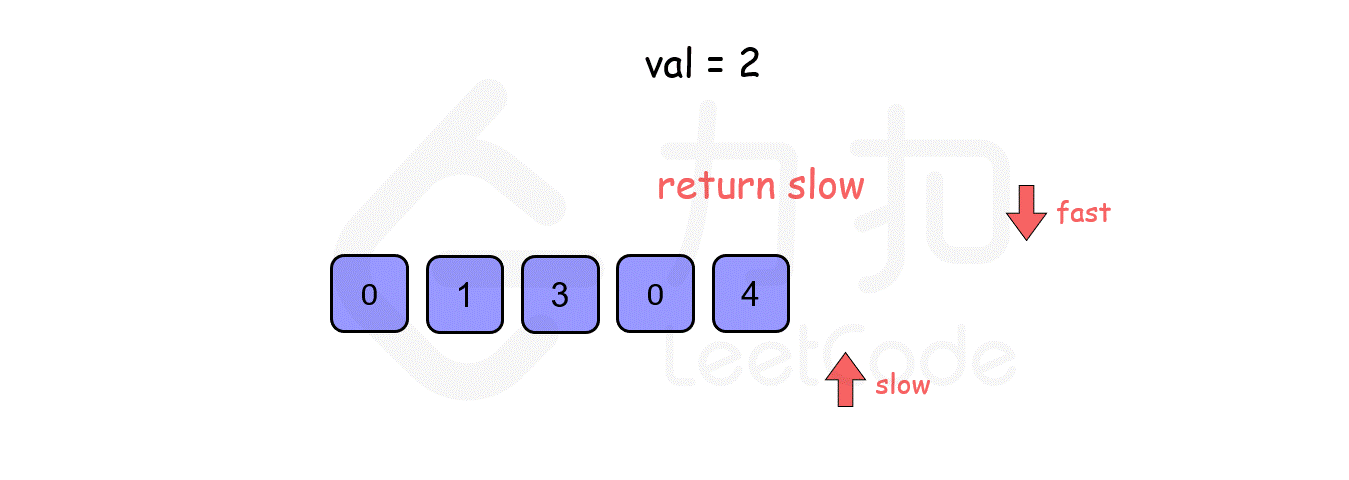
以下代码供参考:
 def removeElement(self, nums: List[int], val: int) -> int:
     slow = 0
     n = len(nums)
     for fast in range(n):
         if nums[fast] != val:
             nums[slow] = nums[fast]
             slow += 1
     return slow
小结
这是你需要使用双指针技巧的另一种非常常见的情况:
同时有一个慢指针和一个快指针
解决这类问题的关键是:
确定两个指针的移动策略
与前一个场景类似,你有时可能需要在使用双指针技巧之前对数组进行排序,也可能需要运用贪心法则来决定你的运动策略。
LC 移除元素
给你一个数组 nums 和一个值 val,你需要 原地 移除所有数值等于 val 的元素,并返回移除后数组的新长度。
不要使用额外的数组空间,你必须仅使用 O(1) 额外空间并 原地 修改输入数组。
元素的顺序可以改变。你不需要考虑数组中超出新长度后面的元素。
说明:
为什么返回数值是整数,但输出的答案是数组呢?
请注意,输入数组是以「引用」方式传递的,这意味着在函数里修改输入数组对于调用者是可见的。
你可以想象内部操作如下:
// nums 是以“引用”方式传递的。也就是说,不对实参作任何拷贝
int len = removeElement(nums, val);
// 在函数里修改输入数组对于调用者是可见的。
// 根据你的函数返回的长度, 它会打印出数组中 该长度范围内 的所有元素。
for (int i = 0; i < len; i++) {
print(nums[i]);
}示例 1:
 输入:nums = [3,2,2,3], val = 3
 输出:2, nums = [2,2]
 解释:函数应该返回新的长度 2, 并且 nums 中的前两个元素均为 2。你不需要考虑数组中超出新长度后面的元素。例如,函数返回的新长度为 2 ,而 nums = [2,2,3,3] 或 nums = [2,2,0,0],也会被视作正确答案。
示例 2:
 输入:nums = [0,1,2,2,3,0,4,2], val = 2
 输出:5, nums = [0,1,4,0,3]
解释:函数应该返回新的长度 5, 并且 nums 中的前五个元素为 0, 1, 3, 0, 4。注意这五个元素可为任意顺序。你不需要考虑数组中超出新长度后面的元素。提示:
0 <= nums.length <= 1000 <= nums[i] <= 500 <= val <= 100
题解
 /**
  * @param {number[]} nums
  * @param {number} val
  * @return {number}
  */
 var removeElement = function(nums, val) {
     let slow = 0;
     for(fast = 0; fast < nums.length; fast++) {
         if(nums[fast] != val) {
             nums[slow] = nums[fast];
             slow++;
         }
     }
     return slow;
 };
LC 最大连续 1 的个数
给定一个二进制数组 nums , 计算其中最大连续 1 的个数。
示例 1:
 输入:nums = [1,1,0,1,1,1]
 输出:3
 解释:开头的两位和最后的三位都是连续 1 ,所以最大连续 1 的个数是 3.
示例 2:
 输入:nums = [1,0,1,1,0,1]
输出:2提示:
- 1 <= nums.length <= 105
nums[i]不是0就是1.
题解
 /**
  * @param {number[]} nums
  * @return {number}
  */
 var findMaxConsecutiveOnes = function(nums) {
     var count = maxCount = 0;
     for(i = 0; i < nums.length; i++) {
         if(nums[i] === 1) {
             count++;
         }
         else {
             count = 0;
         }
         maxCount = Math.max(count,maxCount);
     }
     return maxCount;
 };
LC 长度最小的子数组
给定一个含有 n 个正整数的数组和一个正整数 target 。
找出该数组中满足 其和 ≥ target 的长度最小的 连续子数组 [numsl, numsl+1, ..., numsr-1, numsr] ,并返回其长度。如果不存在符合条件的子数组,返回 0 。
示例 1:
 输入:target = 7, nums = [2,3,1,2,4,3]
 输出:2
 解释:子数组 [4,3] 是该条件下的长度最小的子数组。
示例 2:
 输入:target = 4, nums = [1,4,4]
 输出:1
示例 3:
 输入:target = 11, nums = [1,1,1,1,1,1,1,1]
输出:0提示:
- 1 <= target <= 109
- 1 <= nums.length <= 105
- 1 <= nums[i] <= 105
进阶:
- 如果你已经实现
O(n)时间复杂度的解法, 请尝试设计一个O(n log(n))时间复杂度的解法。
题解
暴力法
初始化子数组的最小长度为无穷大,枚举数组 nums 中的每个下标作为子数组的开始下标,对于每个开始下标 i,需要找到大于或等于 i 的最小下标 j,使得从 nums[i] 到 nums[j] 的元素和大于或等于 s,并更新子数组的最小长度(此时子数组的长度是 j−i+1)。
 /**
  * @param {number} target
  * @param {number[]} nums
  * @return {number}
  */
 var minSubArrayLen = function(target, nums) {
     let n = nums.length;
   if(n == 0) {
     return 0;
   }
   let ans = Number.MAX_SAFE_INTEGER; // 最大安全整数
   for(let i = 0; i < n; i++) {
     let sum = 0;
     for(let j = i; j < n; j++) {
       sum += nums[j];
       if (sum >= target) {
         ans = Math.min(ans, j - i + 1);
         break;
       }
     }
   }
   return ans == Number.MAX_SAFE_INTEGER ? 0 : ans;
 };
复杂度分析
- 时间复杂度:O(n2),其中
n是数组的长度。需要遍历每个下标作为子数组的开始下标,对于每个开始下标,需要遍历其后面的下标得到长度最小的子数组。 - 空间复杂度:O(1)。
滑动窗口
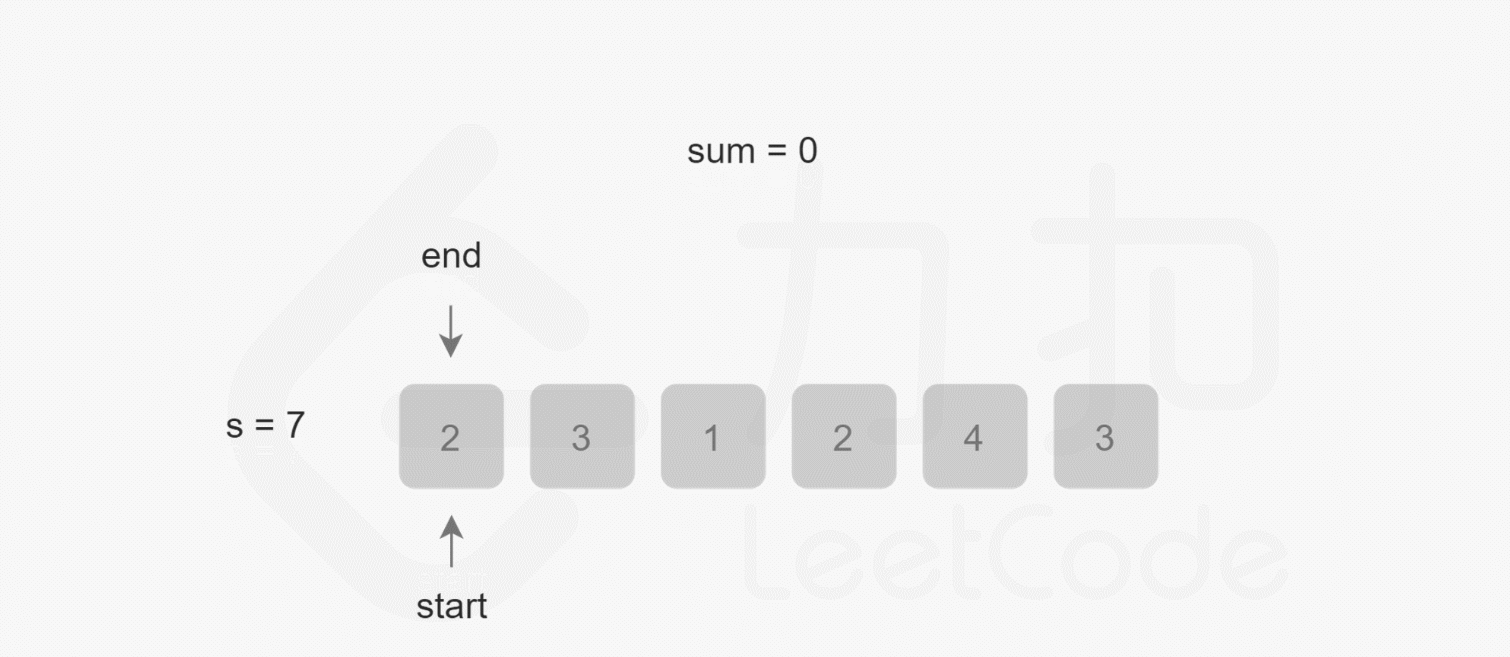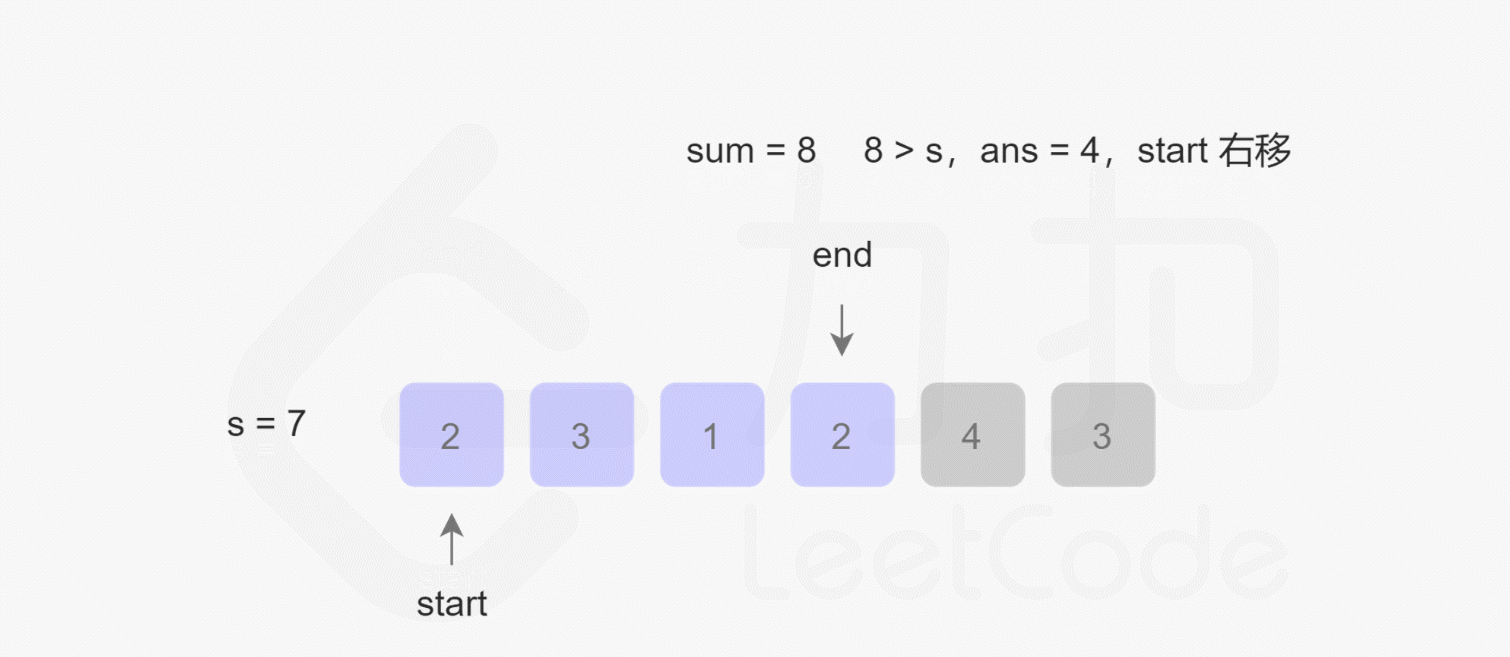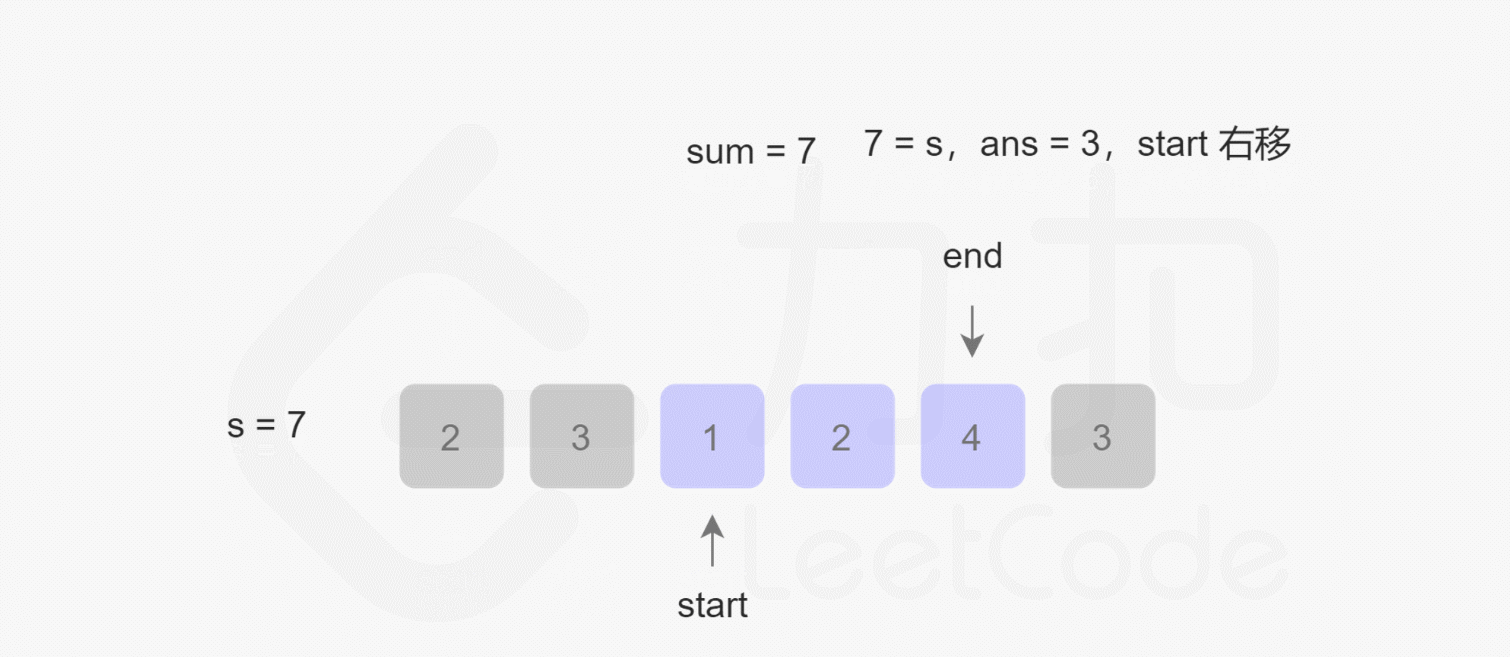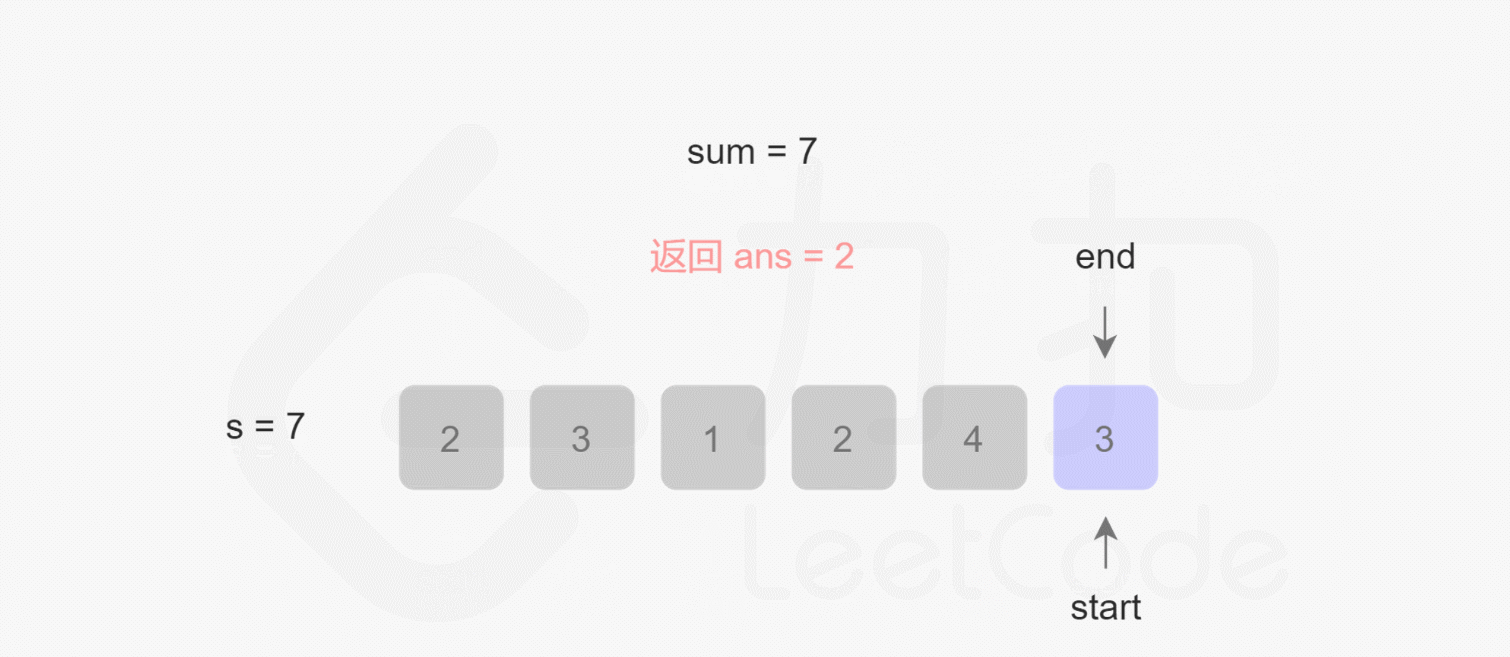
定义了两个指针 start 和 end 分别表示子数组(滑动窗口的窗口)的开始位置和结束位置,维护变量 sum 存储子数组中的元素和(即从 nums[start] 到 nums[end] 的元素和)
初始状态下,start 和 end 都指向下标 0,sum 的值为 0。
每一轮迭代,将 nums[end] 加到 sum,如果 sum≥s,则更新子数组的最小长度(此时子数组的长度是 end−start+1),然后将 nums[start] 从 sum 中减去并将 start 右移,直到 sum<s,在此过程中同样更新子数组的最小长度。在每一轮迭代的最后,将 end 右移。
 /**
  * @param {number} target
  * @param {number[]} nums
  * @return {number}
  */
 var minSubArrayLen = function(target, nums) {
     let n = nums.length;
   if(n == 0) {
     return 0;
   }
   let ans = Number.MAX_SAFE_INTEGER;
   let start = 0, end = 0;
   for(let i = 0; i < n; i++) {
     let sum = 0;
     while (end < n) {
       sum += nums[end];
       while (sum >= target) {
         ans = Math.min(ans, end - start + 1);
         sum -= nums[start];
         start++;
       }
       end++;
     }
   }
   return ans == Number.MAX_SAFE_INTEGER ? 0 : ans;
 };
复杂度分析
- 时间复杂度:
O(n),其中n是数组的长度。指针start和end最多各移动n次。 - 空间复杂度:
O(1)。
小结 / 练习
A 数组相关的技术
- 这里有一些其他类似于数组的数据结构,但具有一些不同的属性:
- 正如我们所提到的,我们可以调用内置函数来对数组进行排序。但是,理解一些广泛使用的排序算法的原理及其复杂度是很有用的。
- 二分查找也是一种重要的技术,用于在排序数组中搜索特定的元素。
- 我们在这一章中引入了双指针技巧。想要灵活运用该技巧是不容易的。这一技巧也可以用来解决:
- 链表中的慢指针和快指针问题
- 滑动窗口问题
- 双指针技巧有时与贪心算法有关,它可以帮助我们设计指针的移动策略。
LC 杨辉三角
给定一个非负整数 numRows,生成「杨辉三角」的前 numRows 行。
在「杨辉三角」中,每个数是它左上方和右上方的数的和。
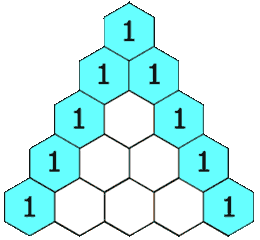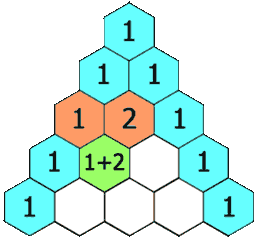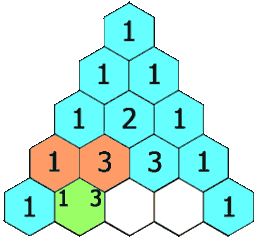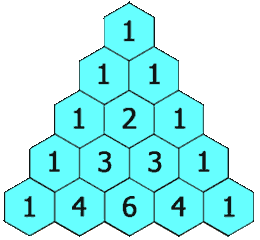
示例 1:
 输入: numRows = 5
 输出: [[1],[1,1],[1,2,1],[1,3,3,1],[1,4,6,4,1]]
示例 2:
 输入: numRows = 1
输出: [[1]]提示:
1 <= numRows <= 30
题解
/**
* @param {number} numRows
* @return {number[][]}
*/
var generate = function (numRows) {
const ret = [];
for (let i = 0; i < numRows; i++) {
const row = new Array(i + 1).fill(1);
for (let j = 1; j < row.length - 1; j++) {
row[j] = ret[i - 1][j - 1] + ret[i - 1][j];
}
ret.push(row);
}
return ret;
};复杂度分析
- 时间复杂度:O(numRows2)。
- 空间复杂度:O(1)。不考虑返回值的空间占用.
LC 杨辉三角 Ⅱ
给定一个非负索引 rowIndex,返回「杨辉三角」的第 rowIndex 行。
在「杨辉三角」中,每个数是它左上方和右上方的数的和。
示例 1:
 输入: rowIndex = 3
 输出: [1,3,3,1]
示例 2:
 输入: rowIndex = 0
 输出: [1]
示例 3:
 输入: rowIndex = 1
输出: [1,1]提示:
0 <= rowIndex <= 33
题解
 /**
  * @param {number} rowIndex
  * @return {number[]}
  */
 // 把某一行拷贝一份,整体右移一位,相加可以得到下一行
 var getRow = function (rowIndex) {
     if (rowIndex < 0) return [];
     const arr = [1];
     for (let i = 1; i <= rowIndex; i++) {
         let originPreVal = 0;
         for (let j = 0; j < i + 1; j++) {
             /*
             为了节省空间,直接复用同一个数组,
             计算新行的 arr[j] = arr[j - 1] + arr[j]
             当计算下一位的时候, arr[j-1] 在上一轮就被污染了
             所以用个临时变量保存某一轮计算的 arr[j]
             */
             const tmp = arr[j] || 0; // 若数组为空则赋值 0
             arr[j] = originPreVal + tmp;
             originPreVal = tmp;
         }
     }
     return arr;
 };
LC 反转字符串中的单词 III
给定一个字符串 s ,你需要反转字符串中每个单词的字符顺序,同时仍保留空格和单词的初始顺序。
示例 1:
 输入:s = "Let's take LeetCode contest"
 输出:"s'teL ekat edoCteeL tsetnoc"
示例 2:
 输入: s = "God Ding"
输出:"doG gniD"提示:
- 1 <= s.length <= 5 * 104
s包含可打印的 ASCII 字符。s不包含任何开头或结尾空格。s里 至少 有一个词。s中的所有单词都用一个空格隔开。
题解
 /**
  * @param {string} s
  * @return {string}
  */
 var reverseWords = function (s) {
     const ret = [];
     const length = s.length;
     let i = 0;
     while (i < length) {
         let start = i; // 单词起始位置
         while (i < length && s.charAt(i) != ' ') { // 查看单词长度
             i++;
         }
         for (let p = start; p < i; p++) { // 从单词后往前移动
             ret.push(s.charAt(start + i - 1 - p));
         }
         while (i < length && s.charAt(i) == ' ') {
             i++;
             ret.push(' ');
         }
     }
     return ret.join(''); // 数组转字符串
 };
charAt() 方法可返回指定位置的字符。
请注意,JavaScript 并没有一种有别于字符串类型的字符数据类型,所以返回的字符是长度为 1 的字符串。
语法:stringObject.charAt(index)
index:必须。表示字符串中某个位置的数字。
复杂度分析
- 时间复杂度:O(N),其中 N 为字符串的长度。原字符串中的每个字符都会在 O(1) 的时间内放入新字符串中。
- 空间复杂度:O(N),我们开辟了与原字符串等大的空间。
LC 寻找旋转排序数组中的最小值
已知一个长度为 n 的数组,预先按照升序排列,经由 1 到 n 次 旋转 后,得到输入数组。例如,原数组 nums = [0,1,2,4,5,6,7] 在变化后可能得到:
- 若旋转
4次,则可以得到[4,5,6,7,0,1,2] - 若旋转
7次,则可以得到[0,1,2,4,5,6,7]
注意:向右旋转即将数组中的元素向右移动 k 个位置,其中 k 是非负数。
例:
 输入: [1,2,3,4,5,6,7] 和 k = 3
 输出: [5,6,7,1,2,3,4]
 解释:
 向右旋转 1 步: [7,1,2,3,4,5,6]
 向右旋转 2 步: [6,7,1,2,3,4,5]
 向右旋转 3 步: [5,6,7,1,2,3,4]
给你一个元素值 互不相同 的数组 nums ,它原来是一个升序排列的数组,并按上述情形进行了多次旋转。请你找出并返回数组中的 最小元素 。
你必须设计一个时间复杂度为 O(log n) 的算法解决此问题。
示例 1:
 输入:nums = [3,4,5,1,2]
 输出:1
 解释:原数组为 [1,2,3,4,5] ,旋转 3 次得到输入数组。
示例 2:
 输入:nums = [4,5,6,7,0,1,2]
 输出:0
 解释:原数组为 [0,1,2,4,5,6,7] ,旋转 4 次得到输入数组。
示例 3:
 输入:nums = [11,13,15,17]
 输出:11
解释:原数组为 [11,13,15,17] ,旋转 4 次得到输入数组。提示:
n == nums.length1 <= n <= 5000-5000 <= nums[i] <= 5000nums中的所有整数 互不相同nums原来是一个升序排序的数组,并进行了1至n次旋转
题解
 /**
  * @param {number[]} nums
  * @return {number}
  */
 // 使用二分法
 var findMin = function (nums) {
     var left = 0;
     var right = nums.length - 1;
     while (left < right) {
         var mid = (left + right) >> 1;
         if (nums[mid] > nums[right]) {
             left = mid + 1;
         } else {
             right = mid;
         }
     }
     return nums[left];
 };
复杂度分析
时间复杂度:O(logN)。
空间复杂度:O(1)。
LC 删除排序数组中的重复项
给你一个 升序排列 的数组 nums ,请你 原地 删除重复出现的元素,使每个元素 只出现一次 ,返回删除后数组的新长度。元素的 相对顺序 应该保持 一致 。
由于在某些语言中不能改变数组的长度,所以必须将结果放在数组 nums 的第一部分。更规范地说,如果在删除重复项之后有 k 个元素,那么 nums 的前 k 个元素应该保存最终结果。
将最终结果插入 nums 的前 k 个位置后返回 k 。
不要使用额外的空间,你必须在 原地 修改输入数组 并在使用 O(1) 额外空间的条件下完成。
示例 1:
 输入:nums = [1,1,2]
 输出:2, nums = [1,2,_]
 解释:函数应该返回新的长度 2 ,并且原数组 nums 的前两个元素被修改为 1, 2 。不需要考虑数组中超出新长度后面的元素。
示例 2:
 输入:nums = [0,0,1,1,1,2,2,3,3,4]
 输出:5, nums = [0,1,2,3,4]
解释:函数应该返回新的长度 5 , 并且原数组 nums 的前五个元素被修改为 0, 1, 2, 3, 4 。不需要考虑数组中超出新长度后面的元素。提示:
- 1 <= nums.length <= 3 * 104
- -104 <= nums[i] <= 104
nums已按 升序 排列
题解
 /**
  * @param {number[]} nums
  * @return {number}
  */
 var removeDuplicates = function(nums) {
     if(nums == null || nums.length == 0) {
         return 0;
     }
     let left = 0, right = 1;
     while (right < nums.length) {
         if (nums[left] != nums[right]) {
             nums[left+1] = nums[right];
             left++;
         }
         right++;
     }
     return left+1;
 };
LC 移动零
给定一个数组 nums,编写一个函数将所有 0 移动到数组的末尾,同时保持非零元素的相对顺序。
请注意 ,必须在不复制数组的情况下原地对数组进行操作。
示例 1:
 输入: nums = [0,1,0,3,12]
 输出: [1,3,12,0,0]
示例 2:
 输入: nums = [0]
输出: [0]提示:
- 1 <= nums.length <= 104
- -231 <= nums[i] <= 231 – 1
题解
 /**
  * @param {number[]} nums
  * @return {void} Do not return anything, modify nums in-place instead.
  */
 var moveZeroes = function(nums) {
     if (nums.length == 0) {
         return ;
     }
     let left = 0, right = 0;
     while(right < nums.length) {
         if(nums[right] != 0) {
             let t = nums[left];
             nums[left] = nums[right];
             nums[right] = t;
             left++;
         }
         right++;
     }
 };
复杂度分析
时间复杂度:O(n)。
空间复杂度:O(1)。
小结
至此 数组和字符串 内容就完成了,如果有不懂的地方,可以点击算法题目(LC)标题,跳转到力扣练习,本文章只是便于查询和反复记忆用。
